开篇:那半秒的等待,工程上叫 TTFT
用过大模型对话产品的人都有体感:点下发送,光标闪半天才蹦出第一个字。这段“等待”在工程上有个专门的指标——TTFT(Time To First Token,首字延迟)。它不像吞吐那样体现在报表里,却直接决定用户觉得这个产品“快不快”。
很多人一提优化就想到“换更强的卡”,但 TTFT 的账其实要这么算:
TTFT = Prefill 计算时间 + KV Cache 传输时间 + 等待排队时间
三项里,只有第一项跟算力强弱直接相关。所以优化 TTFT 的根本逻辑不是“单点极致”,而是系统性的削峰填谷:让算力最强的节点最快算出结果,让最快的网络最快把数据传出去,让调度器决定何时算、传到哪里。
下面把业界常用的手段按这个思路拆成六个方向,顺序是“先砍排队、再省计算、后压算力”。
先看一张全链路图,如下所示:
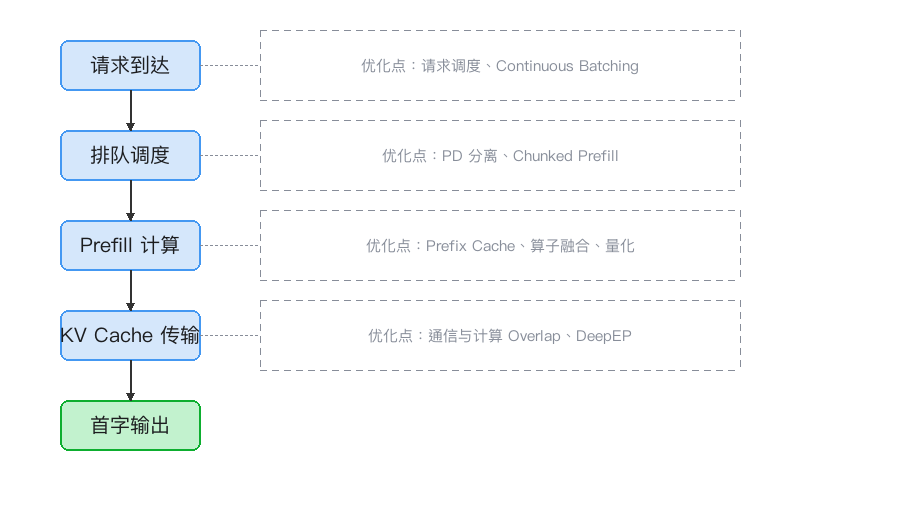
图:TTFT 三段耗时与对应优化手段一览
一、架构与调度:先把“排队”这一项砍掉
排队时间往往是长尾延迟的最大贡献者,而它几乎不花额外算力就能优化。
- PD 分离(Prefill/Decode 分离):把 Prefill 计算卸载到专用节点,不再和 Decode 阶段抢算力,从架构层面消除资源冲突造成的 TTFT 长尾。
- Chunked Prefill(分块预填充):把长 Prompt 的 Prefill 切成若干小块,穿插在 Decode 迭代之间执行,避免一个长文本请求“独占”GPU、把别人的 TTFT 全部拖超时。
- Continuous Batching(持续批处理):新请求可以在迭代间隙动态插入当前批次,不必等整个 Batch 跑完,排队等待时间大幅下降。
- 请求调度:对 Prefill 任务做优先级或短作业优先,让短请求先走,不被少数超长 Prompt 拉高平均值。
二、KV Cache 存储与复用:能不算的就别算
- Prefix Cache(前缀缓存):把历史对话、公共系统提示词对应的 KV Cache 存下来,新请求命中前缀就直接复用,这部分 Prefill 计算彻底免掉。这是降 TTFT 性价比最高的一招。
- PagedAttention:分页管理 KV Cache,提升显存利用率,减少显存碎片导致的换入换出,间接让 Prefill 速度更稳定。
- KV Cache 本身的管理:它是 Prefill 的核心产出物,存得高效,才谈得上快速传给 Decode 节点。
三、通信传输:让传输时间“消失”在计算里
- 通信与计算 Overlap:Prefill 边算边以流水线方式异步传输已算好的 KV Cache,传输耗时被计算过程隐藏,端到端 TTFT 直接下降。
- 集合通信优化(AllReduce / AllGather / 拓扑感知):针对 TP、PP 这类分布式 Prefill,降低多卡同步的传输延迟。
- DeepEP 优化:面向 MoE 架构的专家并行通信优化,减少 Prefill 阶段跨节点路由与数据搬运的开销。
四、并行策略与资源分配:把计算摊开
- TP 张量并行 / PP 流水线并行 / CP 上下文并行:把矩阵乘法或长序列切分到多卡并行,压缩单卡计算耗时。
- 资源管理(动态扩缩容 / 配比调整):按实时负载增减 Prefill 节点,或调整 Prefill 与 Decode 的节点配比(如 1:3),避免算力不足重新变成排队积压。
并行度不是越高越好:切分带来的通信开销会反噬收益,需要按模型规模与互联带宽实测权衡。
五、模型与算子加速:压榨单卡算力
- 高性能算子与算子融合:FlashAttention、Fused MHA 等融合算子减少 Kernel 启动和显存读写次数,直接加速 Attention 计算。
- 模型量化:权重或 KV Cache 转成 INT8 / FP8,同时降低计算量和显存带宽压力。
- 模型稀疏:借助 MoE 或权重稀疏,Prefill 阶段只激活部分参数。
六、高阶辅助手段:拿间接收益
- 投机采样 / MTP(Medusa 等):主战场在 Decode,但结合 Lookahead 解码后,可以通过提前生成草稿 Token 辅助调整 Prefill 策略、减少后续重算。
- 模型蒸馏:蒸出更轻量的“Prefill 专用”小模型处理简单请求,缩短极端场景下的首字耗时。
七、六大方向一图总结
① 架构调度:PD 分离、Chunked Prefill、Continuous Batching
② 缓存复用:Prefix Cache、PagedAttention
③ 通信传输:计算通信 Overlap、DeepEP
④ 并行策略:TP / PP / CP、资源动态配比
⑤ 算子加速:算子融合、量化、稀疏
⑥ 高阶手段:投机采样 / MTP、模型蒸馏
八、一张表记住整个体系
| 优化层次 | 关键手段 |
|---|---|
| 并行策略 | TP 张量并行、DP 数据并行、EP 专家并行、PP 流水线并行、CP 上下文并行 |
| 模型框架 | Continuous Batching、Chunked Prefill、Prefill/Decode 分离、KV Cache、PagedAttention、Prefix Cache、投机采样 / MTP |
| 模型算子 | 算子融合、高性能算子、Attention 与 FFN 融合 |
| 推理系统 | 请求调度、资源管理、指标体系(TTFT、TPOT、Tokens/s、QPS)、PD 分离 |
| 通信优化 | 通信与计算 Overlap、DeepEP 优化、AllReduce / AllGather |
| 模型权重 | 模型量化、模型蒸馏、模型稀疏 |
九、结语:三个字概括就够了
这么多手段,落到 TTFT 上其实只做三件事:
省计算:前缀缓存、模型量化、模型稀疏
快传输:通信与计算 Overlap、DeepEP
少排队:PD 分离、Chunked Prefill、优先级调度
单点优化很容易撞到天花板,三者合力,才能把 TTFT 真正压到极致。
如果你也在做推理性能优化,欢迎在评论区聊聊你踩过的坑。