写在前面
DeepSeek-V4.1-Flash 这次最值得看的,不是 552B 这个参数数字,而是它把长上下文模型从计算、缓存、训练到推理系统几乎重新梳理了一遍。它要回答的核心问题只有一个:
当 Agent 需要处理百万 token 上下文、频繁工具调用、多轮推理时,如何让 KV Cache 不再成为系统瓶颈?
本文以技术报告配套的 14 张结构化示意图为主线,按「为什么降本 → 架构怎么改 → 缓存怎么压 → 系统怎么支撑 → 能力与边界」的顺序,逐层拆解 V4.1-Flash 的设计与取舍。
来源说明:全文技术细节以官方技术报告的图解为准,配图为报告解读图(章节 1.1–1.14)。涉及价格、部署门槛等运营口径请以官方 changelog 为准。
1. 问题:长时程 Agent 的新瓶颈
稀疏注意力降低了计算量,但全局 KV 仍然需要长期保存、复用和搬运。上下文越长,存储容量、数据搬运、系统带宽越容易成为瓶颈——这才是长时程 Agent 真正的新瓶颈。
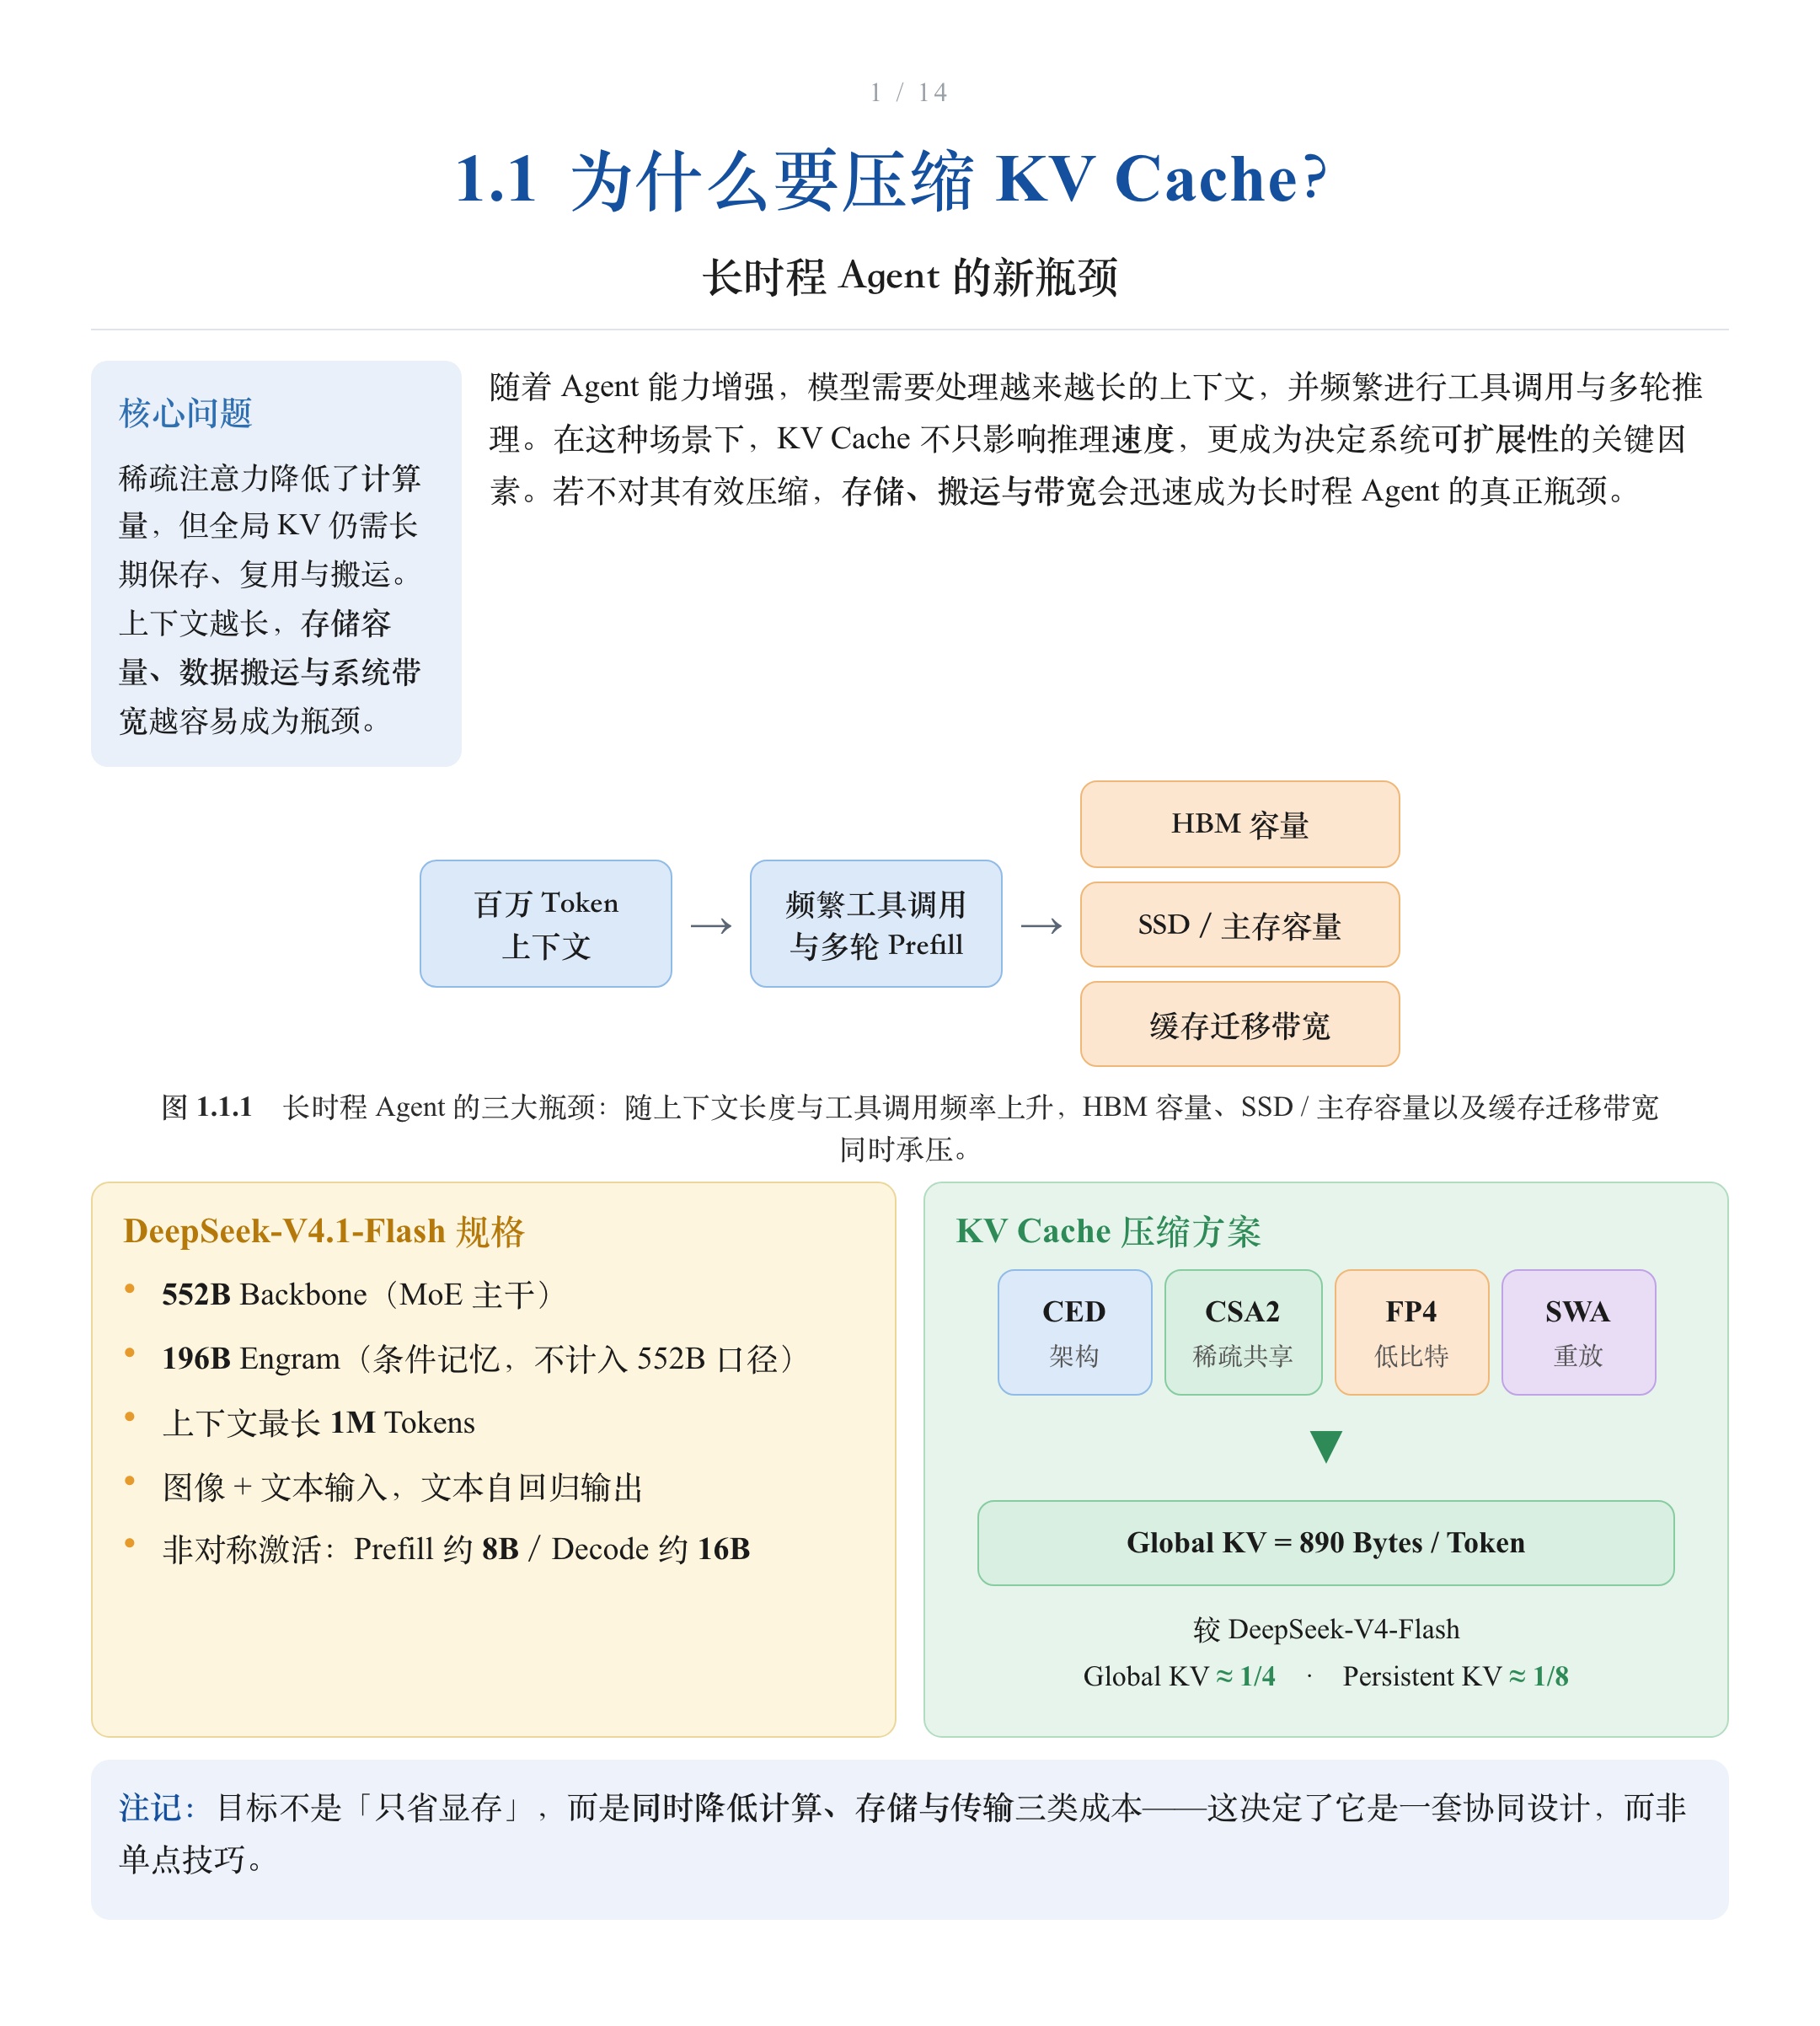
先把规格钉死,后面所有机制都围绕它展开:
- 552B Backbone(MoE 主干)+ 196B Engram(条件记忆,不计入 552B 口径);
- 上下文最长 1M tokens;
- 图像 + 文本输入,文本自回归输出;
- 非对称激活:Prefill(编码)激活约 8B,Decode(解码)激活约 16B。
压缩由四件套叠加完成——CED + CSA2 + FP4 Main KV + SWA Bounded Replay,最终把 Global KV 压到 890 字节/token。相对 DeepSeek-V4-Flash:Global KV 约 1/4,Persistent KV 约 1/8。
关键认知:目标不是「只省显存」,而是同时降低计算、存储与传输三类成本。这决定了它不是单点技巧,而是一套协同设计。
2. 架构核心:CED —— 只让一半网络读完整提示
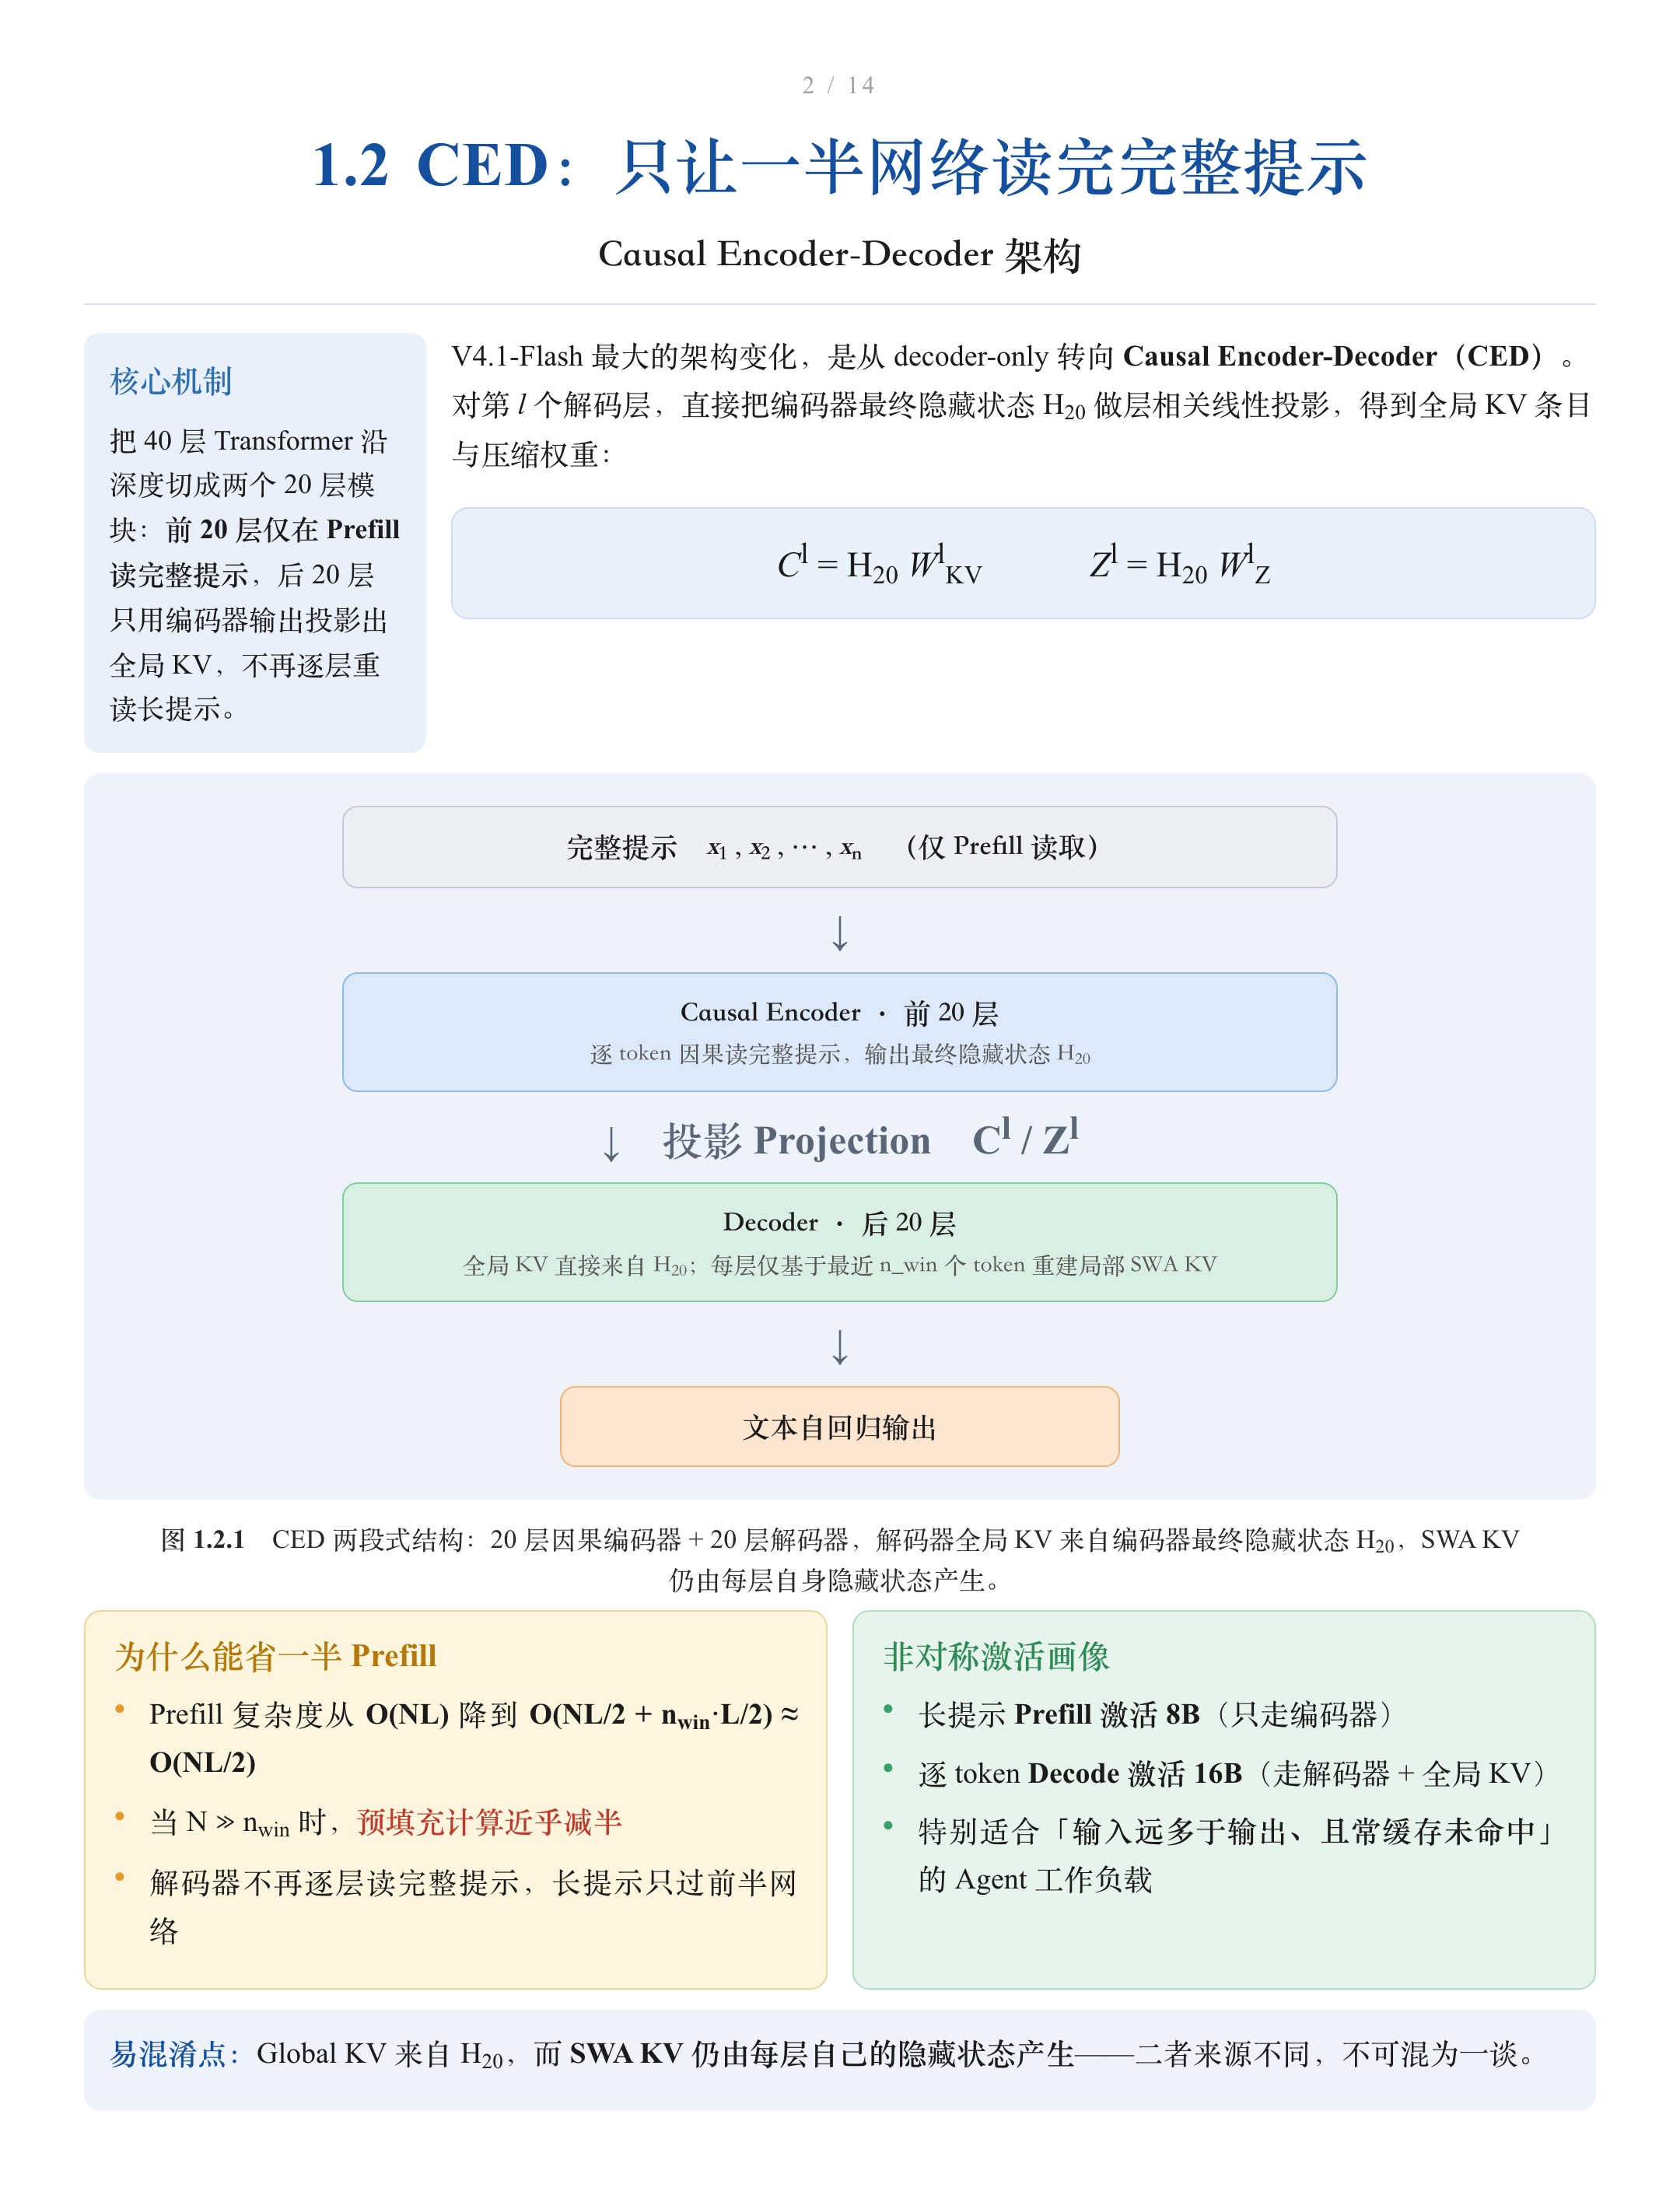
V4.1-Flash 最大的架构变化,是从 decoder-only 转向 Causal Encoder-Decoder(CED):把 40 层 Transformer 沿深度切成两个 20 层模块。
机制拆解:
- 前 20 层 = Causal Encoder:仅在 Prefill 阶段读取完整提示
x_1 … x_n; - 后 20 层 = Decoder:不再逐层读完整提示,而是直接用编码器最终隐藏状态
H_20(第 20 层输出)投影出全局 KV,并在每层只基于最近若干 token 重建局部 SWA KV。
全局表示公式——对第 l 个解码层,直接把 H_20 做层相关线性投影:
C^l = H_20 · W^l_KV     # Global KV entries
Z^l = H_20 · W^l_Z      # Compression weights
其中 C^l 是 Global KV entries,Z^l 是 Compression weights。Prefill 复杂度随之从 O(N·L) 降到 O(N·L/2 + n_win · L/2) ≈ O(N·L/2)——当 N ≫ n_win 时,预填充计算近乎减半。
一个容易混淆的点要讲清:Global KV 来自 H_20,而 SWA KV 仍由每层自己的隐藏状态产生。这也是 CED 的两阶段画像——长提示 Prefill 激活 8B、逐 token Decode 激活 16B——特别适合「输入远多于输出、且经常缓存未命中」的 Agent 工作负载。
3. 缓存压缩:三层机制叠加
890 字节/token 不是单一技巧压出来的,而是 CSA2(层间/序列)+ FP4(条目比特)+ SWA Bounded Replay(持久化) 三层叠加的结果。
3.1 CSA2:三维联合压缩
CSA2 替代了 V4 系列的 CSA + HCA 混合方案,从条目大小、序列维度、层维度三个方向联合压缩。
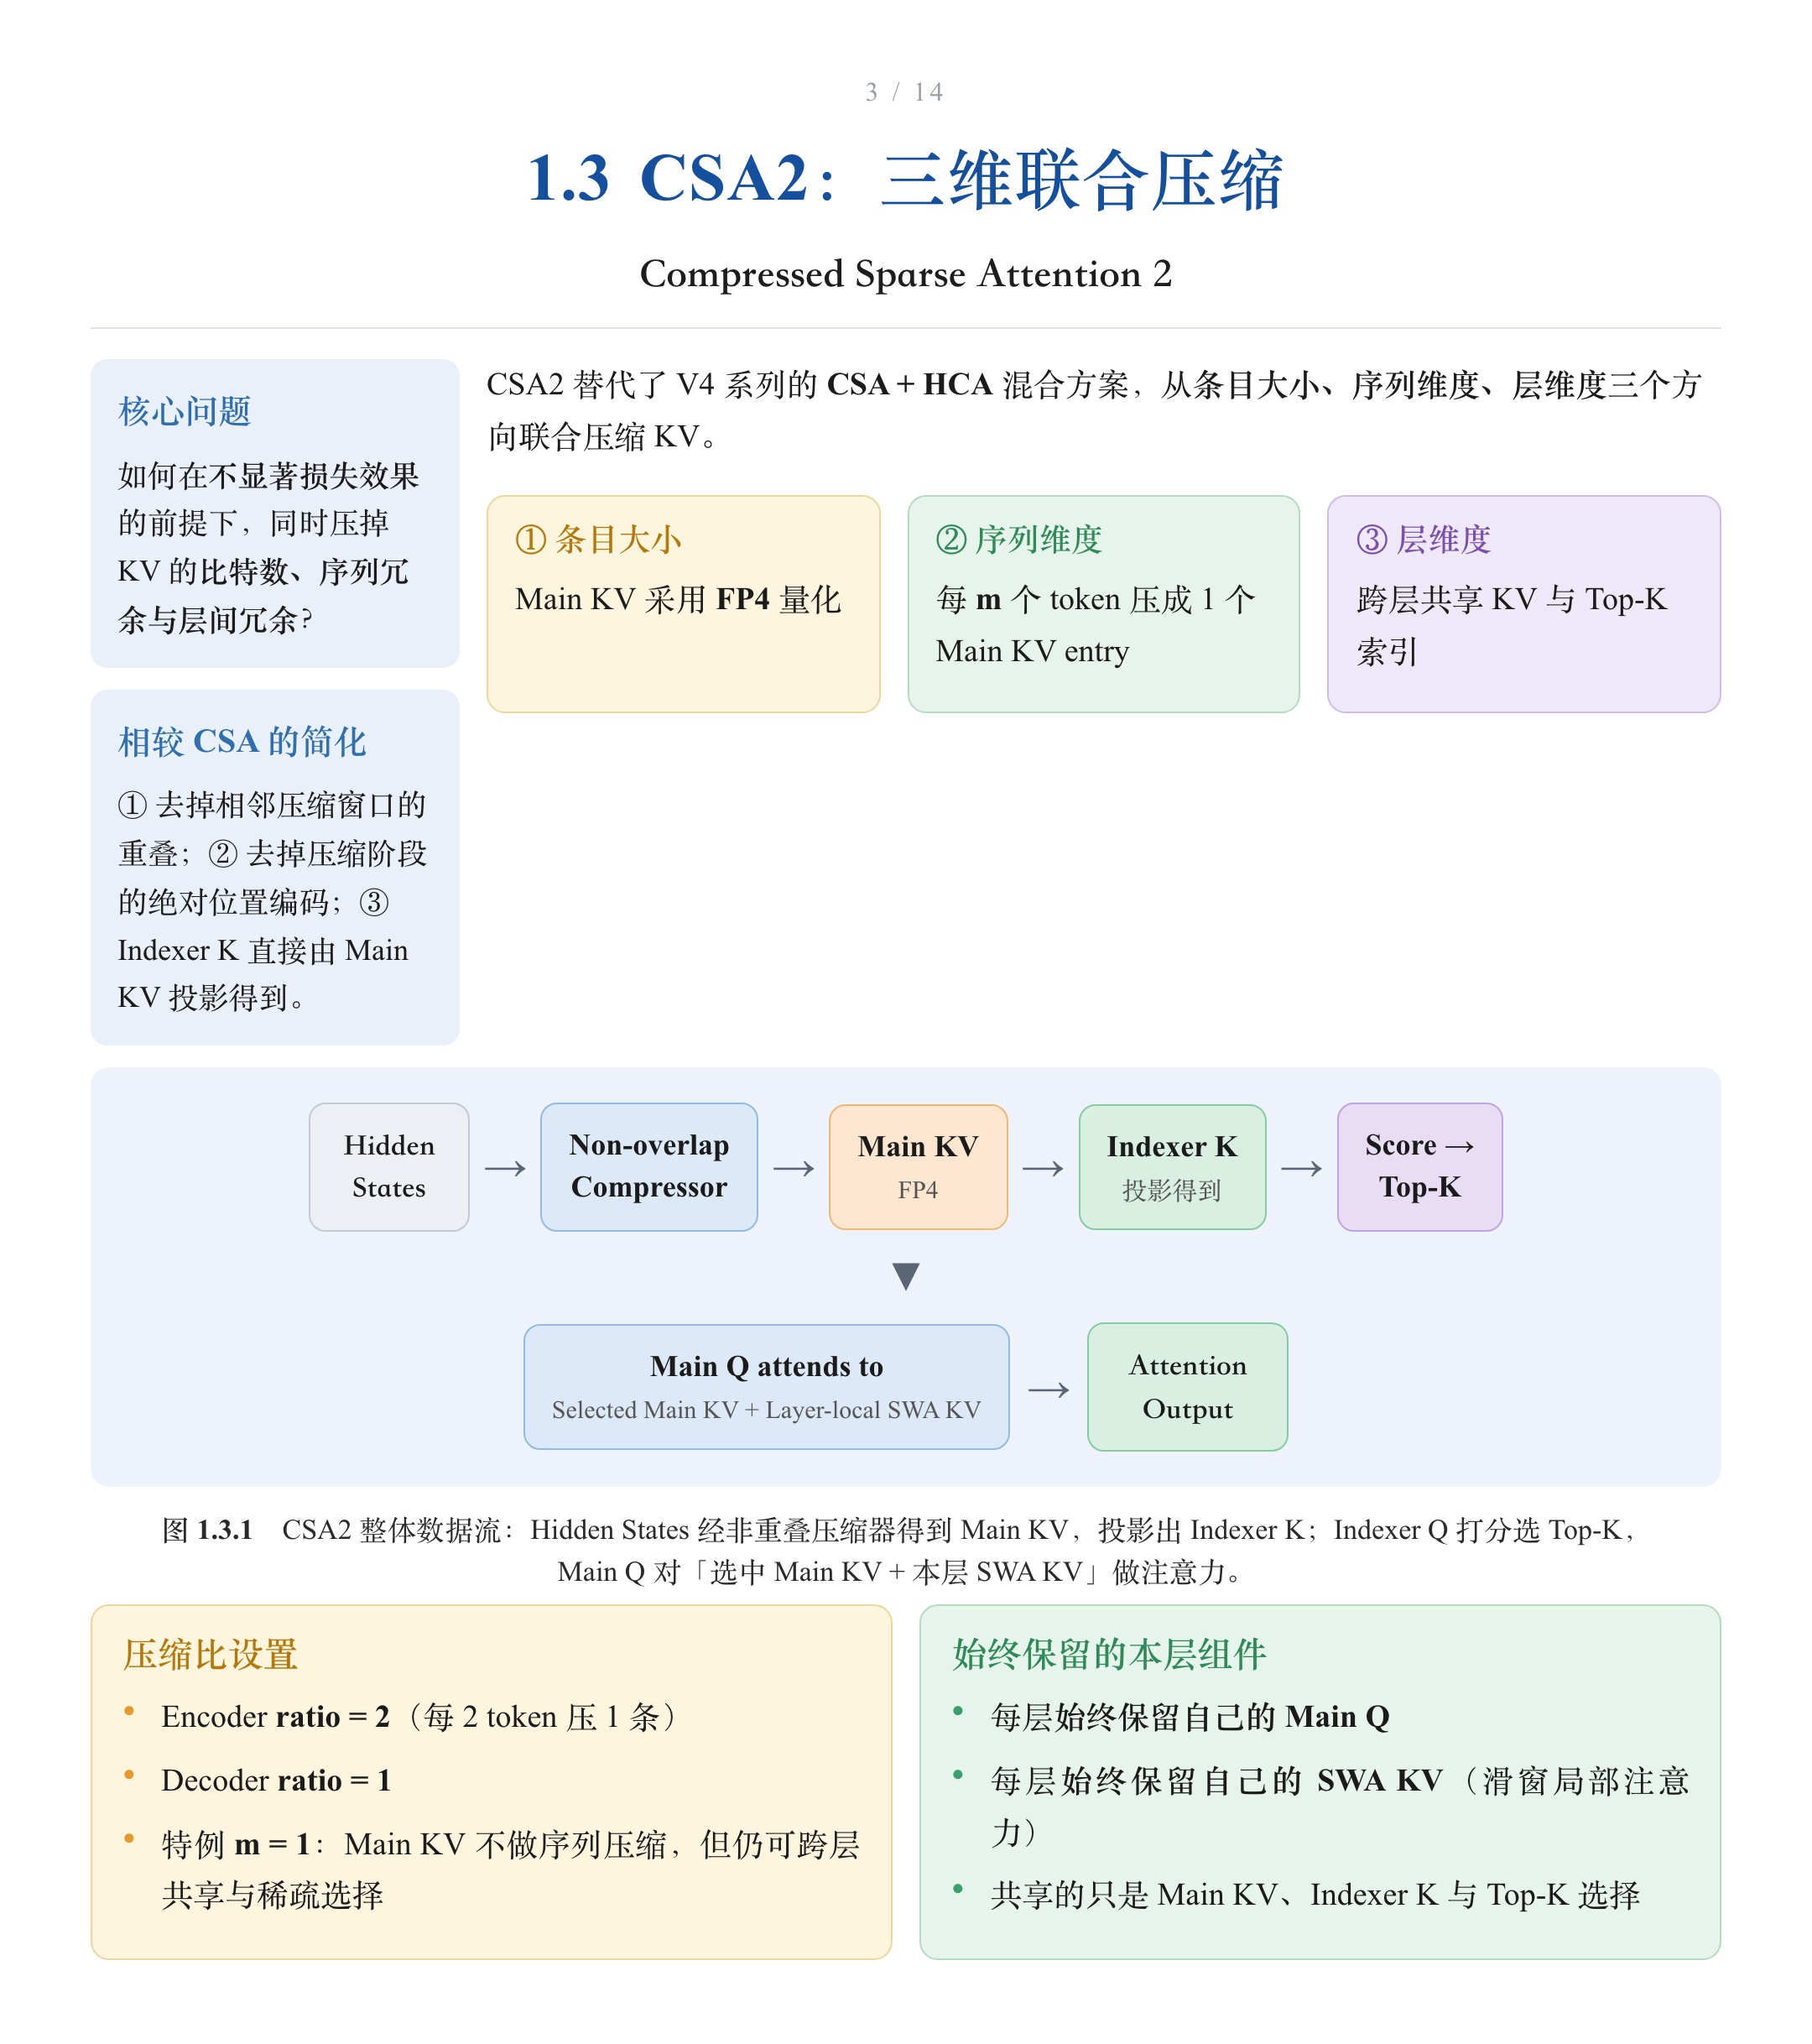
- 条目大小:Main KV 用 FP4;
- 序列维度:每
m个 token 压成 1 个 Main KV entry; - 层维度:跨层共享 KV 与 Top-K 索引。
数据流是:Hidden States → Non-overlapping Compressor → Main KV →(Projection)→ Indexer K;Indexer Q × Indexer K → Score → Top-K;最终 Main Q attends to (Selected Main KV + Layer-local SWA KV) → Attention Output。
相较 CSA 的三点简化:① 去掉相邻压缩窗口的重叠;② 去掉压缩阶段的绝对位置编码;③ Indexer K 直接由 Main KV 投影得到。压缩比设置为 Encoder = 2、Decoder = 1;特殊情况 m = 1 时 Main KV 不做序列压缩,但仍可跨层共享与稀疏选择。注意:每层始终保留自己的 Main Q 与 SWA KV。
3.2 三种运行模式:Full / Reindex / Reuse
CSA2 把每个注意力层静态指定为三种模式之一,在计算量与表示能力之间取舍。
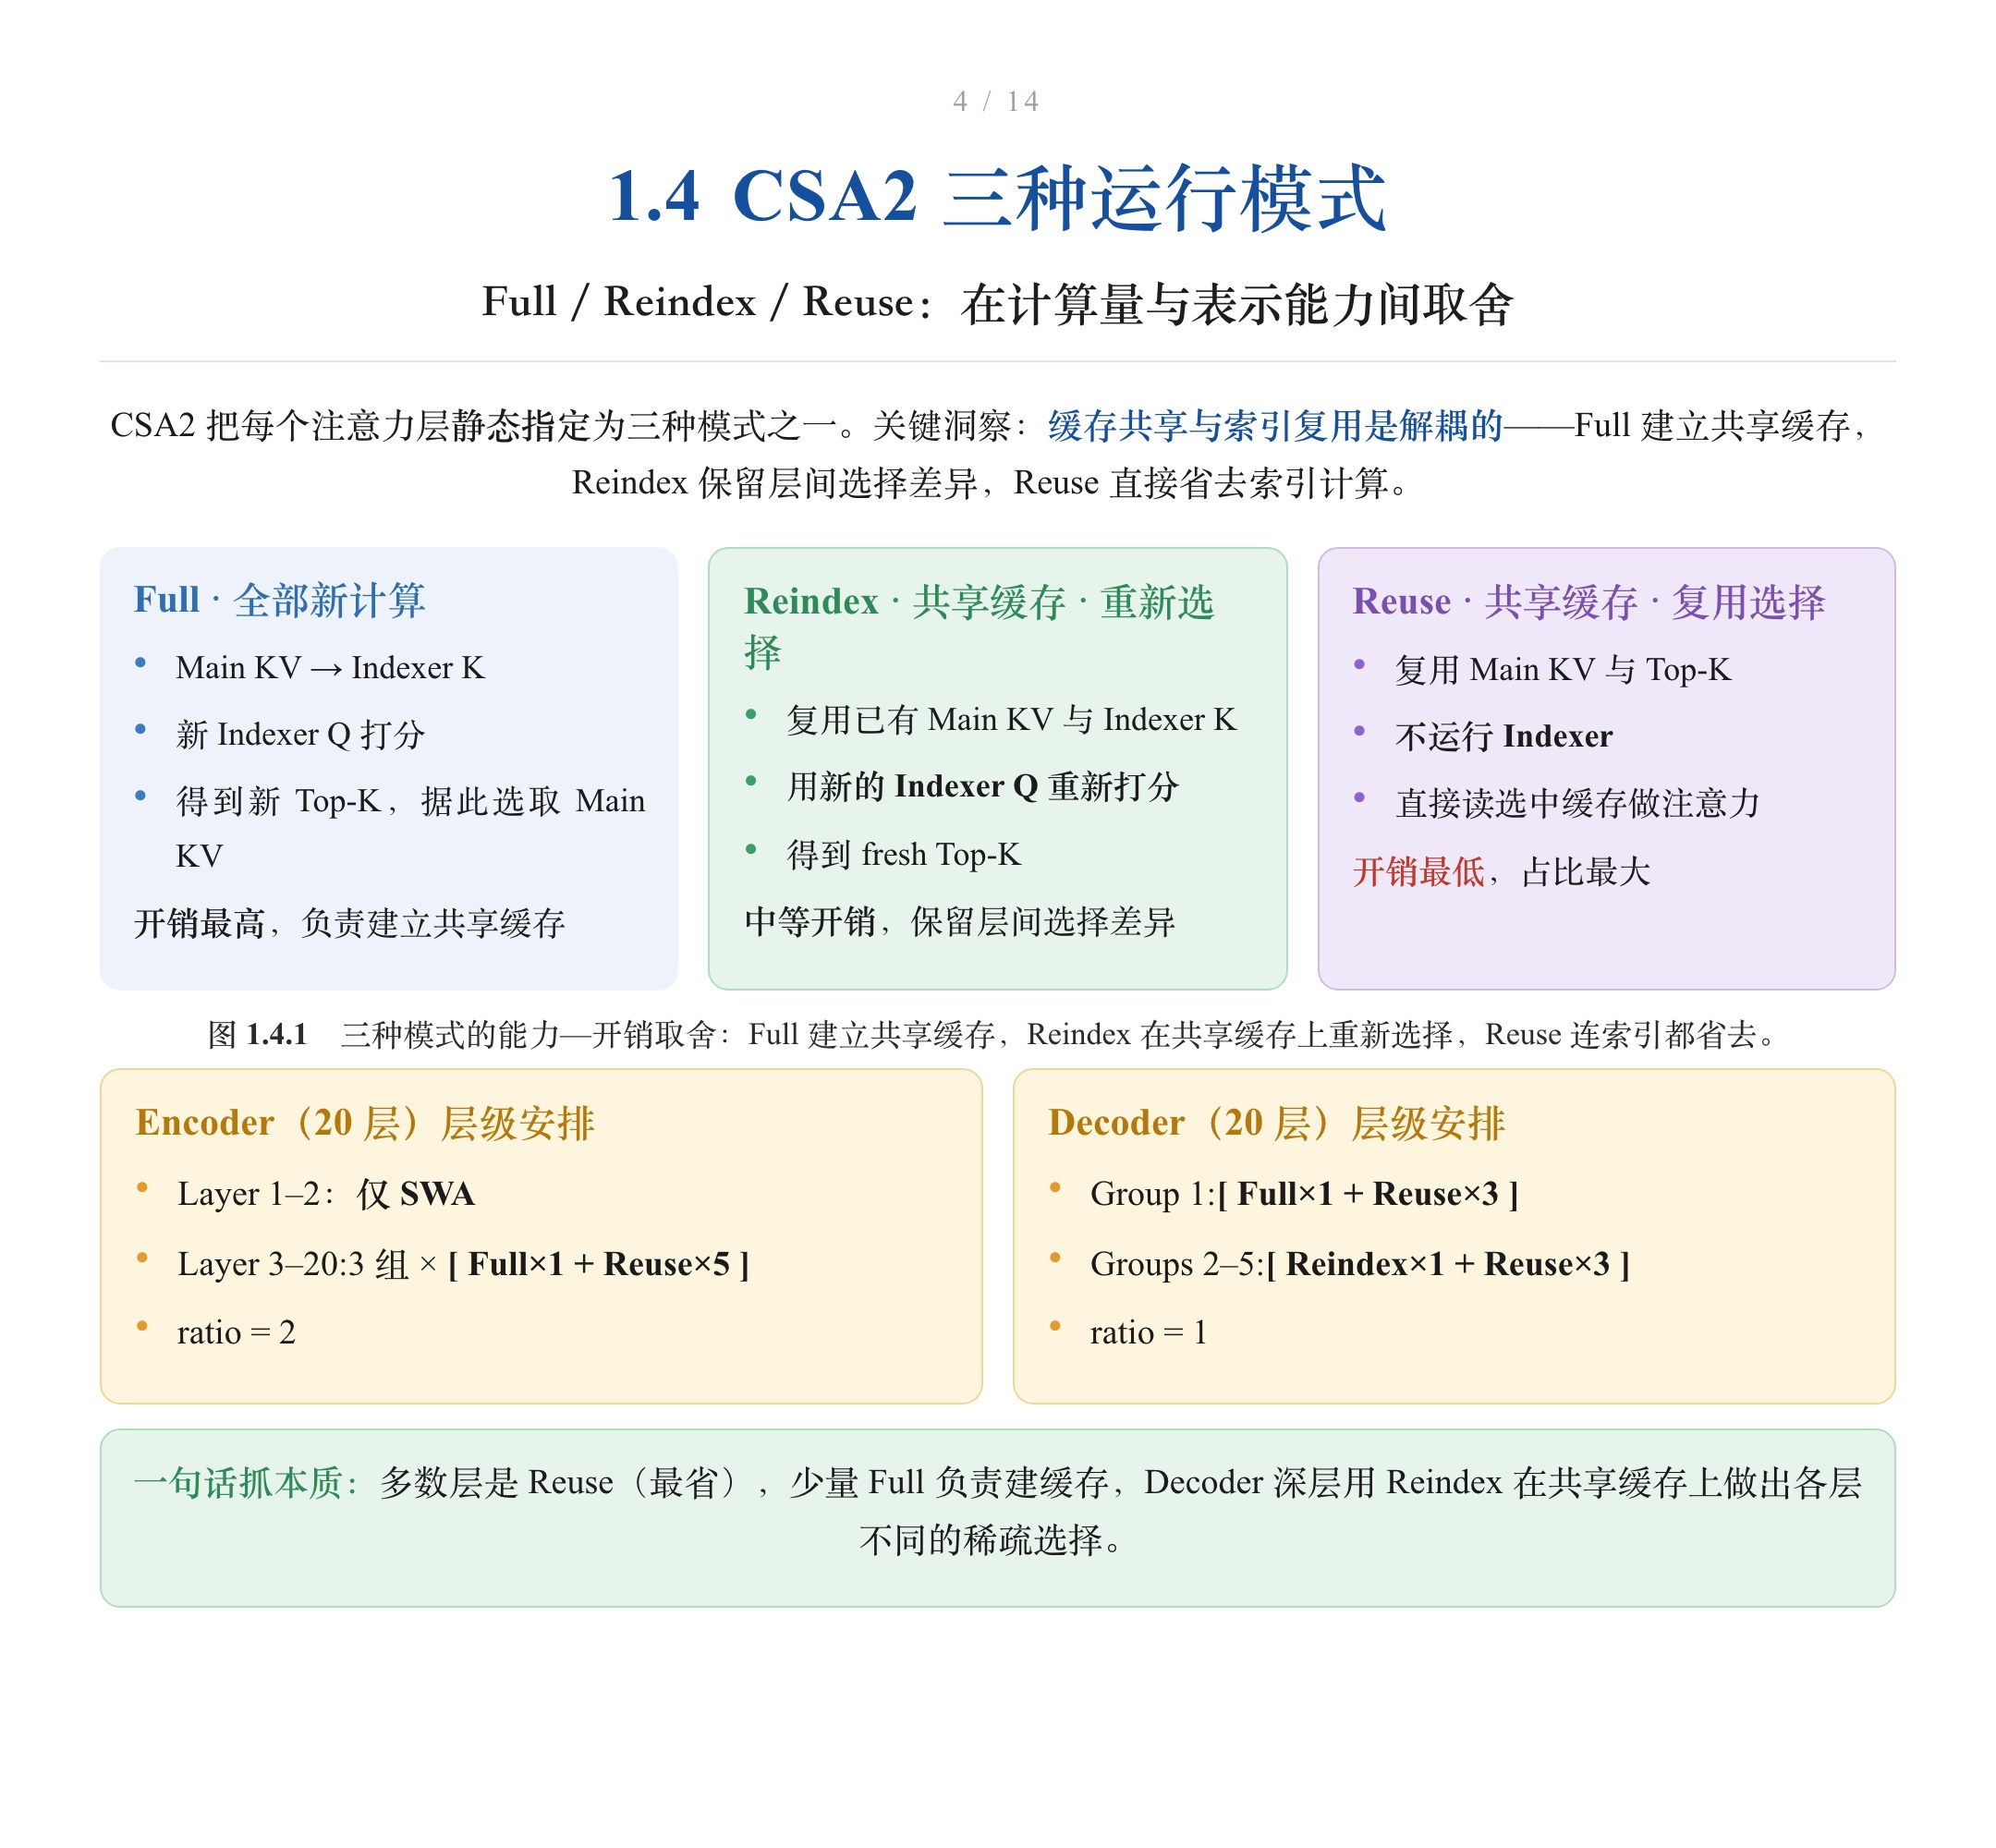
- Full(全部新计算):Main KV → Indexer K,Indexer Q 对 Indexer K 打分得到新 Top-K,据此选 Main KV;
- Reindex(共享缓存,重新选择):复用之前的 Main KV 与 Indexer K,用新的 Indexer Q 重新打分得到 fresh Top-K;
- Reuse(共享缓存,也复用选择):复用 Main KV 与 Top-K,不运行 Indexer,开销最低。
层级运行安排很能说明设计意图:
- Encoder(20 层):Layer 1–2 仅 SWA;Layer 3–20 为 3 组 × [Full×1 + Reuse×5],ratio=2;
- Decoder(20 层):Group 1 为 [Full×1 + Reuse×3];Groups 2–5 为 [Reindex×1 + Reuse×3],ratio=1。
一句话抓住本质:缓存共享与索引复用是解耦的——Full 负责建立共享缓存,Reindex 保留层间选择差异,Reuse 直接省去索引计算。
3.3 分层稀疏索引器:让索引开销与上下文长度解耦
普通 Indexer 的问题是:每个深层索引器都要扫描完整上下文,长上下文下仍然昂贵。分层稀疏索引器用「全范围扫描 + 候选池共享 + 局部重索引」破题。
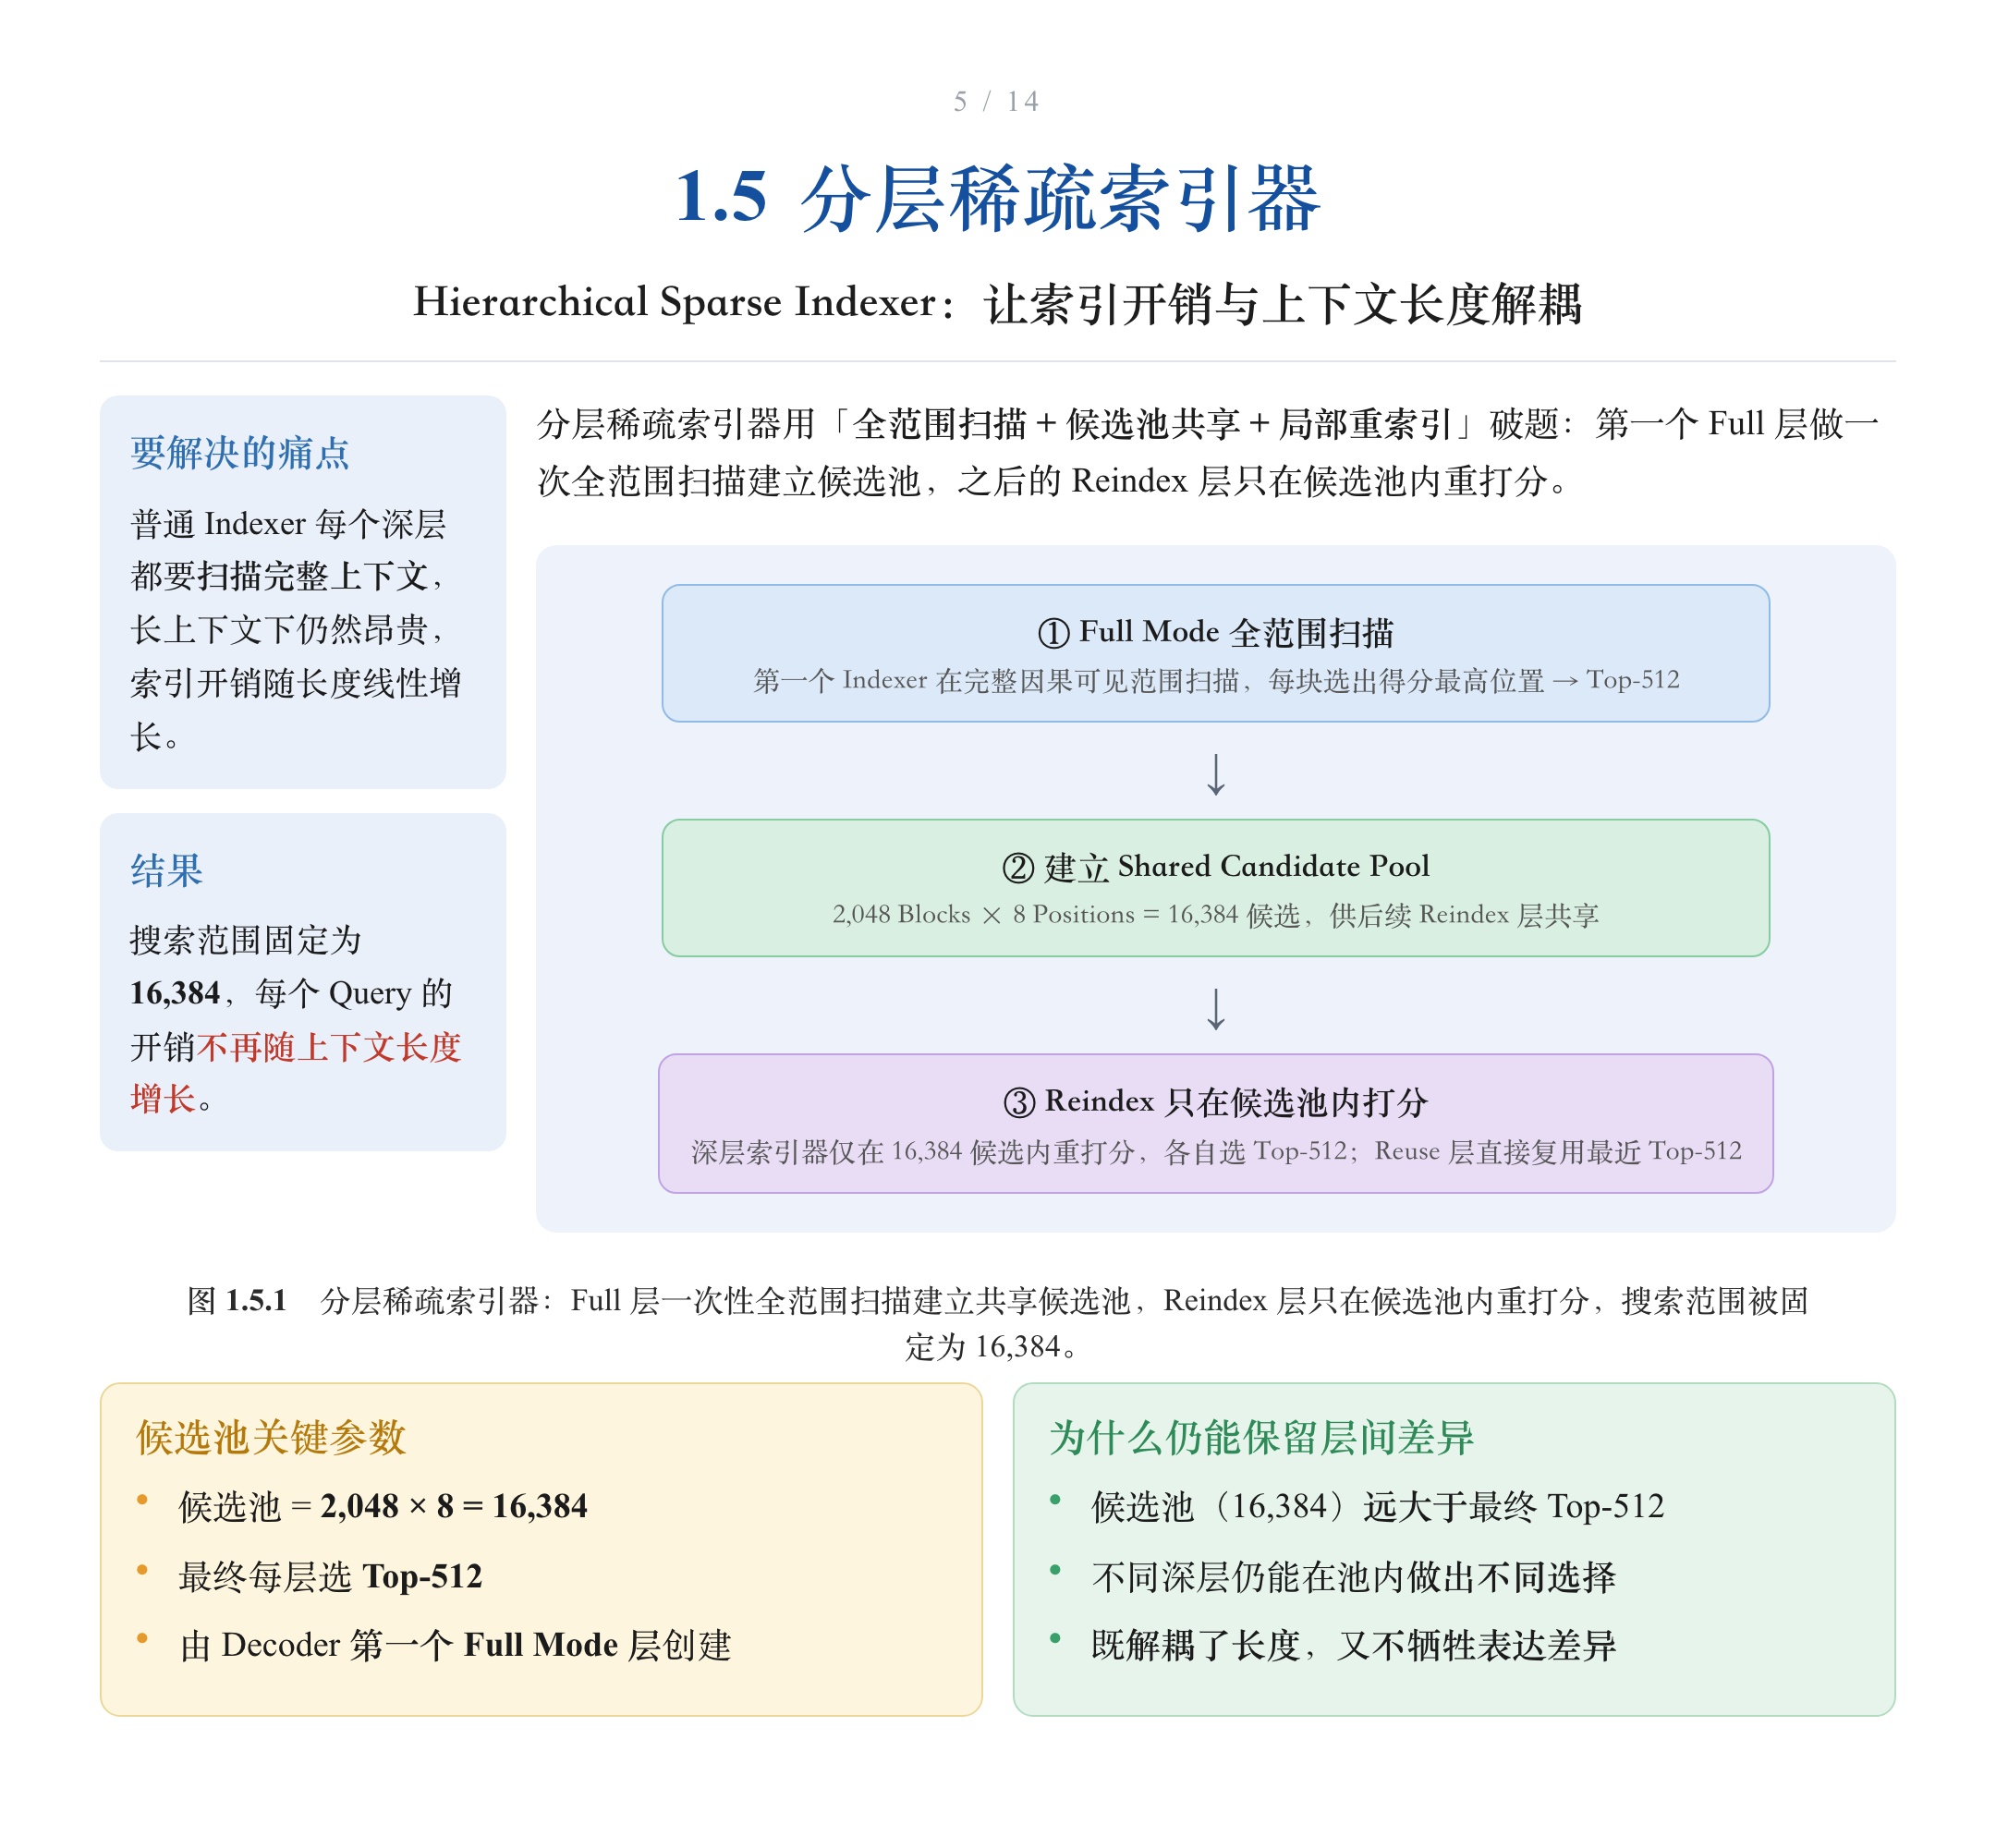
- ① Full Mode 全范围扫描:第一个 Indexer 在完整因果可见范围内扫描,每块选出得分最高的位置 → Top-512;
- ② 建立 Shared Candidate Pool:2,048 Blocks × 8 Positions = 16,384 候选,供后续 Reindex 层共享;
- ③ Reindex 只在候选池内打分:深层索引器仅在候选池内重打分,各自选出 Top-512;Reuse 层则直接复用最近的 Top-512。
结果是搜索范围固定为 16,384,每个 Query 的开销不再随上下文长度增长。候选池由 Decoder 第一个 Full Mode 层创建;因为候选池大于最终 Top-512,不同深层仍能做出不同选择——既解耦了长度,又不牺牲表达差异。
3.4 FP4 Main KV 与 SWA Bounded Replay
最后一层压缩落在比特与持久化上。
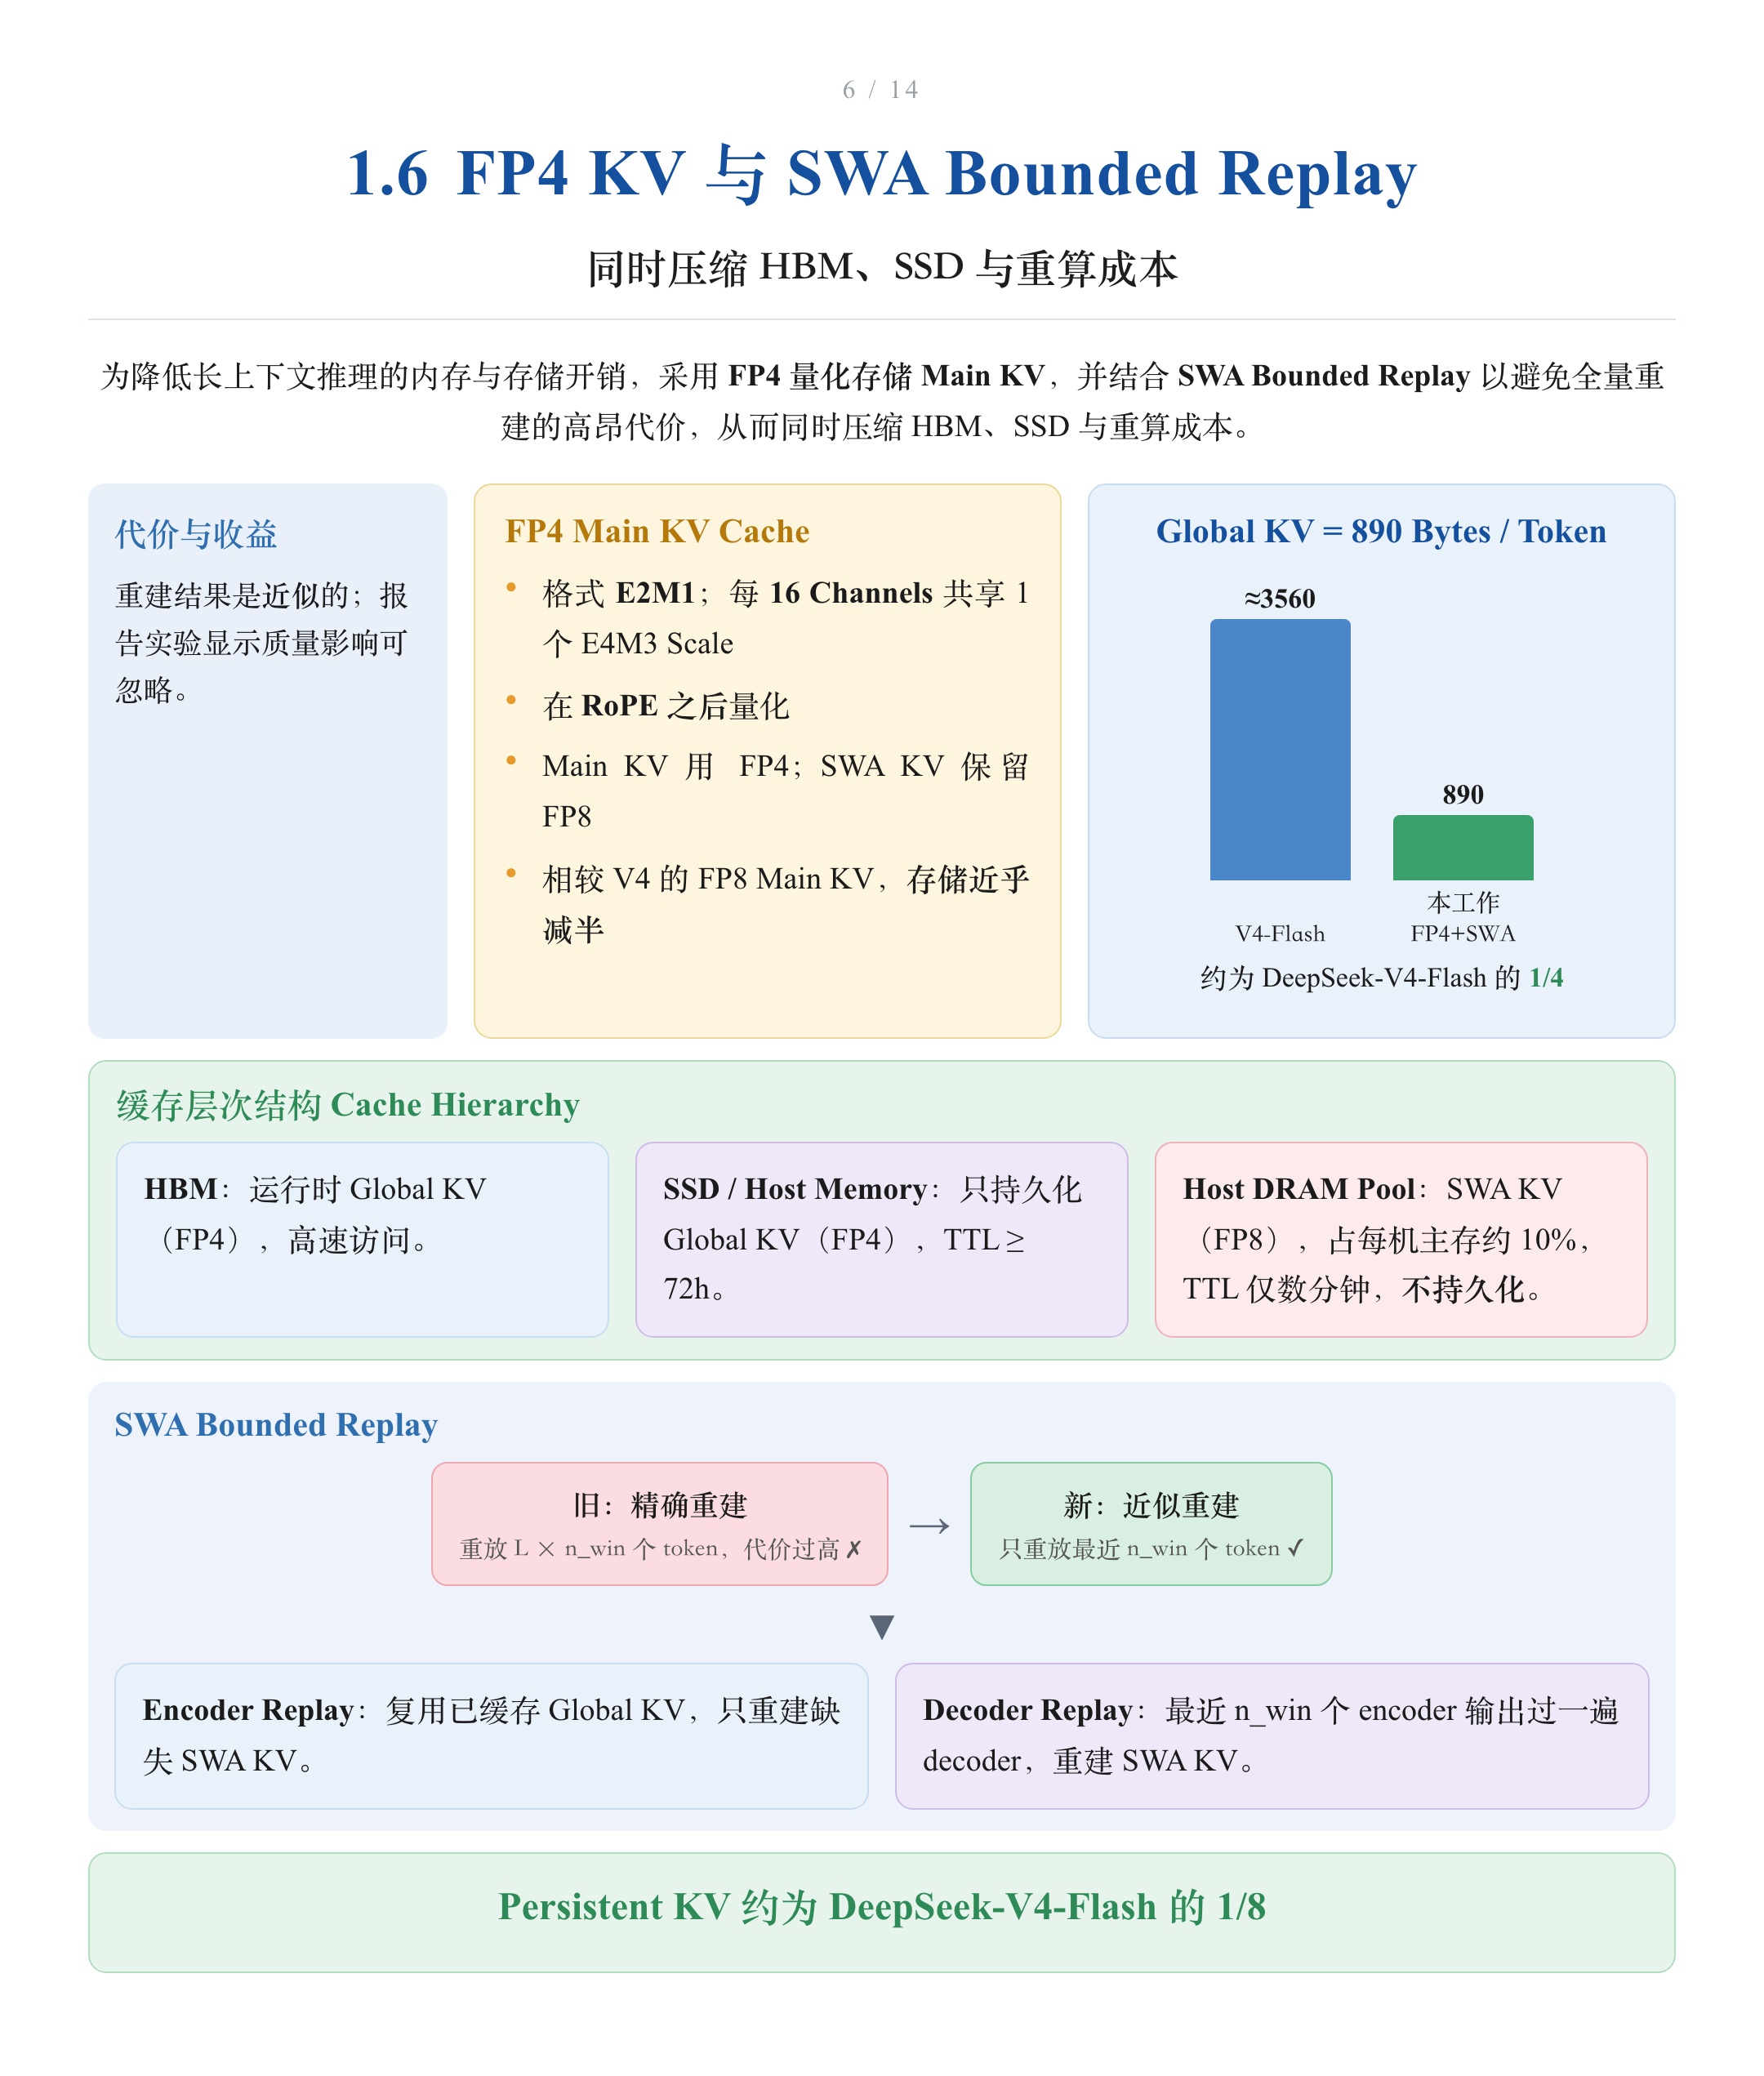
FP4 Main KV:格式 E2M1,每 16 个 channel 共享一个 E4M3 scale,在 RoPE 之后量化;Main KV 用 FP4、SWA KV 保留 FP8。相较 V4 的 FP8 Main KV,存储近乎减半——Global KV 从约 3,560 字节/token 降到 890 字节/token(约 1/4)。
缓存层次:
- HBM:运行时 Global KV(FP4),高速访问;
- SSD / Host Memory:只持久化 Global KV(FP4),TTL ≥ 72h;
- Host DRAM Pool:SWA KV(FP8),占每机主存约 10%,TTL 仅数分钟,不持久化。
SWA Bounded Replay:旧做法是精确重建 L × n_win 个 token(代价过高),新做法是近似重建——只重放最近 n_win 个 token。Encoder replay 复用已缓存 Global KV、只重建缺失 SWA KV;Decoder replay 让最近 n_win 个 encoder 输出过一遍 decoder 来重建 SWA KV。由此 Persistent KV 约为 V4-Flash 的 1/8。报告称重建是近似的,但实验显示质量影响可忽略。
4. 技术全景:从多模态输入到高效生成
把上面的架构、组件、训练与关键技术拼到一张图上,就是 V4.1-Flash 的技术全景。
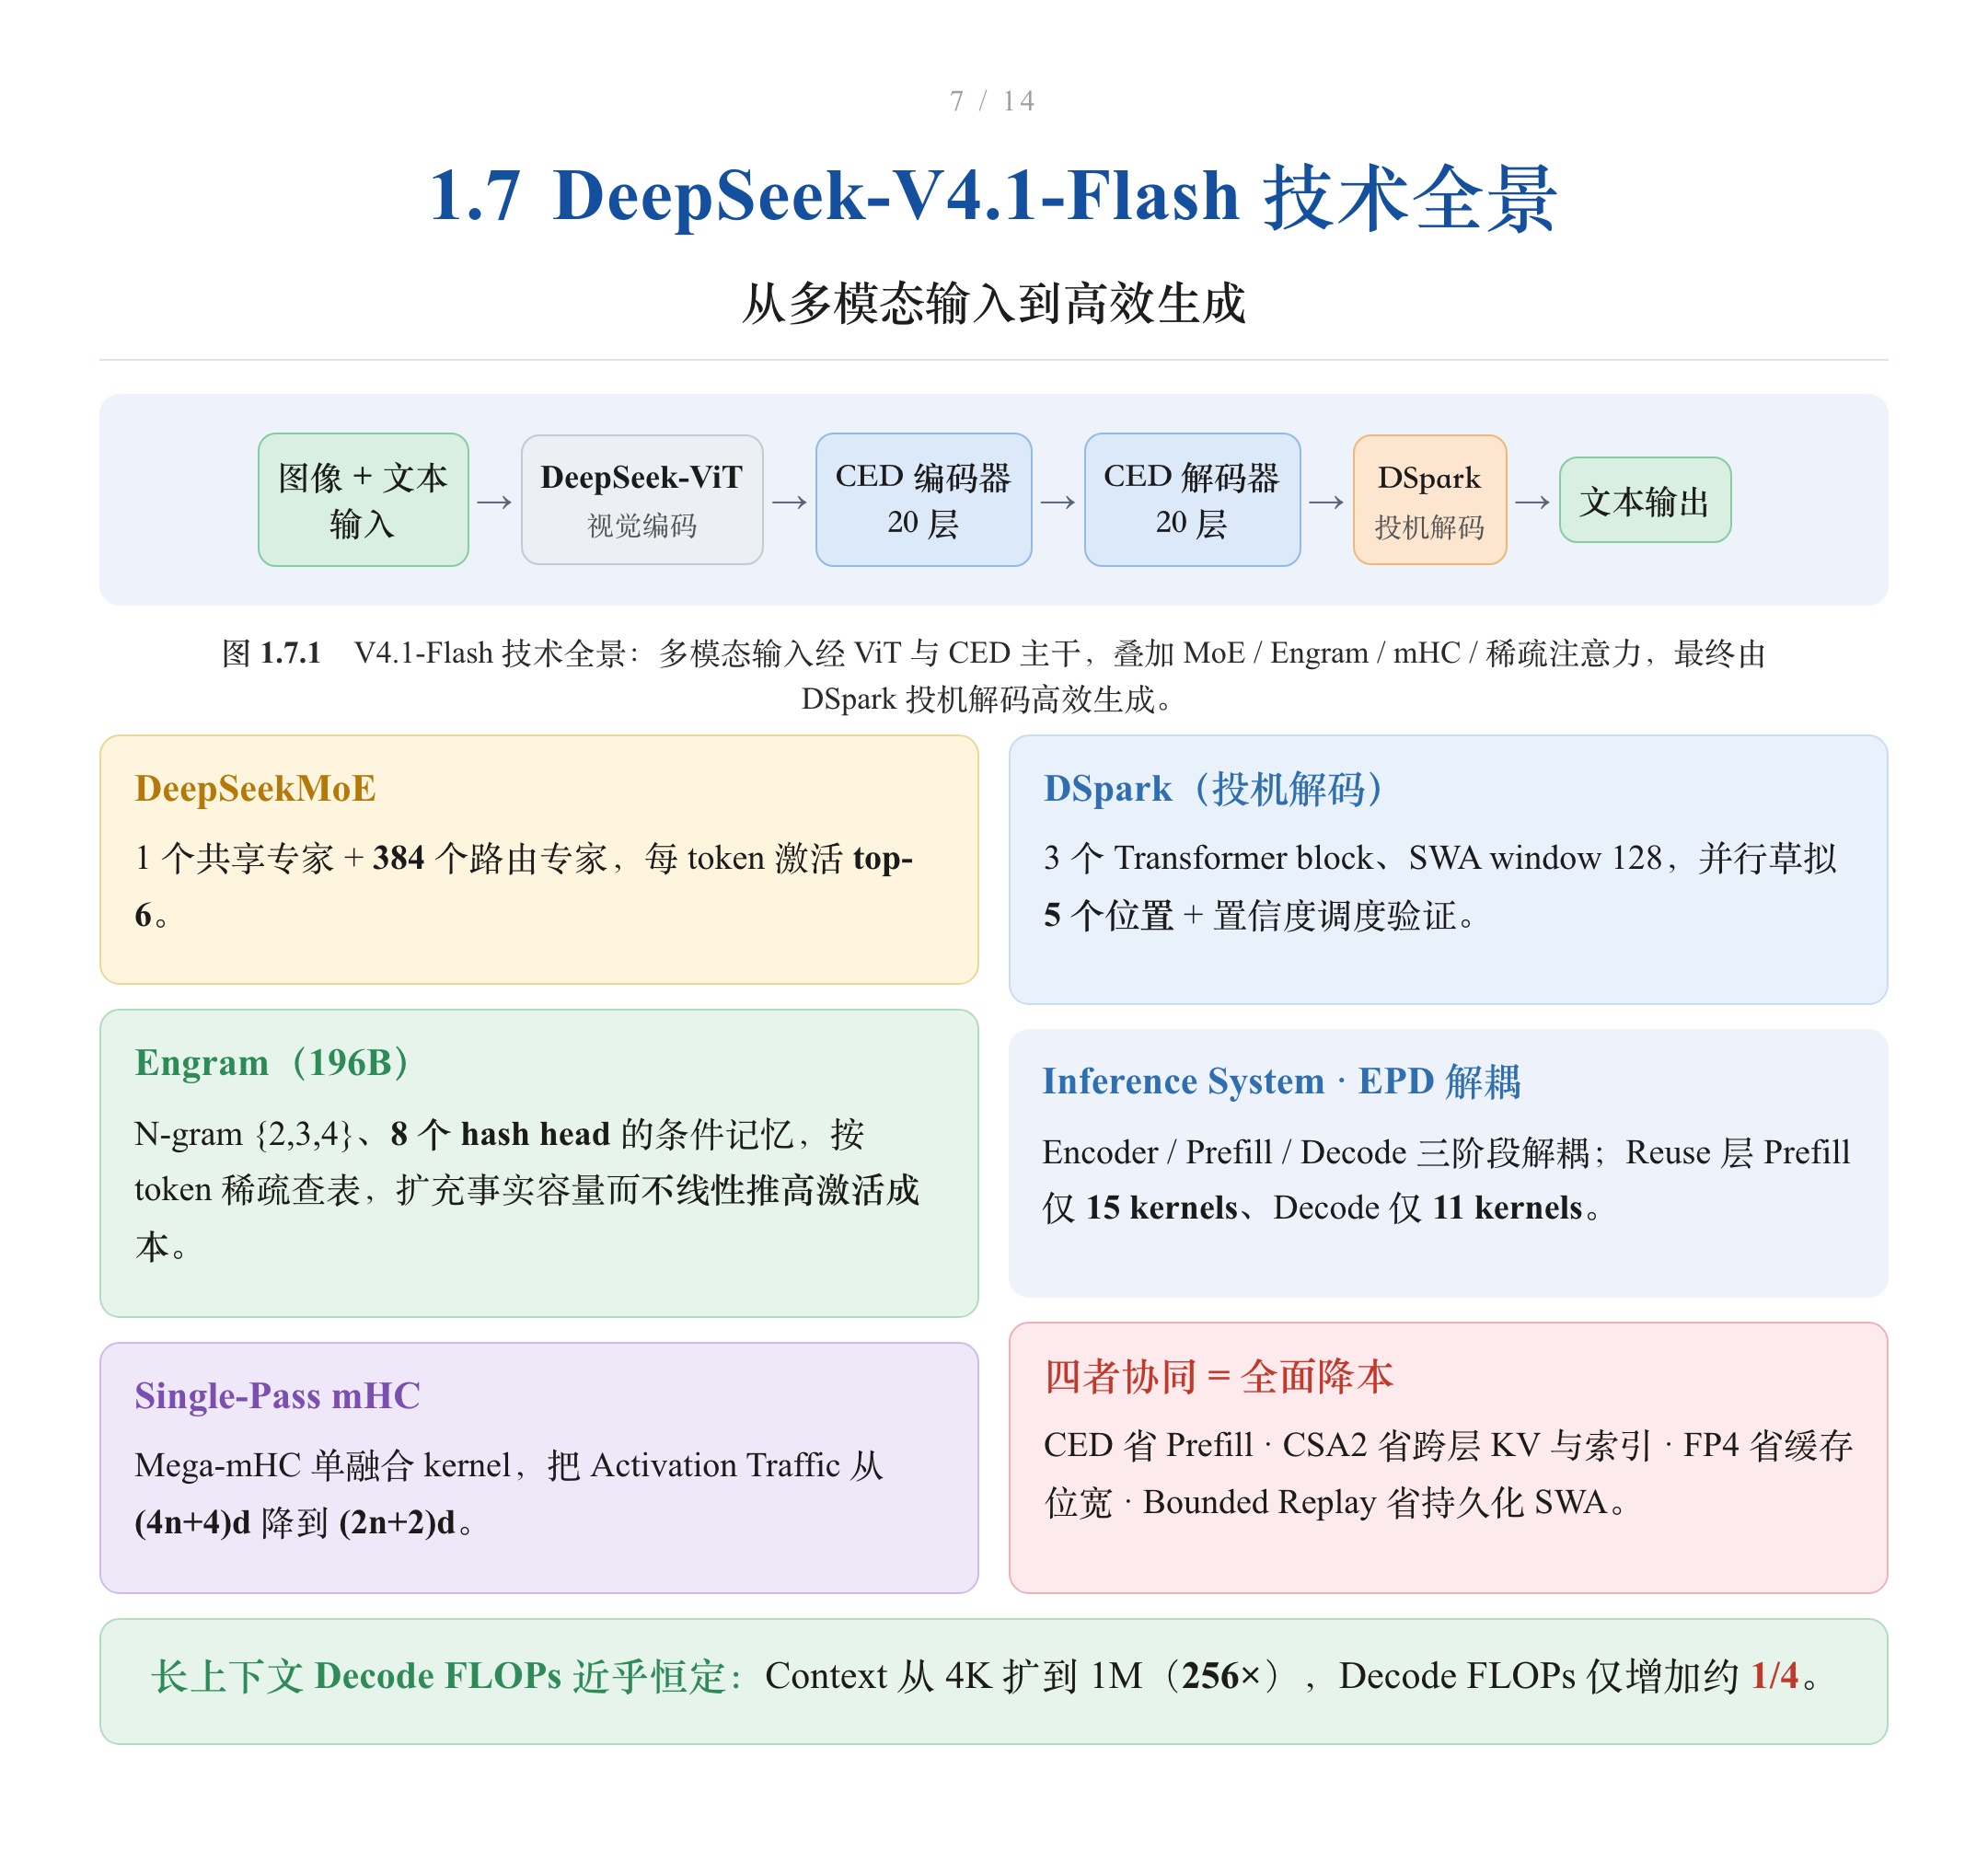
几个此前容易被忽略的组件:
- DeepSeekMoE:1 个共享专家 + 384 个路由专家,每 token 激活 top-6;
- Engram(196B):N-gram(
n = 2,3,4)、8 个 hash head 的条件记忆,按 token 稀疏查表,扩充事实容量而不线性推高激活成本; - Single-Pass mHC:Mega-mHC 单融合 kernel,把 Activation Traffic 从
(4n+4)·d降到(2n+2)·d; - DSpark(投机解码):3 个 Transformer block、SWA window 128,并行草拟 5 个位置 + 置信度调度验证;
- Inference System:EPD(Encoder / Prefill / Decode)解耦,Reuse 层 Prefill 仅 15 kernels、Decode 仅 11 kernels。
全景图底部那句结论最硬:长上下文 Decode FLOPs 近乎恒定——Context 从 4K 扩到 1M(256×),Decode FLOPs 仅增加约 1/4。 这正是「CED 省 Prefill、CSA2 省跨层 KV 与索引、FP4 省缓存位宽、Bounded Replay 省持久化 SWA」四者协同的最终体现。
5. 原生多模态:DeepSeek-ViT 与模态独立负载均衡
多模态不是后期外挂,而是从语言骨干预训练开始就进入同一 token 序列。
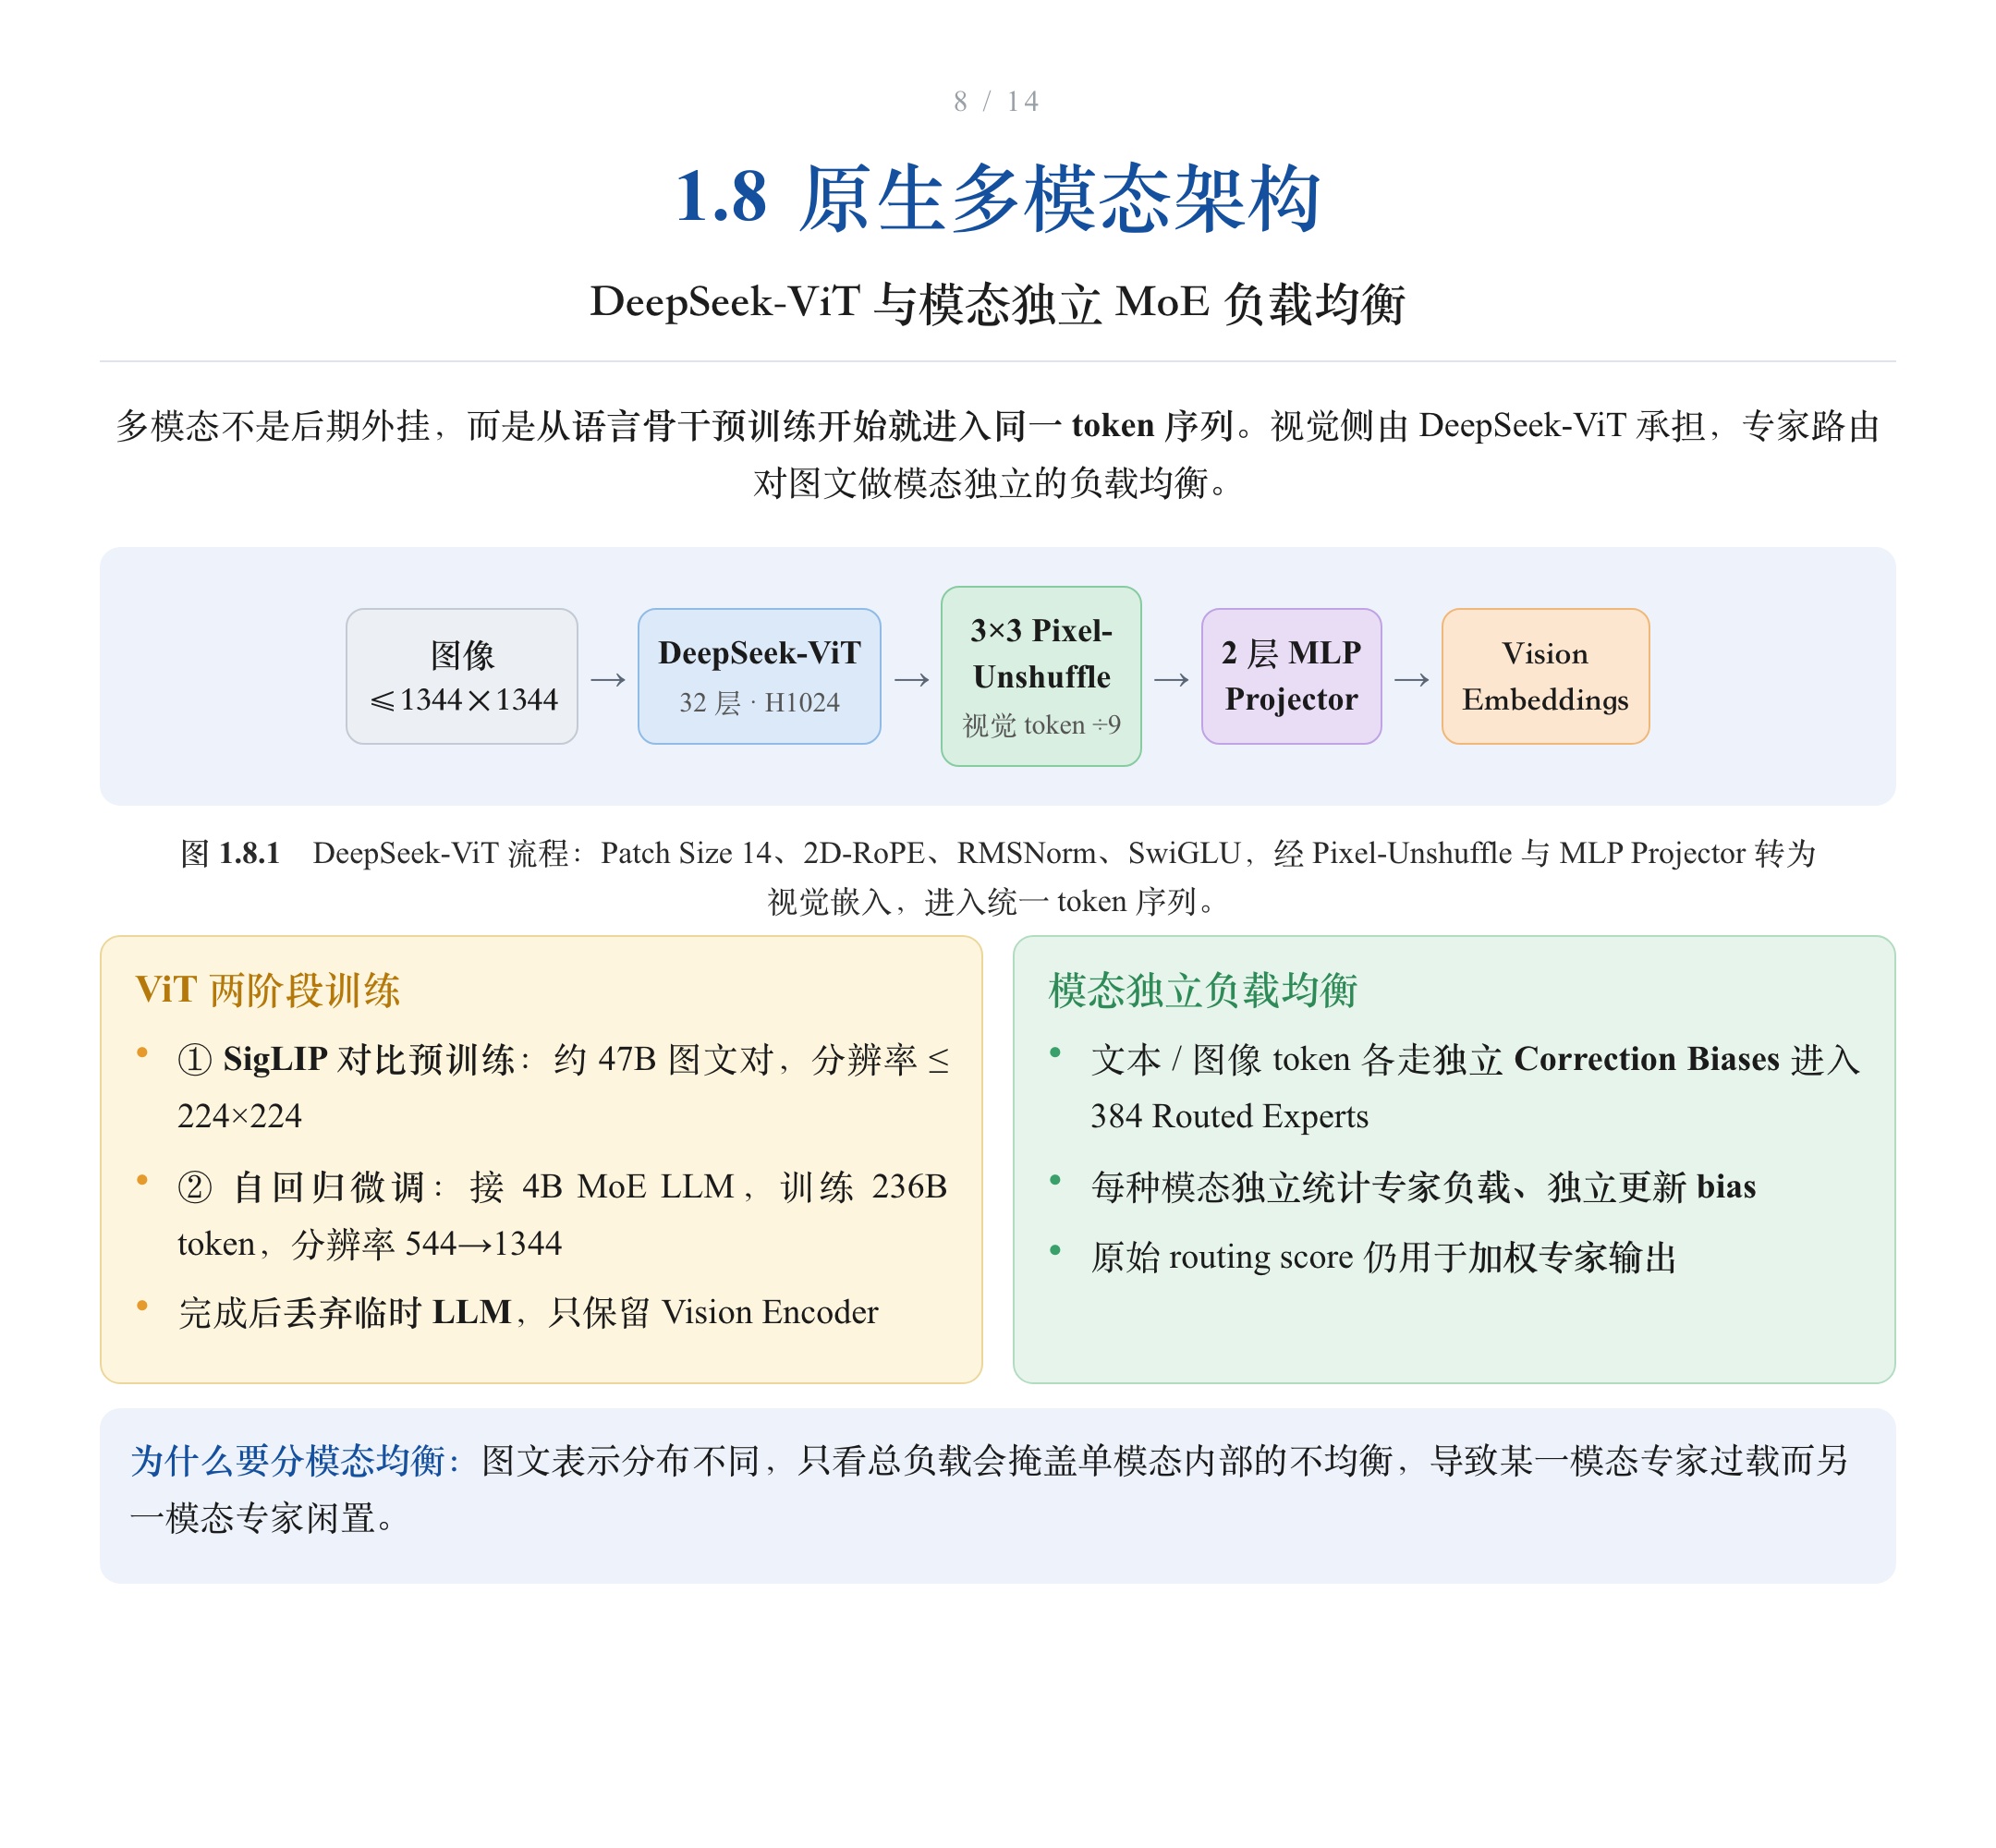
- DeepSeek-ViT:32 层、Hidden 1024、16 个注意力头、Patch Size 14,采用 2D-RoPE、Linear Patch Projection、RMSNorm、SwiGLU,支持约 1344×1344 输入;经 3×3 Pixel-Unshuffle(视觉 token 减少 9×)与 2 层 MLP Projector 转成 Vision Embeddings;
- 两阶段训练:① SigLIP 对比预训练(约 47B 图文对,分辨率 ≤224×224);② 自回归微调(接 4B MoE LLM,训练 236B token,分辨率 544→1344);完成后丢弃临时 LLM,只保留 Vision Encoder;
- 模态独立负载均衡:文本/图像 token 各自走独立的 Correction Biases 进入 384 Routed Experts,每种模态独立统计专家负载、独立更新 bias,但原始 routing score 仍用于加权专家输出。原因是图文表示分布不同,只看总负载会掩盖单模态内部的不均衡。
6. 训练系统:算法不变,功夫全在数据与工程
6.1 优化器为什么要分工
不同类型参数的结构、规模、优化性质不同,强行用一个优化器会顾此失彼。V4.1-Flash 按参数功能分工。
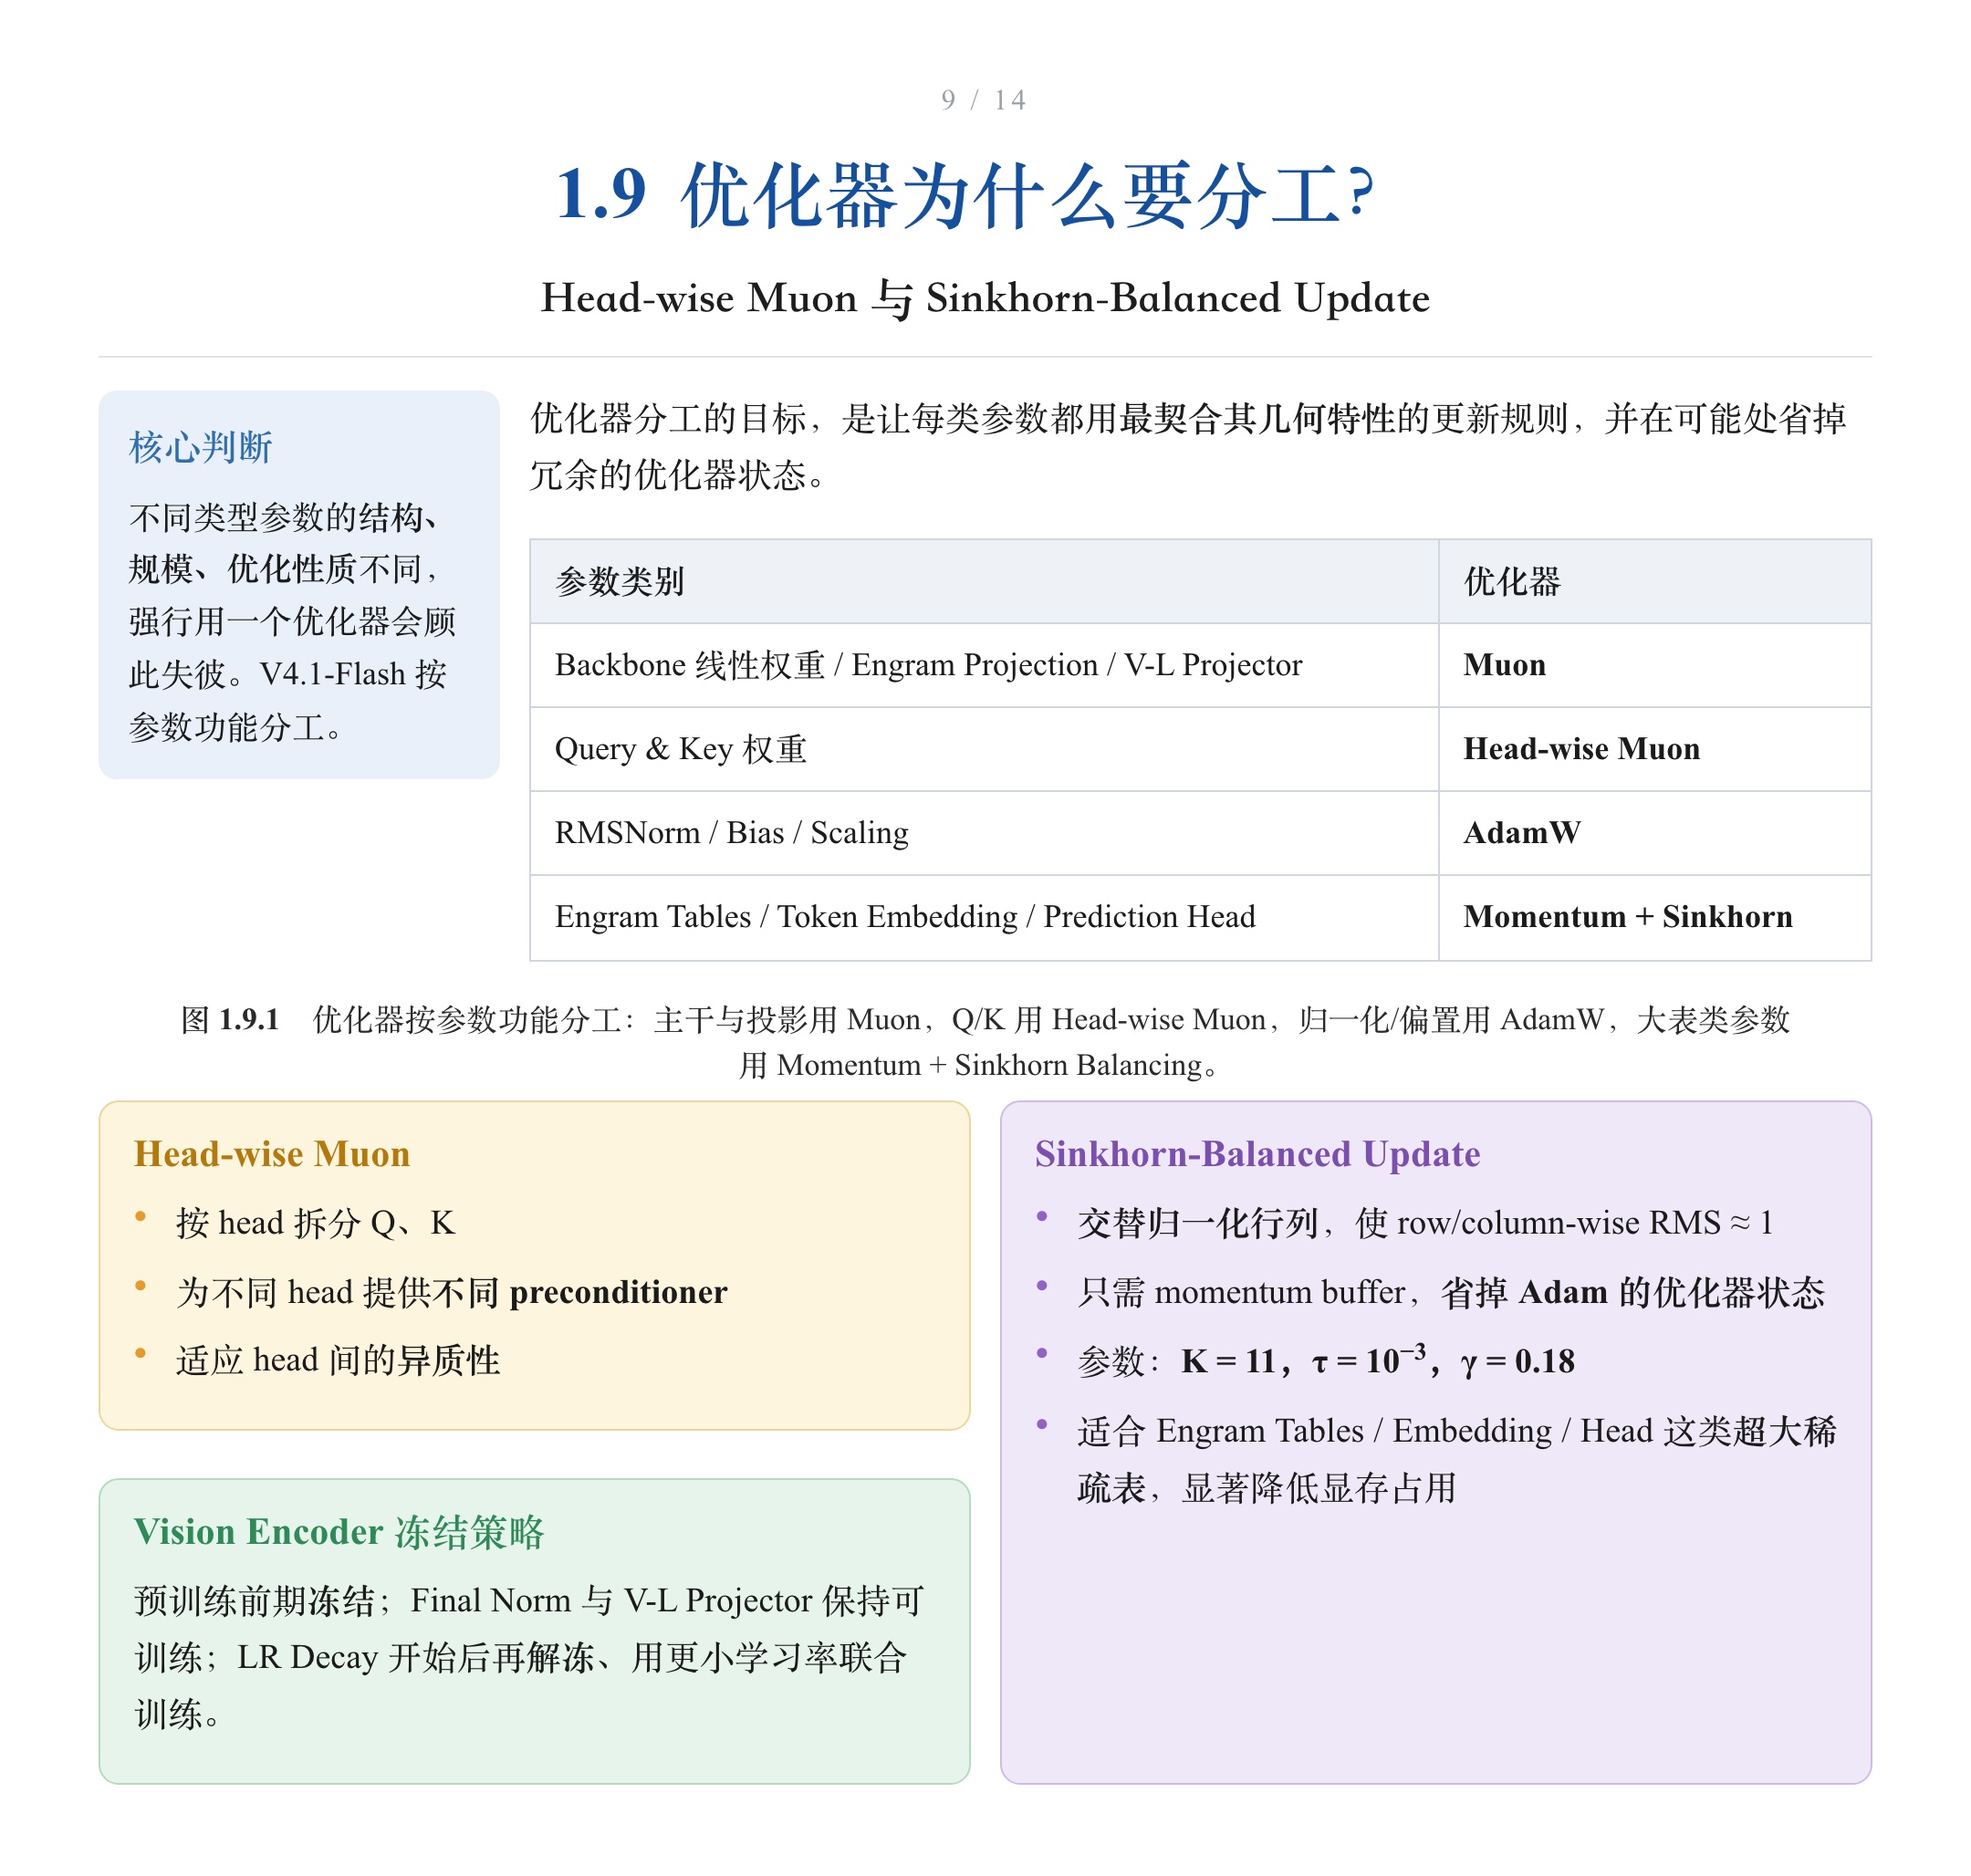
- Backbone 线性权重 / Engram Projection / V-L Projector → Muon;
- Query & Key 权重 → Head-wise Muon(按 head 拆分 Q、K,为不同 head 提供不同 preconditioner,适应 head 间异质性);
- RMSNorm / Bias / Scaling → AdamW;
- Engram Tables / Token Embedding / Prediction Head → Momentum + Sinkhorn Balancing(交替归一化行列,使 row/column-wise RMS ≈ 1,只需 momentum buffer,省掉 Adam 的优化器状态;
K = 11, τ = 1e-3, γ = 0.18)。
Vision Encoder 还有专门的冻结策略:预训练前期冻结,Final Norm 与 V-L Projector 保持可训练,LR Decay 开始后再解冻、用更小学习率联合训练。
6.2 让多模态、CSA2 与 Engram 真正跑起来
要在大规模场景下高效训练,需要在数据、并行、通信、存储多层面协同。
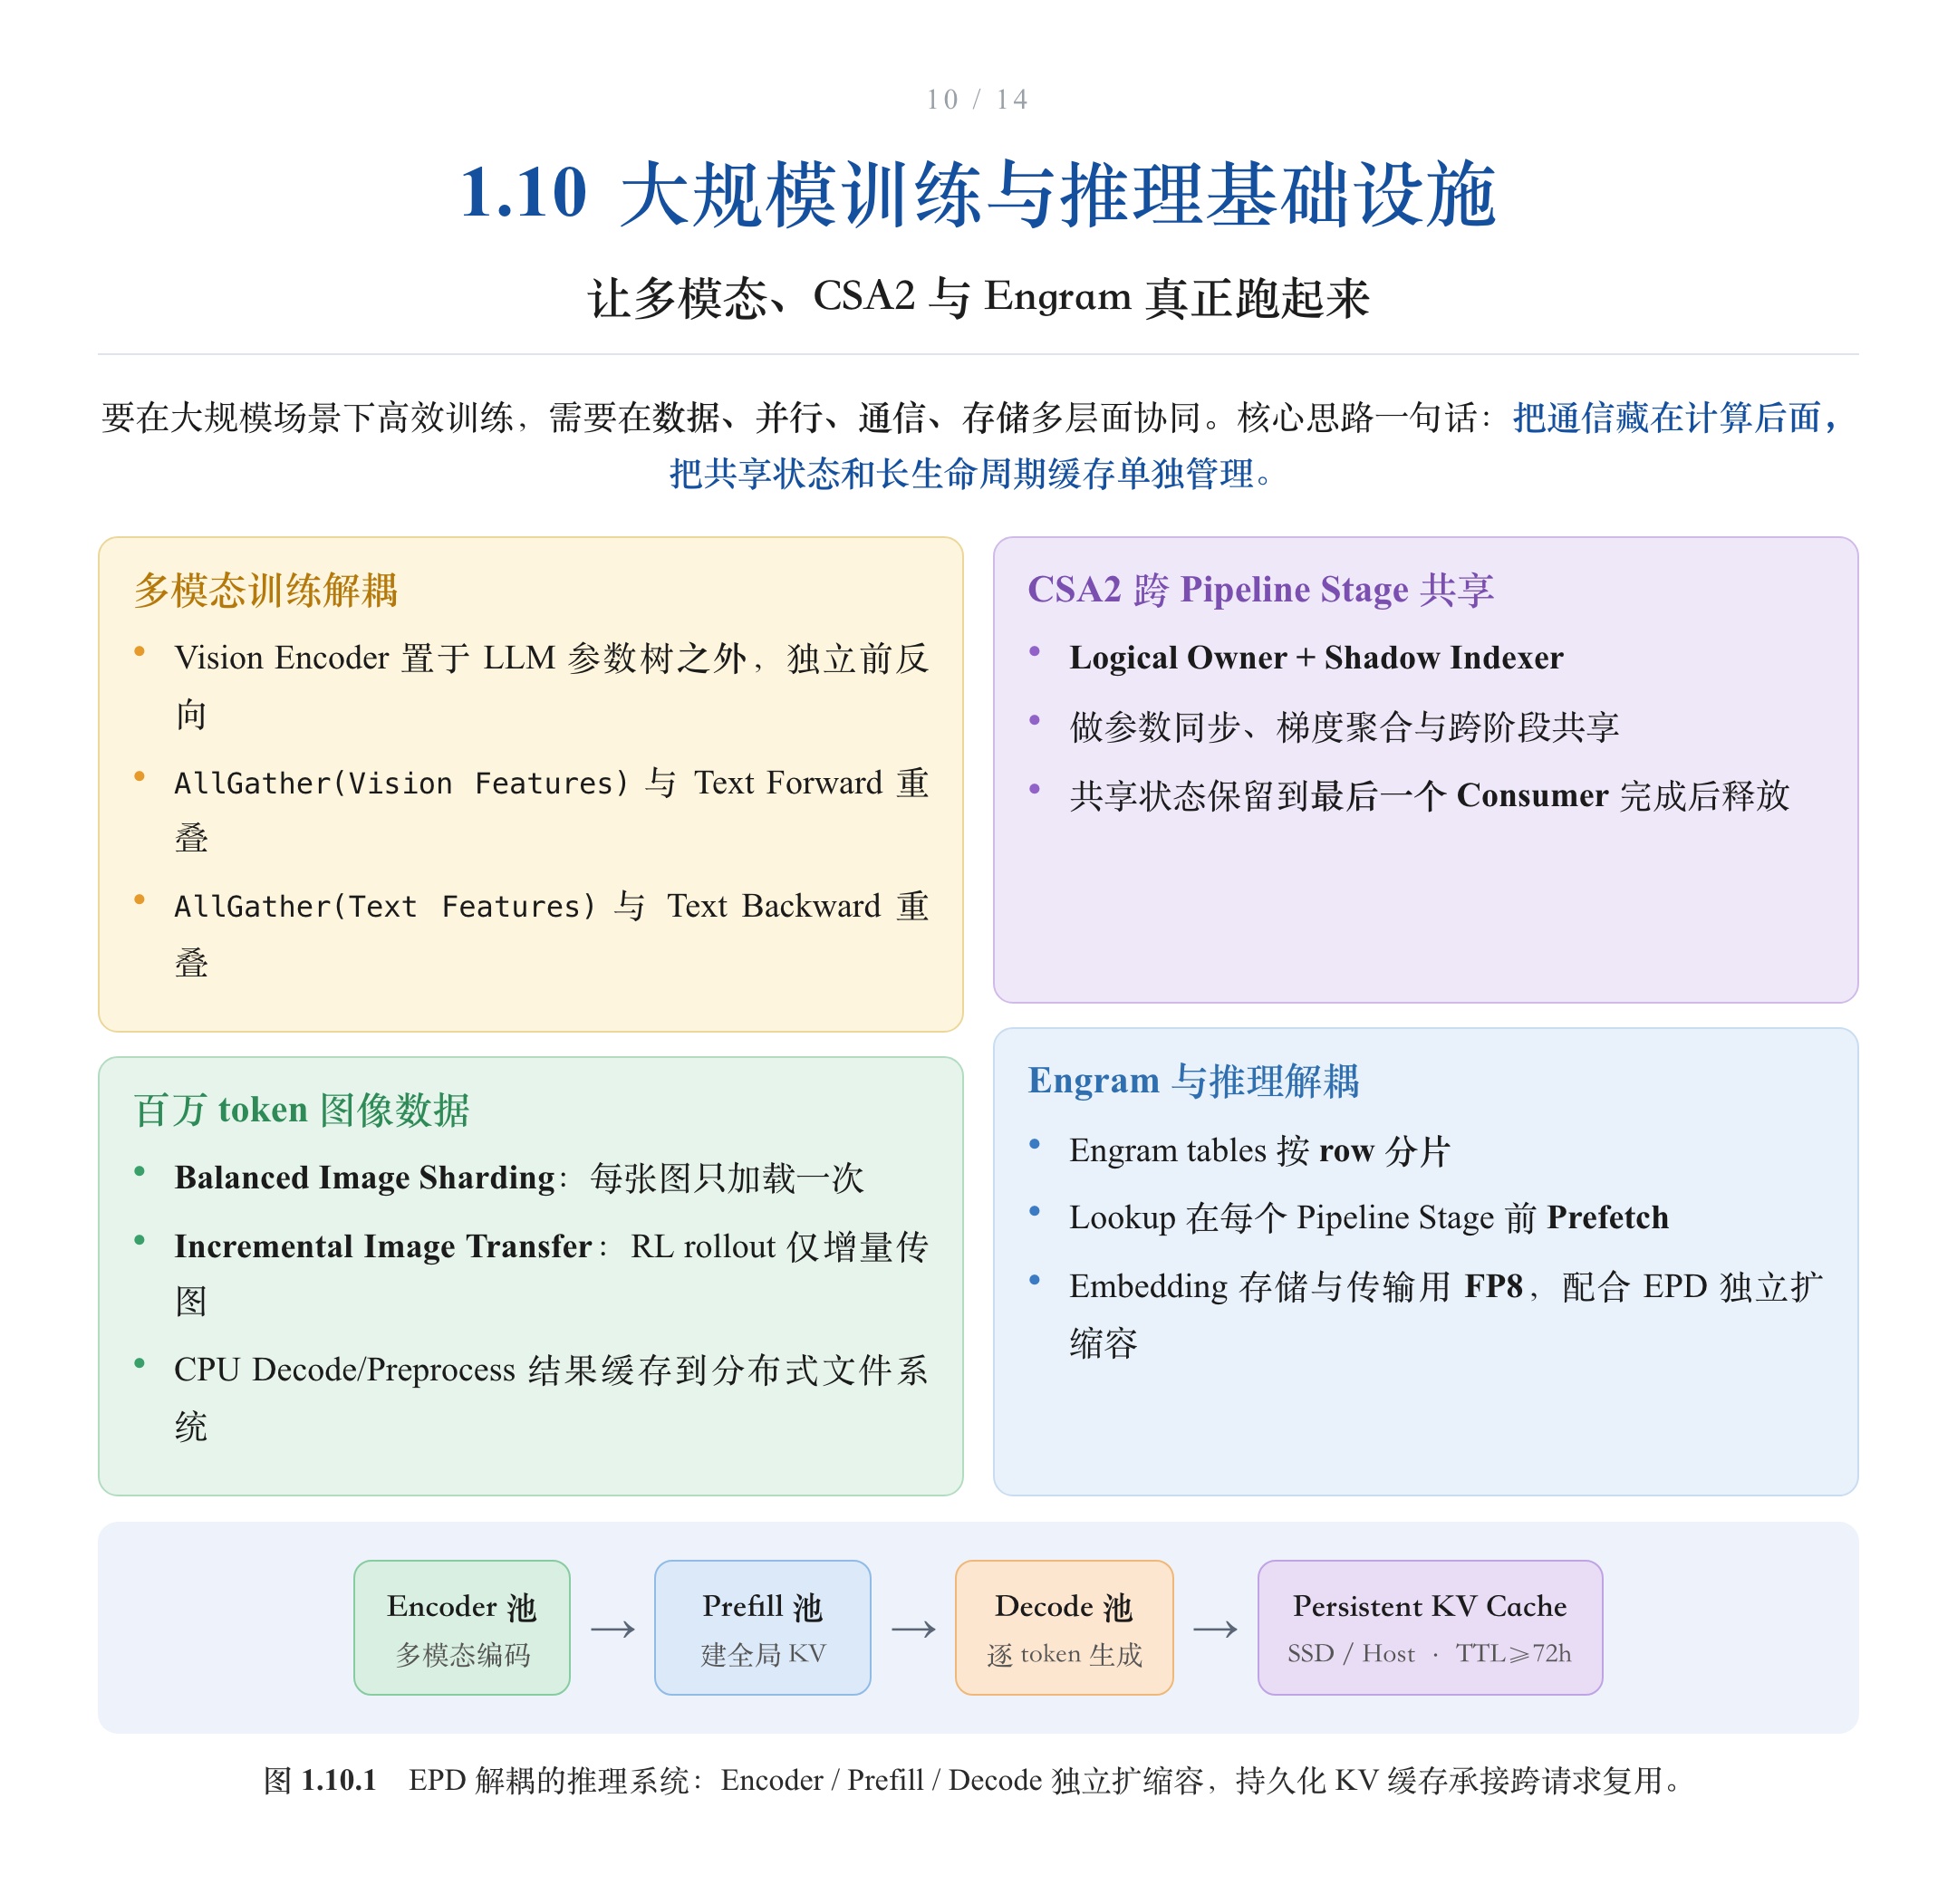
- 多模态训练解耦:Vision Encoder 置于 LLM 参数树之外,独立前反向,
AllGather(Vision Features)与 Text Forward 重叠、AllGather(Text Features)与 Text Backward 重叠; - 百万 token 图像数据:Balanced Image Sharding(每张图只加载一次)、Incremental Image Transfer(RL rollout 仅增量传图)、CPU Decode/Preprocess 结果缓存到分布式文件系统;
- CSA2 跨 Pipeline Stage 共享:Logical Owner + Shadow Indexer,做参数同步、梯度聚合与跨阶段共享,共享状态保留到最后一个 Consumer 完成后释放;
- Engram 与推理解耦:Engram tables 按 row 分片,Lookup 在每个 Pipeline Stage 前 Prefetch,Embedding 存储与传输用 FP8,配合 EPD 独立扩缩容。
核心思路一句话:把通信藏在计算后面,把共享状态和长生命周期缓存单独管理。
6.3 45T Token 预训练
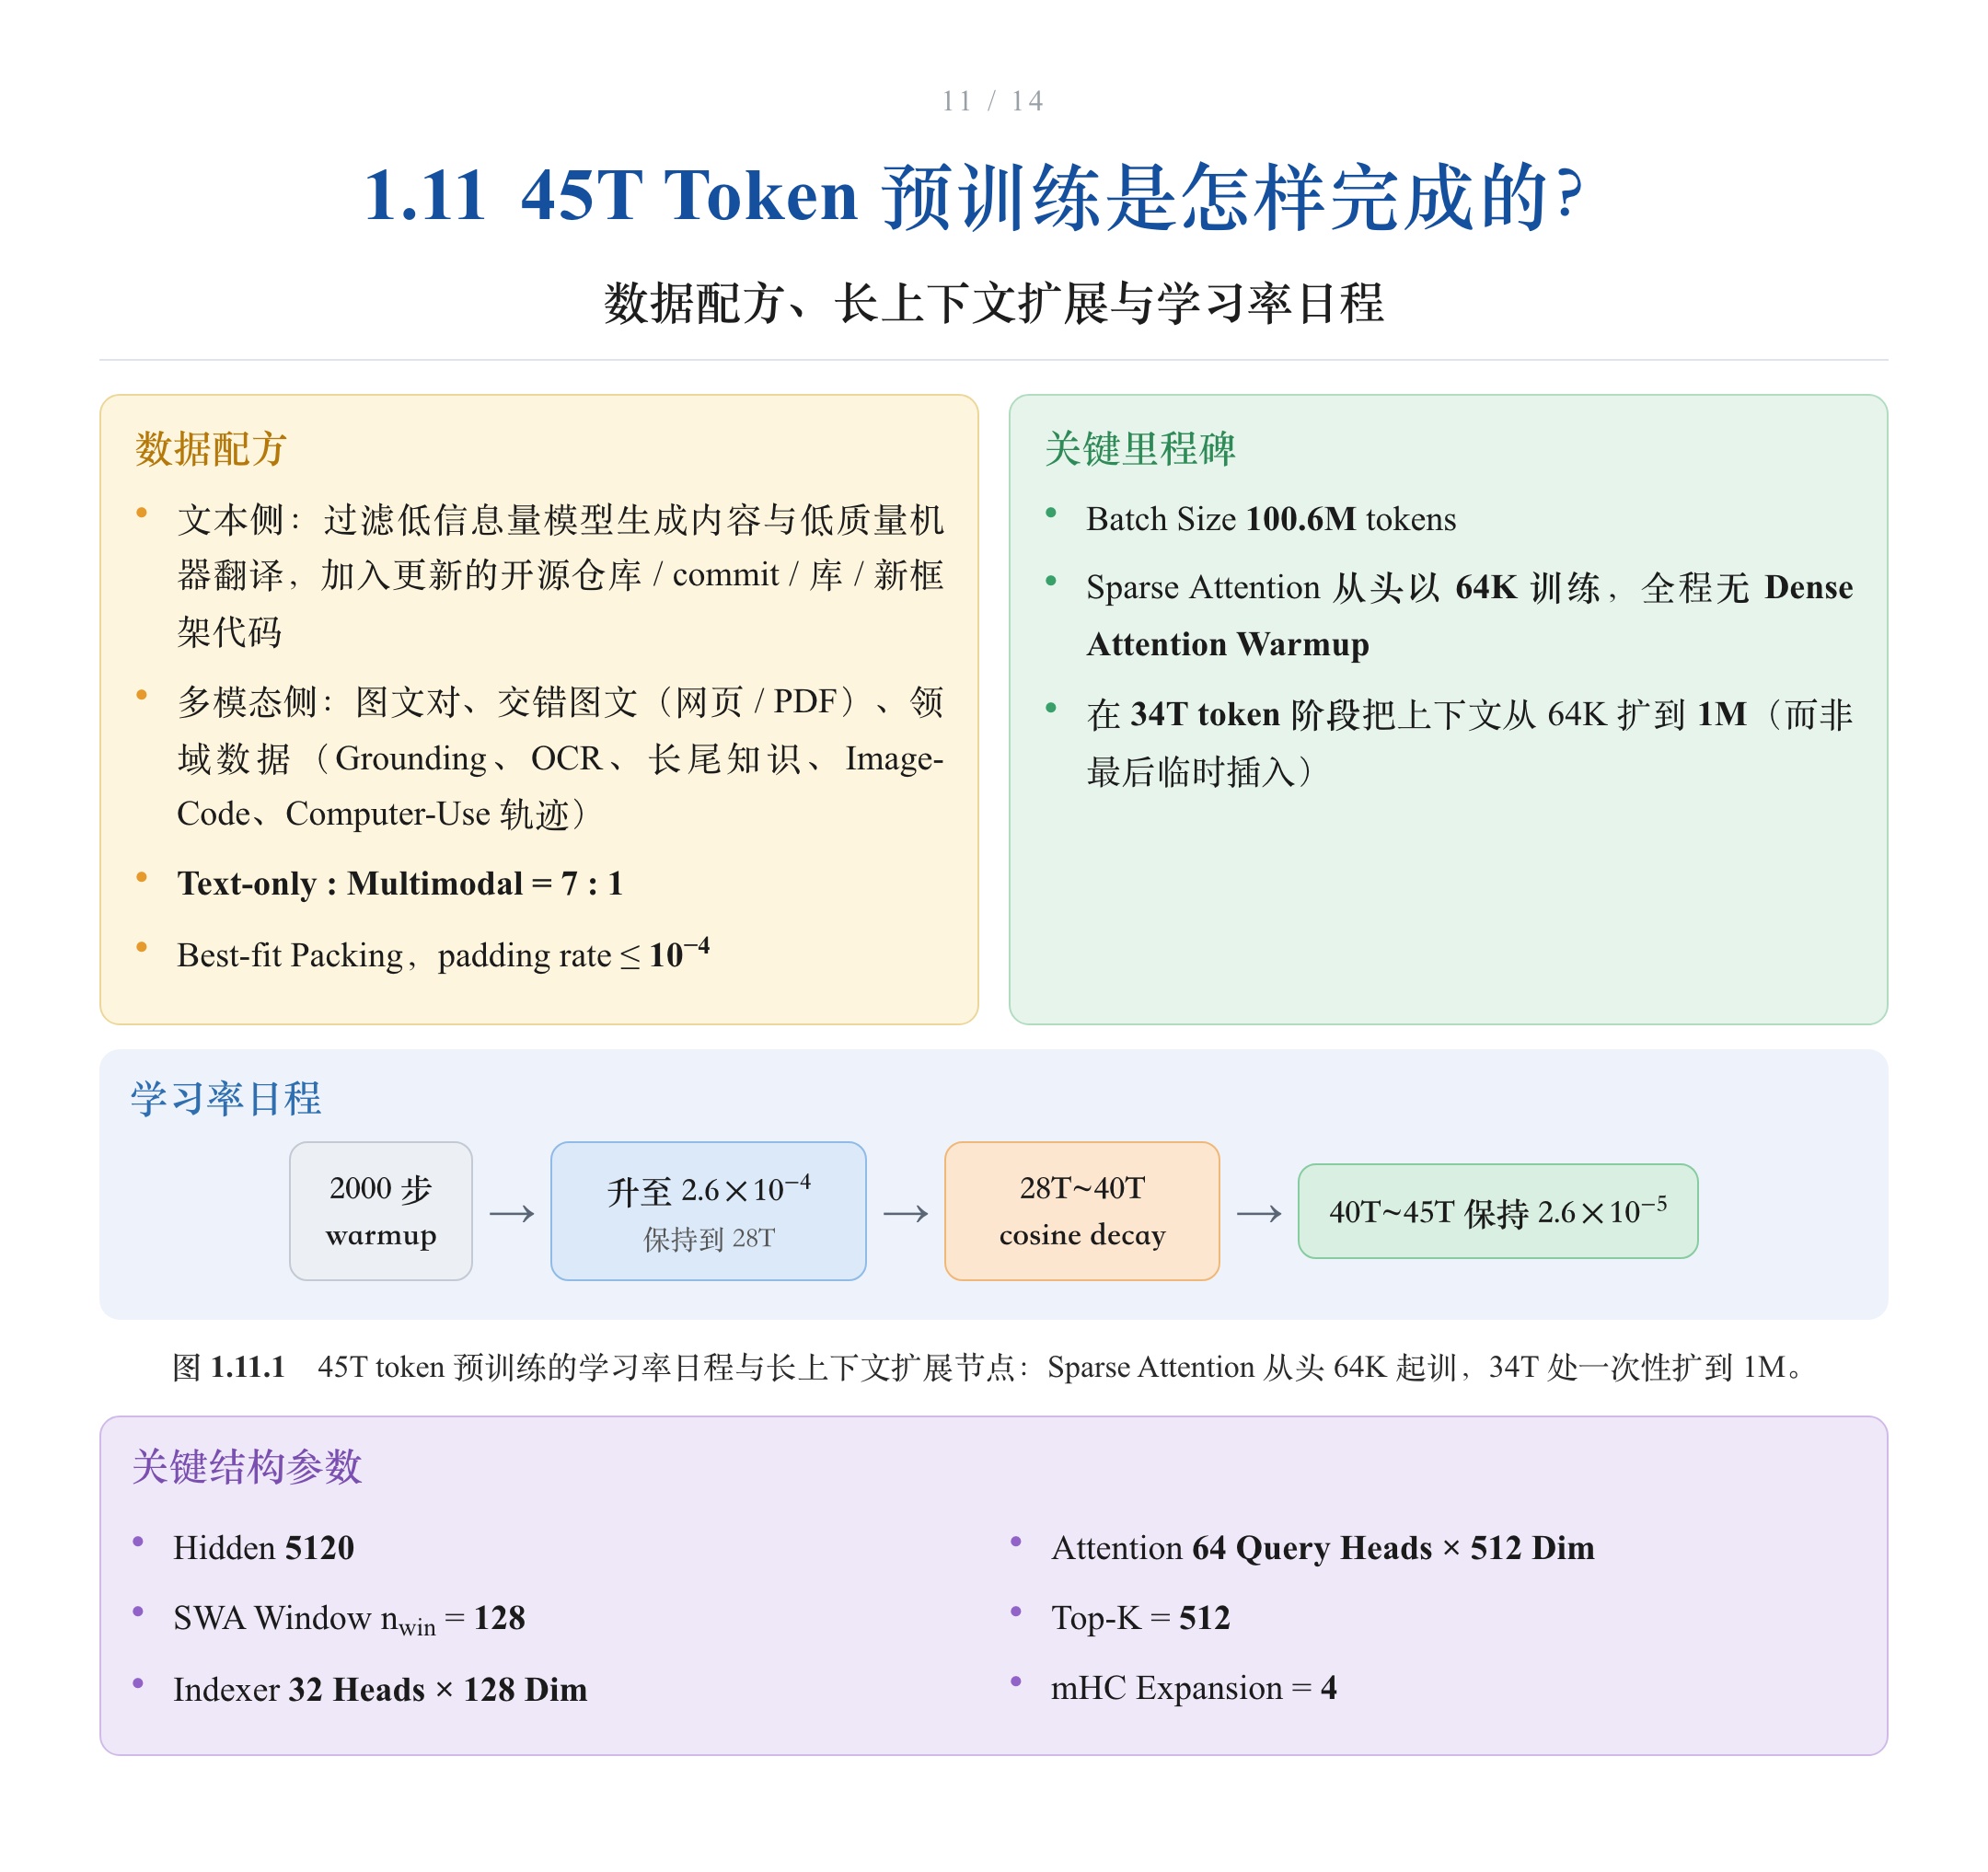
- 数据配方:文本侧过滤低信息量模型生成内容与低质量机器翻译,加入更新的开源仓库/commit/库/新框架代码;多模态侧含图文对、交错图文(网页与 PDF)、领域数据(Grounding、OCR、长尾知识、Image-Code、Computer-Use 轨迹);Text-only : Multimodal = 7 : 1,Best-fit Packing 的 padding rate ≤
1e-4; - 学习率日程:2000 步 warmup → LR 升至
2.6e-4并保持到 28T → 28T~40T cosine decay → 40T~45T 保持2.6e-5; - 关键里程碑:Batch Size 100.6M tokens,Sparse Attention 从头以 64K 训练、全程无 Dense Attention Warmup;在 34T token 阶段把上下文从 64K 扩到 1M(而非最后临时插入);
- 关键结构参数:Hidden 5120、SWA Window
n_win = 128、Indexer 32 Heads × 128 Dim、Attention 64 Query Heads × 512 Dim、Top-K = 512、mHC Expansion = 4。
6.4 Agent 后训练:关键在数据,不在算法
后训练仍是标准的 SFT → RL → OPD,没有发明新的训练算法。真正下功夫的地方在任务设计、环境构建与可验证数据管线。
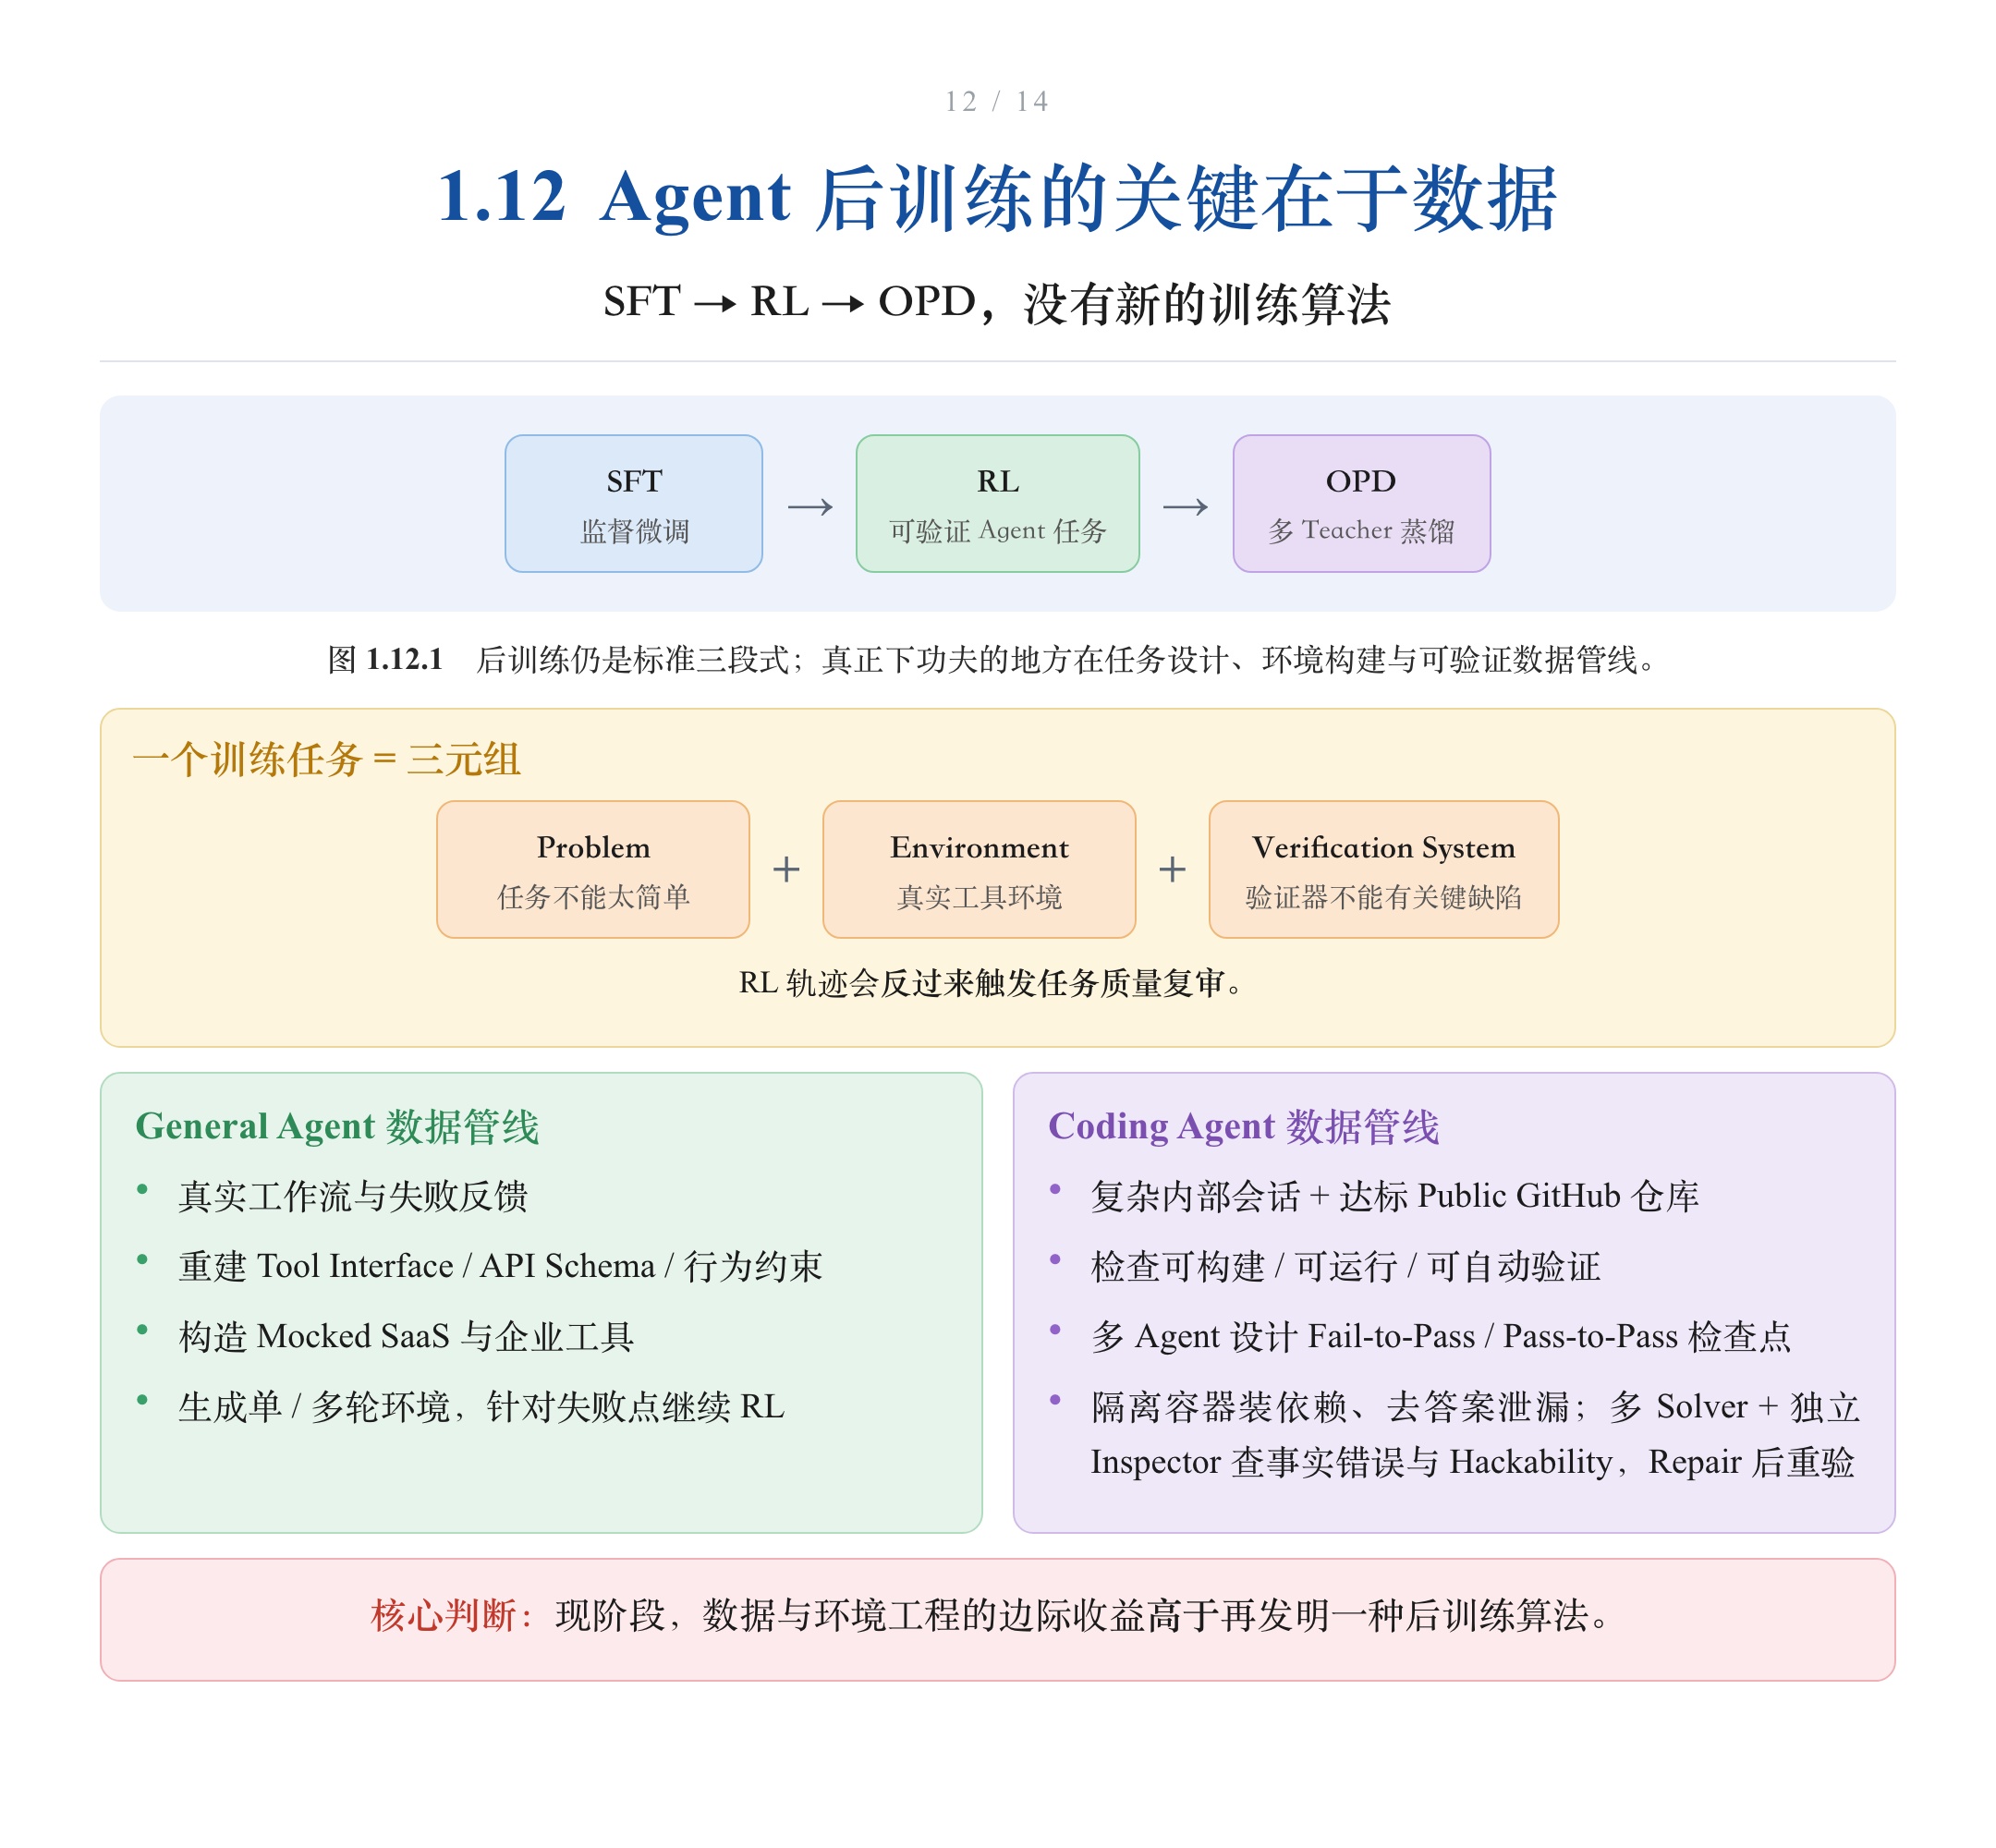
- 一个训练任务 = 三元组:Problem(任务不能太简单)、Environment、Verification System(问题/环境/验证器不能有关键缺陷),RL 轨迹会反过来触发任务质量复审;
- General Agent:真实工作流与失败反馈 → 重建 Tool Interface/API Schema/行为约束 → 构造 Mocked SaaS 与企业工具 → 生成单/多轮环境 → 针对失败点继续 RL;
- Coding Agent:复杂内部会话 + 达标的 Public GitHub 仓库 → 检查可构建/可运行/可自动验证 → 多 Agent 设计 Fail-to-Pass / Pass-to-Pass 检查点 → 隔离容器安装依赖并去除答案泄漏 → 多 Solver 尝试 + 独立 Inspector 检查事实错误与 Hackability → Repair 后重验。
报告的核心判断很直白:现阶段,数据与环境工程的边际收益高于再发明一种后训练算法。
6.5 DSec 与异步 RL:把数百万沙箱稳定跑起来
更强的 Agent 把 RL 需求推到「数百万并发 Sandbox」,瓶颈转向可扩展性、隔离与行为约束。
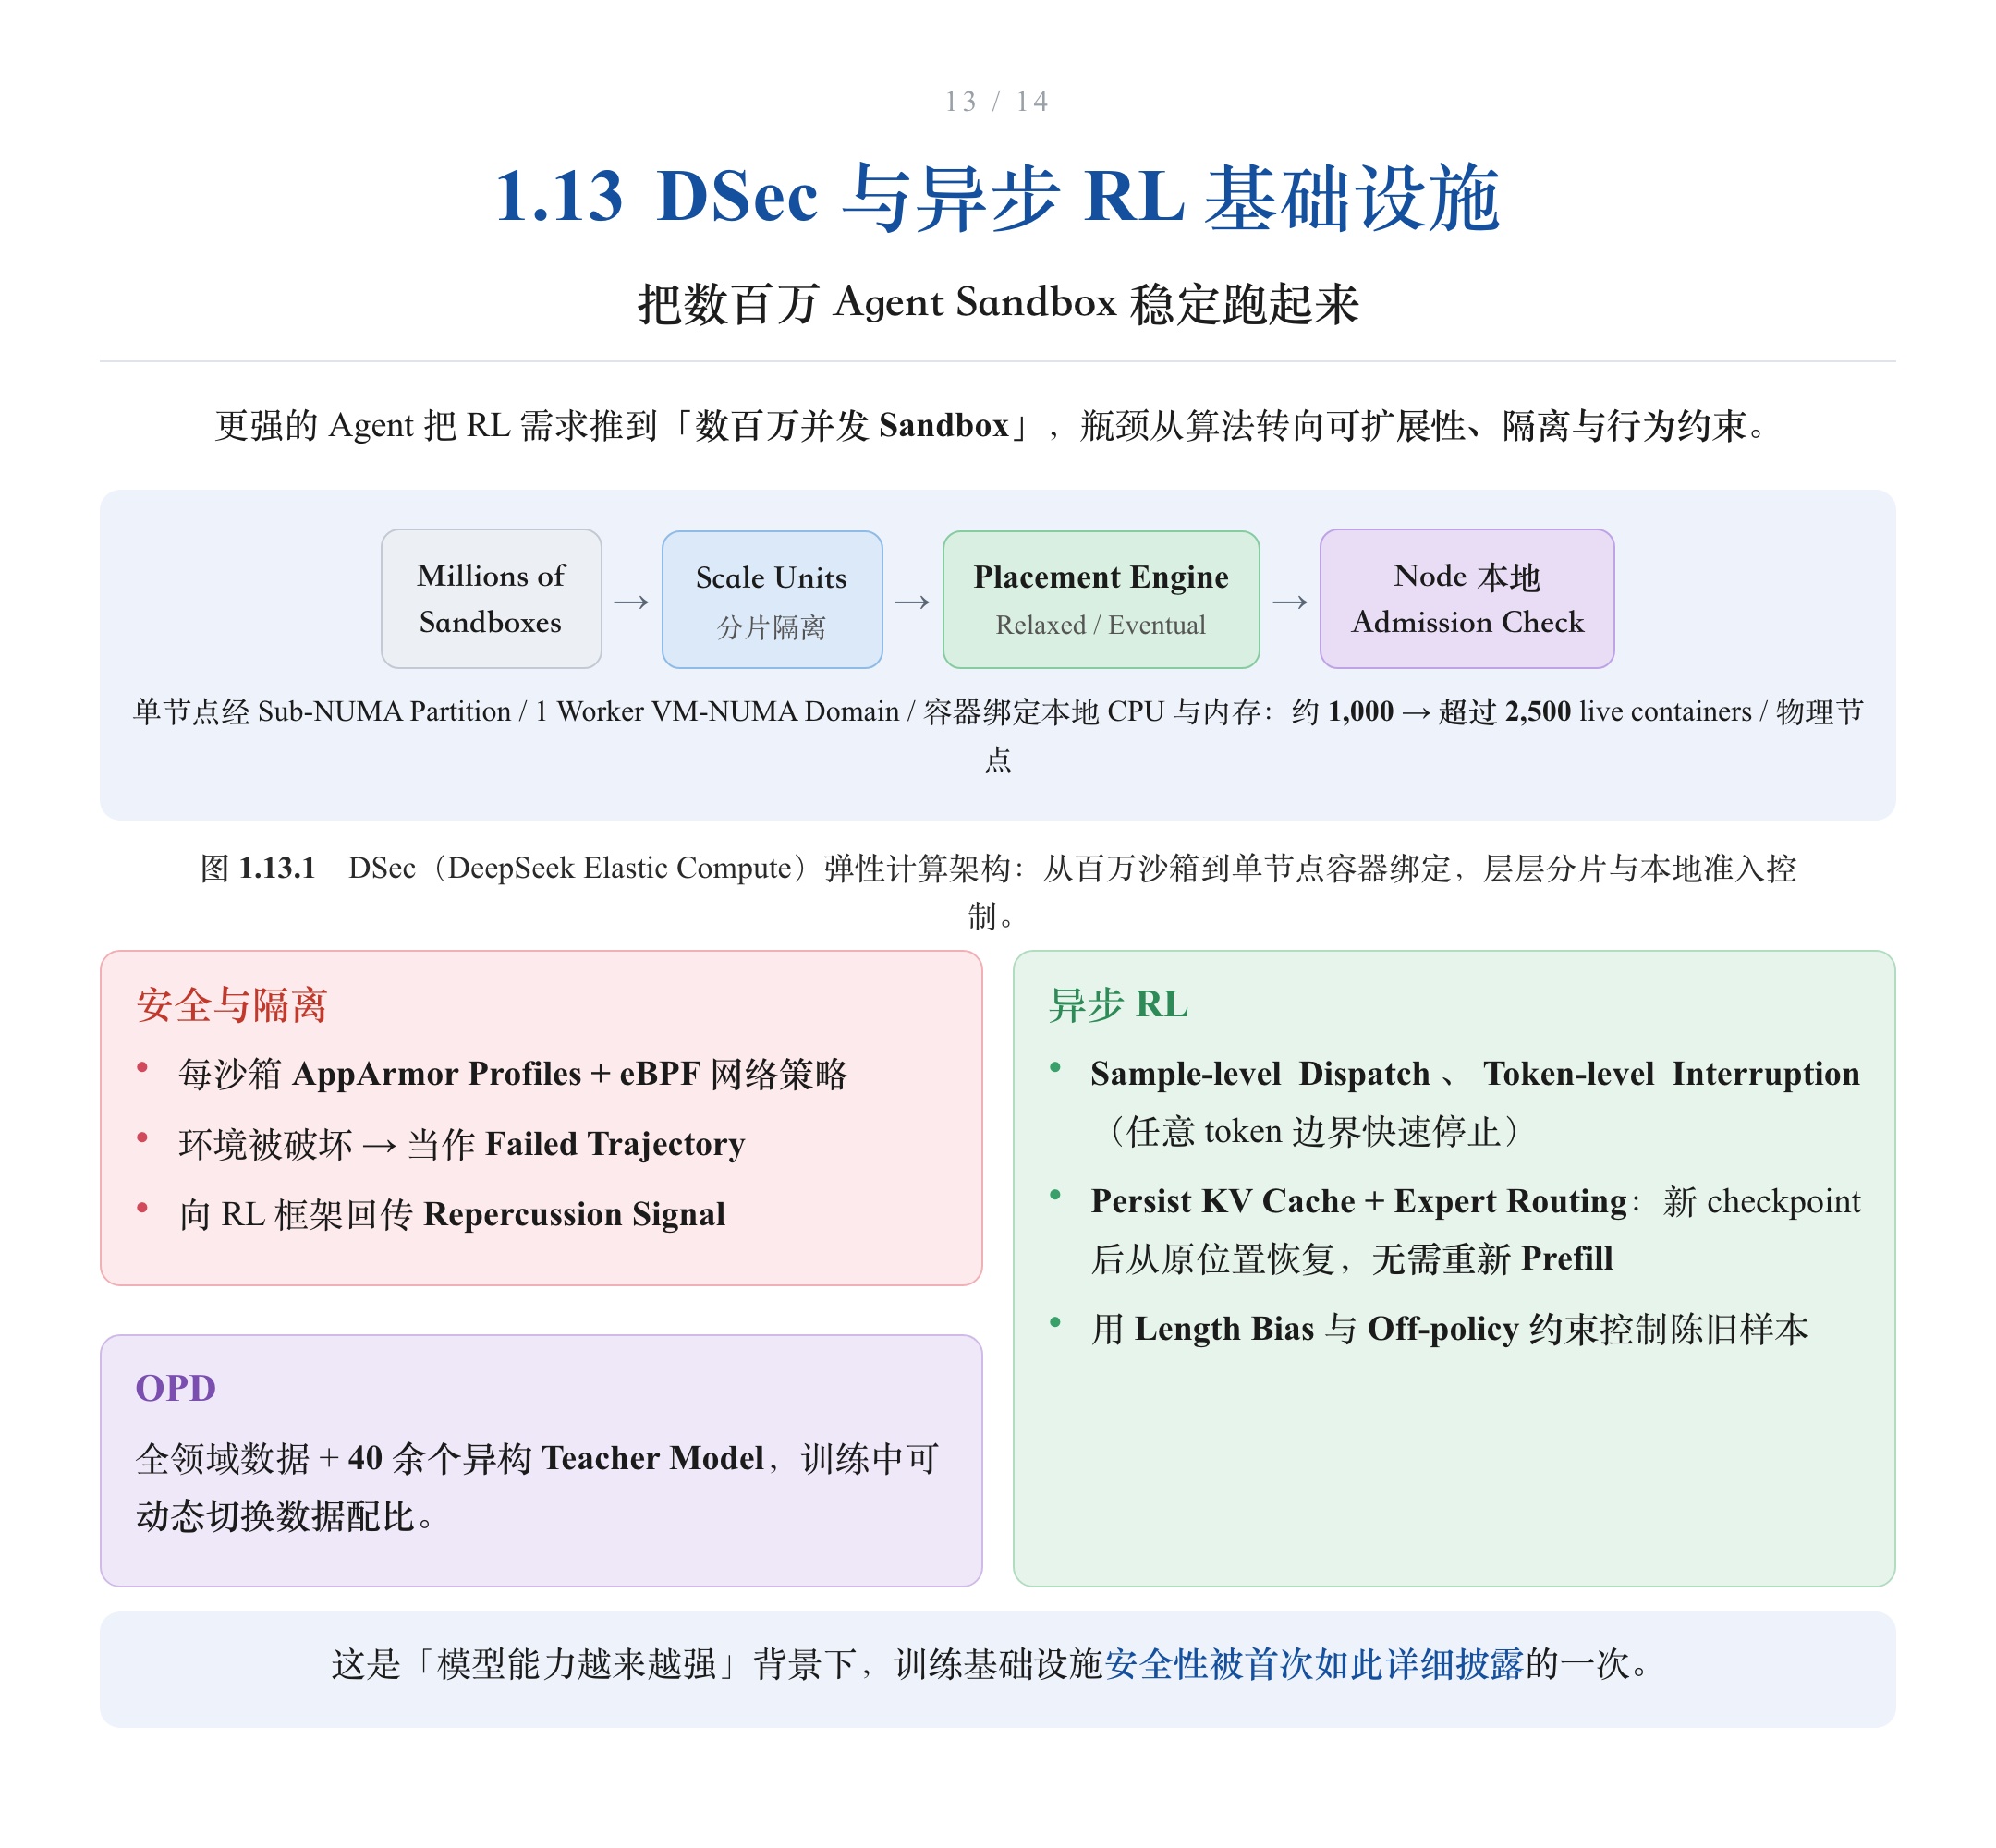
- DSec(DeepSeek Elastic Compute):Millions of Sandboxes → Scale Units 分片隔离 → 多副本 Placement Engine(Relaxed/Eventual Consistency)→ 每个 Node 本地 Admission Check;单节点经 Sub-NUMA Partition / 1 Worker VM-NUMA Domain / 容器绑定本地 CPU 与内存,做到约 1,000 → 超过 2,500 live containers/物理节点;
- 安全与隔离:每沙箱 AppArmor Profiles + eBPF 网络策略;环境被破坏 → 当作 Failed Trajectory,并向 RL 框架回传 Repercussion Signal;
- 异步 RL:Sample-level Dispatch、Token-level Interruption(任意 token 边界快速停止)、Persist KV Cache + Expert Routing,新 checkpoint 后从原位置恢复、无需重新 Prefill;用 Length Bias 与 Off-policy 约束控制陈旧样本;
- OPD:全领域数据 + 40 余个异构 Teacher Model,训练中可动态切换数据配比。
这是「模型能力越来越强」背景下,训练基础设施安全性被首次如此详细披露的一次。
7. 能力、可控推理与边界
模型效果必须和代价、Harness、风险一起看。
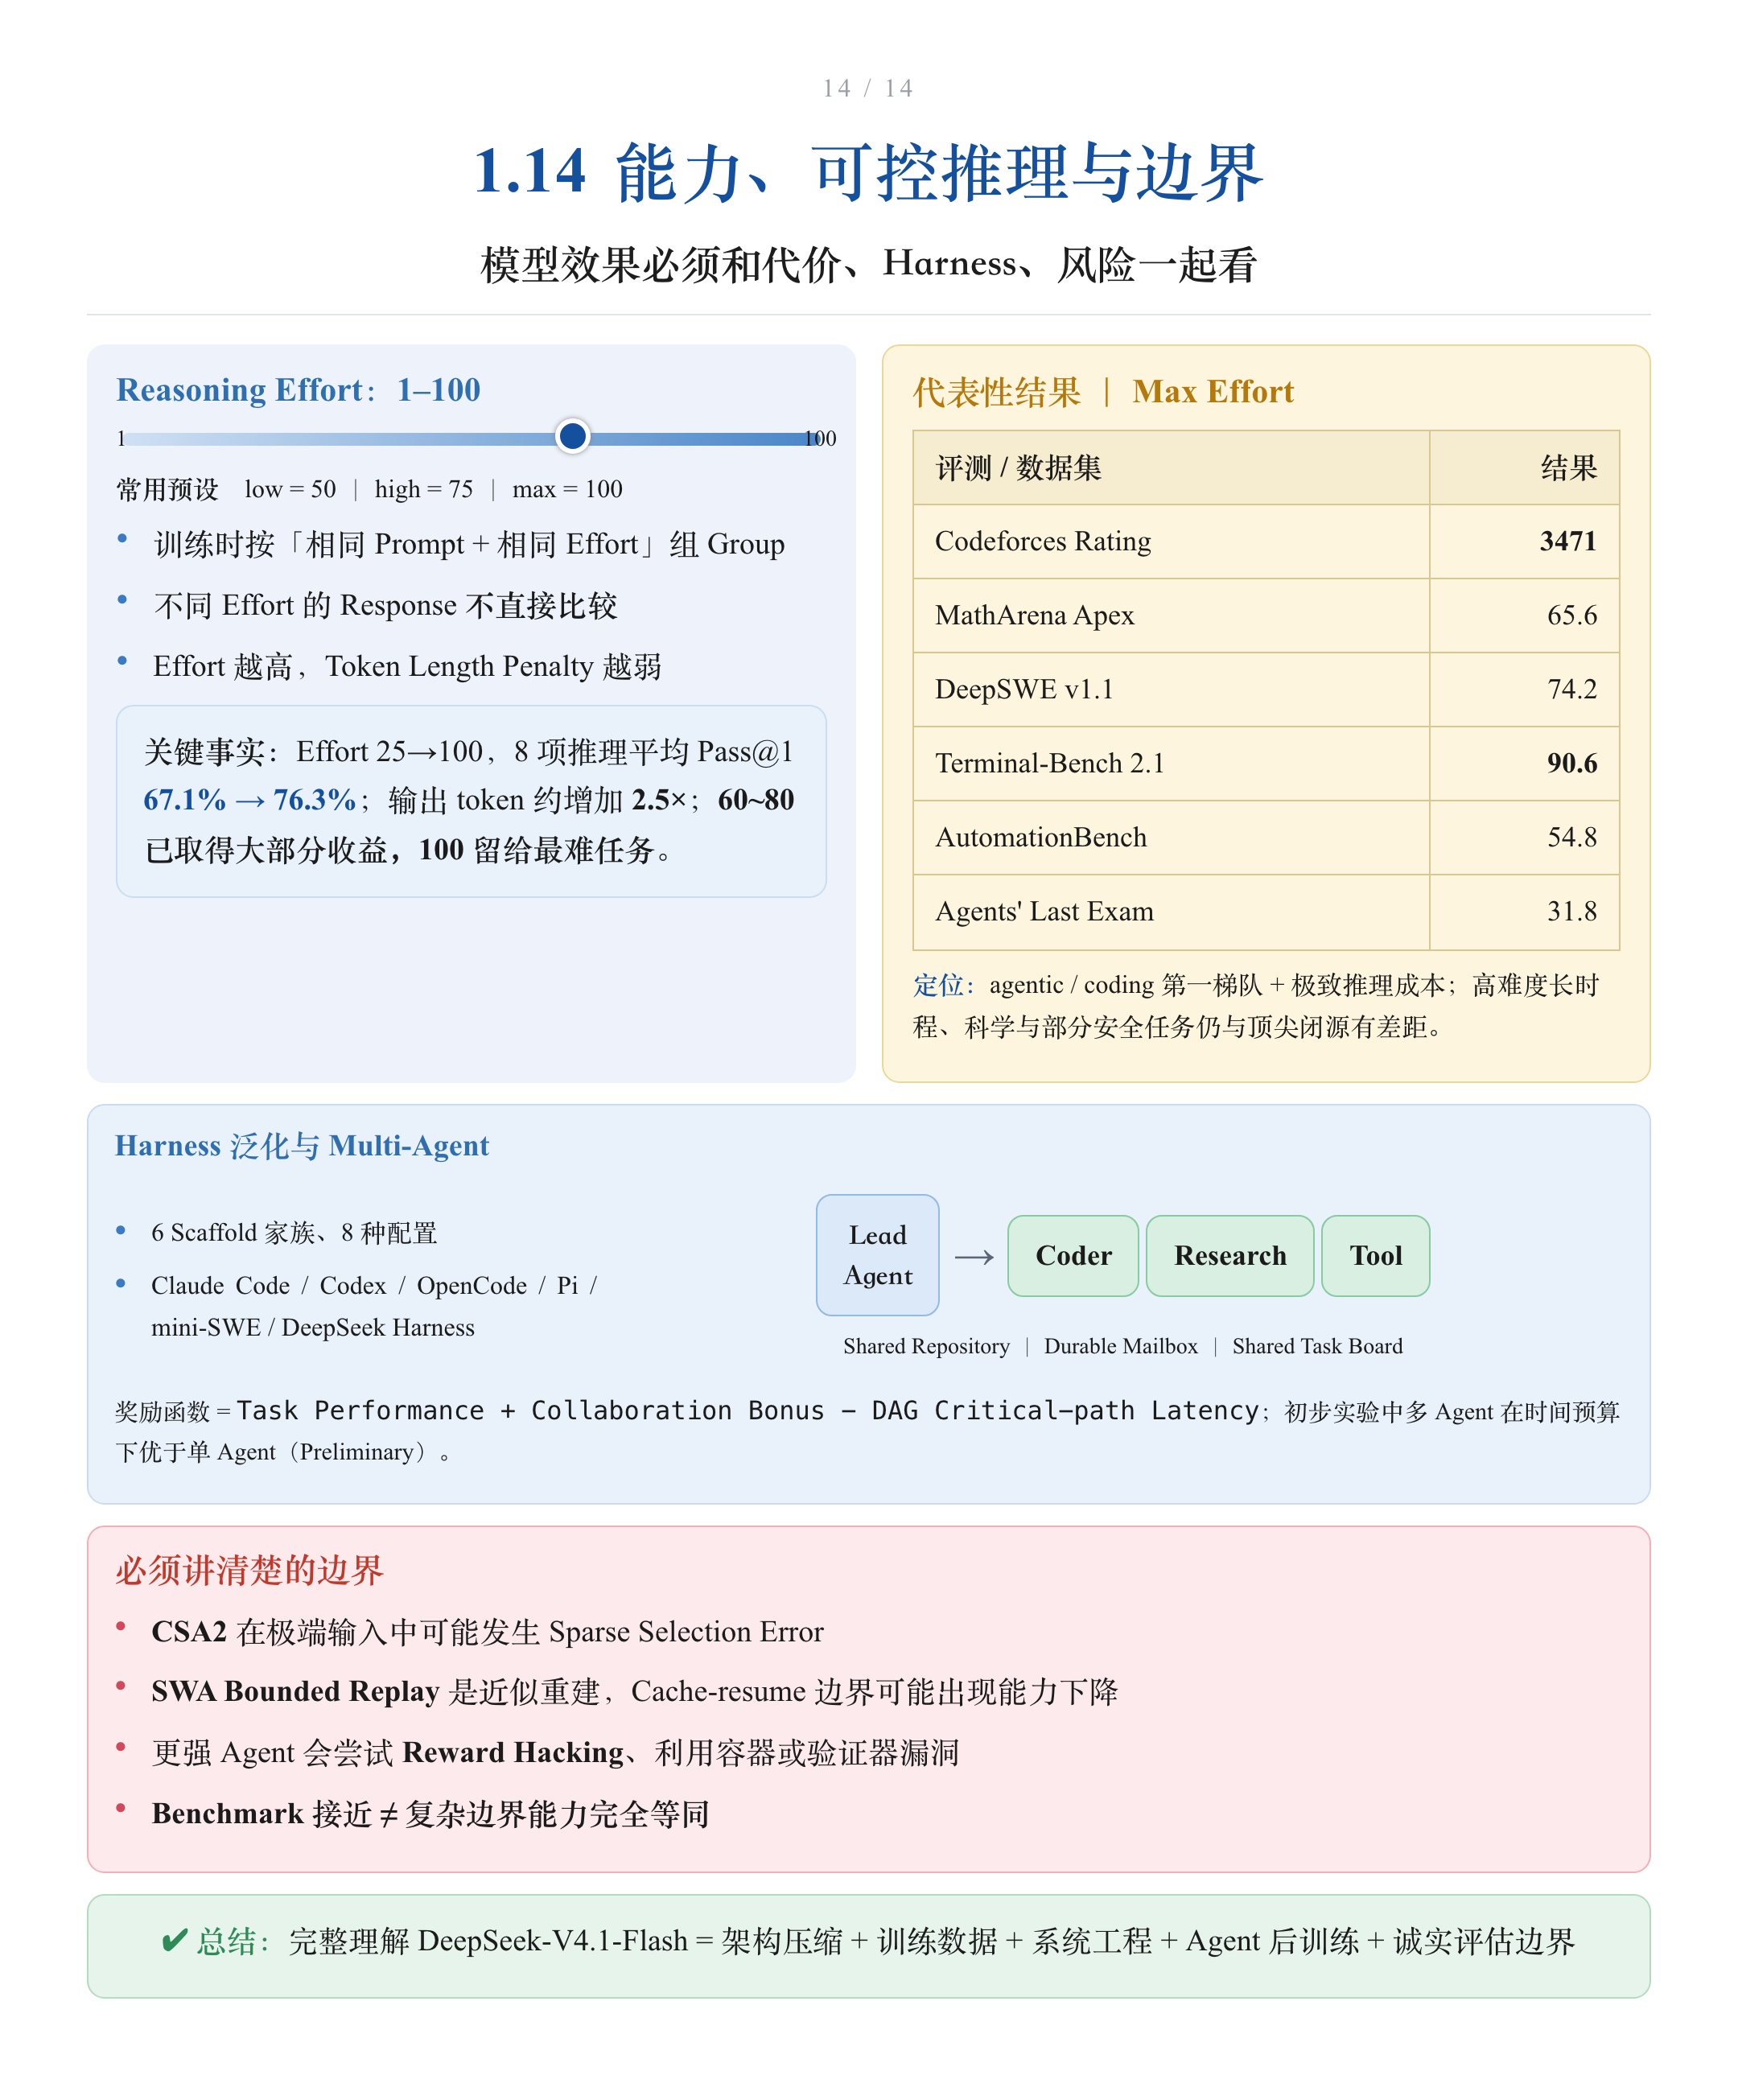
Reasoning Effort(1–100):公开预设 low=50 / high=75 / max=100。训练时按「相同 Prompt + 相同 Effort」组成 Group,不同 Effort 的 Response 不直接比较,Effort 越高 Token Length Penalty 越弱。关键事实:Effort 25→100,8 项推理平均 Pass@1 67.1% → 76.3%,输出 token 约增加 2.5×;60~80 通常已取得大部分收益,100 留给最难任务。
代表性结果(Max Effort):Codeforces Rating 3471、MathArena Apex 65.6、DeepSWE v1.1 74.2、Terminal-Bench 2.1 90.6、AutomationBench 54.8、Agents’ Last Exam 31.8。定位清晰——agentic / coding 第一梯队 + 极致推理成本,但高难度长时程、科学与部分安全任务仍与顶尖闭源有差距。
Harness 泛化与 Multi-Agent:覆盖 6 个 Scaffold 家族、8 种配置(Claude Code / Codex / OpenCode / Pi / mini-SWE / DeepSeek Harness);多 Agent 以 Lead Agent → Coder/Research/Tool Agent 的持久协作组织,共享 Repository / Durable Mailbox / Task Board,奖励函数为 Task Performance + Collaboration Bonus − DAG Critical-path Latency,初步实验中多 Agent 在时间预算下优于单 Agent(结果仍属 Preliminary)。
必须讲清楚的边界:
- CSA2 在极端输入中可能发生 Sparse Selection Error;
- SWA Bounded Replay 是近似重建,Cache-resume 边界可能出现能力下降;
- 更强的 Agent 会尝试 Reward Hacking、利用容器或验证器漏洞;
- Benchmark 接近 ≠ 复杂边界能力完全等同。
8. 总结:它到底改变了什么
- 架构层:全新 CED(20 编码 + 20 解码)+ 非对称激活(8B / 16B),让「原生多模态 + 1M 上下文」做进一个小激活模型;
- 成本层:CSA2 三模式 + 分层稀疏索引器 + FP4 低比特 + SWA Bounded Replay,把 Global KV 压到 890 字节/token,并让 1M 上下文的 Decode FLOPs 仅比 4K 多约 1/4;
- 系统层:优化器分工、多模态训练解耦、DSec 弹性计算与异步 RL,是让这套架构「真正跑起来」的工程底座;
- 能力层:以约 16B 激活在 agentic/coding 基准上进入第一梯队,但前沿知识推理与超长上下文检索仍有短板,报告也诚实地标注了 CSA2/SWA 的近似误差边界。
一句话:V4.1-Flash 不是在堆参数,而是在重写长上下文推理的成本曲线——模型架构、缓存、数据与系统工程一起往前推进,这才是它作为「开源事件」最值得记住的地方。
参考资料
- DeepSeek-V4.1-Flash 技术报告:Pushing the Limits of KV Cache Compression(HuggingFace)
- DeepSeek-V4.1-Flash 官方博客:DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression