0. 为什么要聊算力
大模型这两年把「算力」这个词彻底推到了台前。买卡要看算力、租云要看算力、做集群规划还是看算力。但很多人看到 NVIDIA 官网写着 B200「20 PFLOPS」、华为昇腾 910B「320 TFLOPS」,往往一头雾水:
- PFLOPS、TFLOPS 到底是多大?
- 为什么同一张卡,官方会给出一堆不同的算力数字?
- FP32、FP16、FP8、FP4 这些「精度」和算力有什么关系?
- 昇腾和英伟达的卡,到底怎么比才算公平?
这篇文章就用尽量通俗的方式把这几件事讲清楚。核心结论先放在这里:算力数字离不开精度这个前提,脱离精度谈算力都是耍流氓。
1. FLOPS 是什么:先把单位讲清楚
FLOPS = FLoating-point Operations Per Second,即每秒能做多少次浮点运算。一次乘法、一次加法都算一次浮点运算。
算力数字动辄天文数字,所以工程上用词头(SI 前缀)来简化:
- 1 KFLOPS = 10³ FLOPS(千)
- 1 MFLOPS = 10⁶ FLOPS(百万)
- 1 GFLOPS = 10⁹ FLOPS(十亿)
- 1 TFLOPS = 10¹² FLOPS(万亿)—— T = Tera
- 1 PFLOPS = 10¹⁵ FLOPS(千万亿)—— P = Peta
- 1 EFLOPS = 10¹⁸ FLOPS(百亿亿)—— E = Exa
换算关系很简单,每级差 1000 倍:
1 PFLOPS = 1000 TFLOPS = 10⁶ GFLOPS
打个直观的比方:如果全球 80 亿人每人每秒能算 1 道加法题,全人类加起来大约是 8 GFLOPS。而一张 B200 在 FP4 精度下的峰值是 20 PFLOPS,相当于约 250 万个「全人类」同时开算。这就是现代 AI 加速卡的量级。
顺带一提:衡量整数运算能力时用的是 TOPS / POPS(Operations Per Second),常见于 INT8 量化推理场景。单位换算规则和 FLOPS 一样。
2. 精度:为什么同一张卡有好几个算力数字
这是最容易被忽略、也最关键的一点。同一张芯片,在不同数值精度下的峰值算力可以差好几倍甚至十几倍。
原因在于:芯片里的乘加运算单元处理的「数」是有位宽的。位宽越窄,单位硅片面积、单位时钟周期里能塞进去、并行处理的运算就越多,算力自然越高。
2.1 常见浮点格式
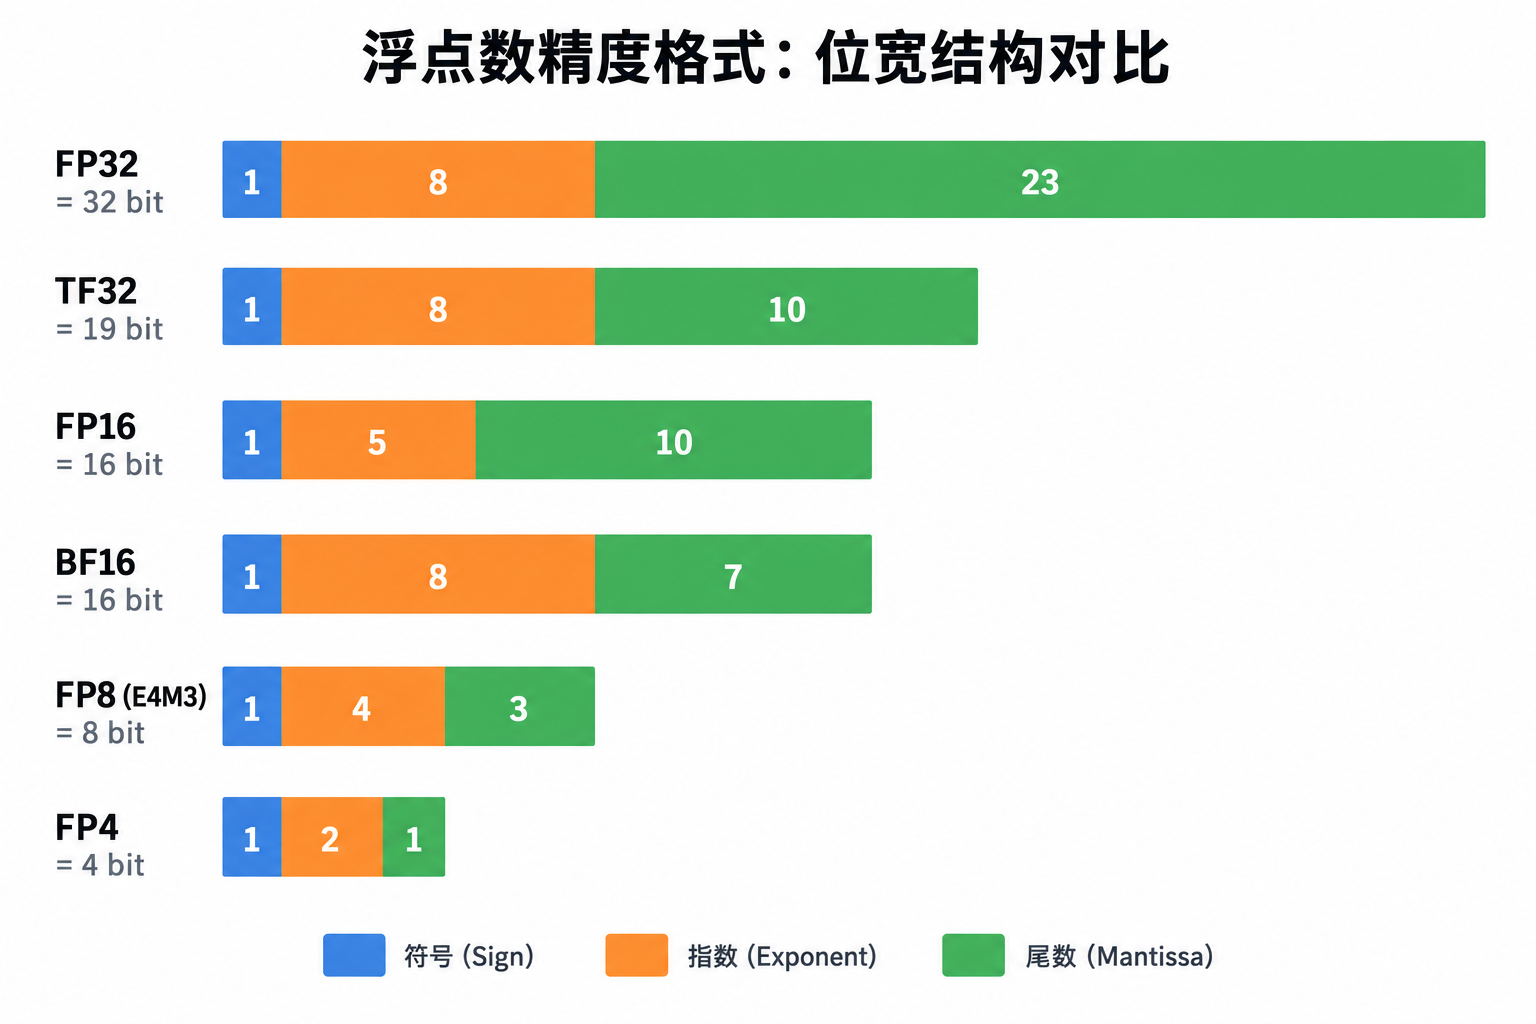
浮点数由三部分组成:符号位(sign)、指数位(exponent,决定能表示的范围)、尾数位(mantissa,决定精度)。
- FP32(单精度,32 位):1 符号 + 8 指数 + 23 尾数。传统科学计算、CPU 计算的标准格式,精度高、范围大,但又慢又占显存。
- TF32(TensorFloat-32,NVIDIA 专有,实际 19 位):保留 FP32 的 8 位指数范围,但把尾数砍到 10 位。是 NVIDIA 为深度学习设计的「以精度换速度」格式。
- FP16(半精度,16 位):1 + 5 + 10。范围较小,容易溢出,训练时常需配合 Loss Scaling。
- BF16(bfloat16,16 位):1 + 8 + 7。保留了 FP32 的 8 位指数范围(不易溢出),牺牲尾数精度,是当前大模型训练的主流格式。
- FP8(8 位):有 E4M3 和 E5M2 两种变体。Hopper(H100)之后开始硬件支持,是大模型训练/推理降本的关键。
- FP4(4 位):Blackwell(B200)新增,配合 MX(microscaling)分块缩放技术,主要用于推理,能在可接受的精度损失下把吞吐再翻倍。
2.2 一句话记住取舍
位宽越高 → 精度越高、范围越大、算得越准,但越慢、越占显存。
位宽越低 → 算力越高、显存占用越小、越省电,但精度损失越大。
所以工程上的做法是「按需选精度」:
- 科学计算 / HPC:必须 FP64/FP32。
- 大模型训练:主力 BF16,梯度/激活可用 FP8 加速。
- 大模型推理:FP8、FP4、INT8 量化,用尽量低的精度换吞吐和成本。
3. NVIDIA 举例:H100 与 B200
先看英伟达。以下为单卡(SXM)理论峰值算力,Tensor Core 指张量核心,是深度学习矩阵乘法的主力单元。
3.1 H100(Hopper 架构,2022)
| 精度 | 峰值算力 | 说明 |
|---|---|---|
| FP64(非 Tensor) | 34 TFLOPS | 传统科学计算 |
| FP64 Tensor Core | 67 TFLOPS | HPC 场景 |
| FP32 | 67 TFLOPS | 通用单精度 |
| TF32 Tensor Core | 989 TFLOPS | 稀疏,稠密约 495 |
| FP16 / BF16 Tensor Core | 1979 TFLOPS(~2 PFLOPS) | 稀疏,稠密约 989 |
| FP8 Tensor Core | 3958 TFLOPS(~4 PFLOPS) | 稀疏,稠密约 1979 |
| FP4 | — | Hopper 不支持 |
可以看到:从 FP16 到 FP8,算力直接翻倍(1979 → 3958),这正是「降精度换算力」的直接体现。H100 没有 FP4 硬件单元。
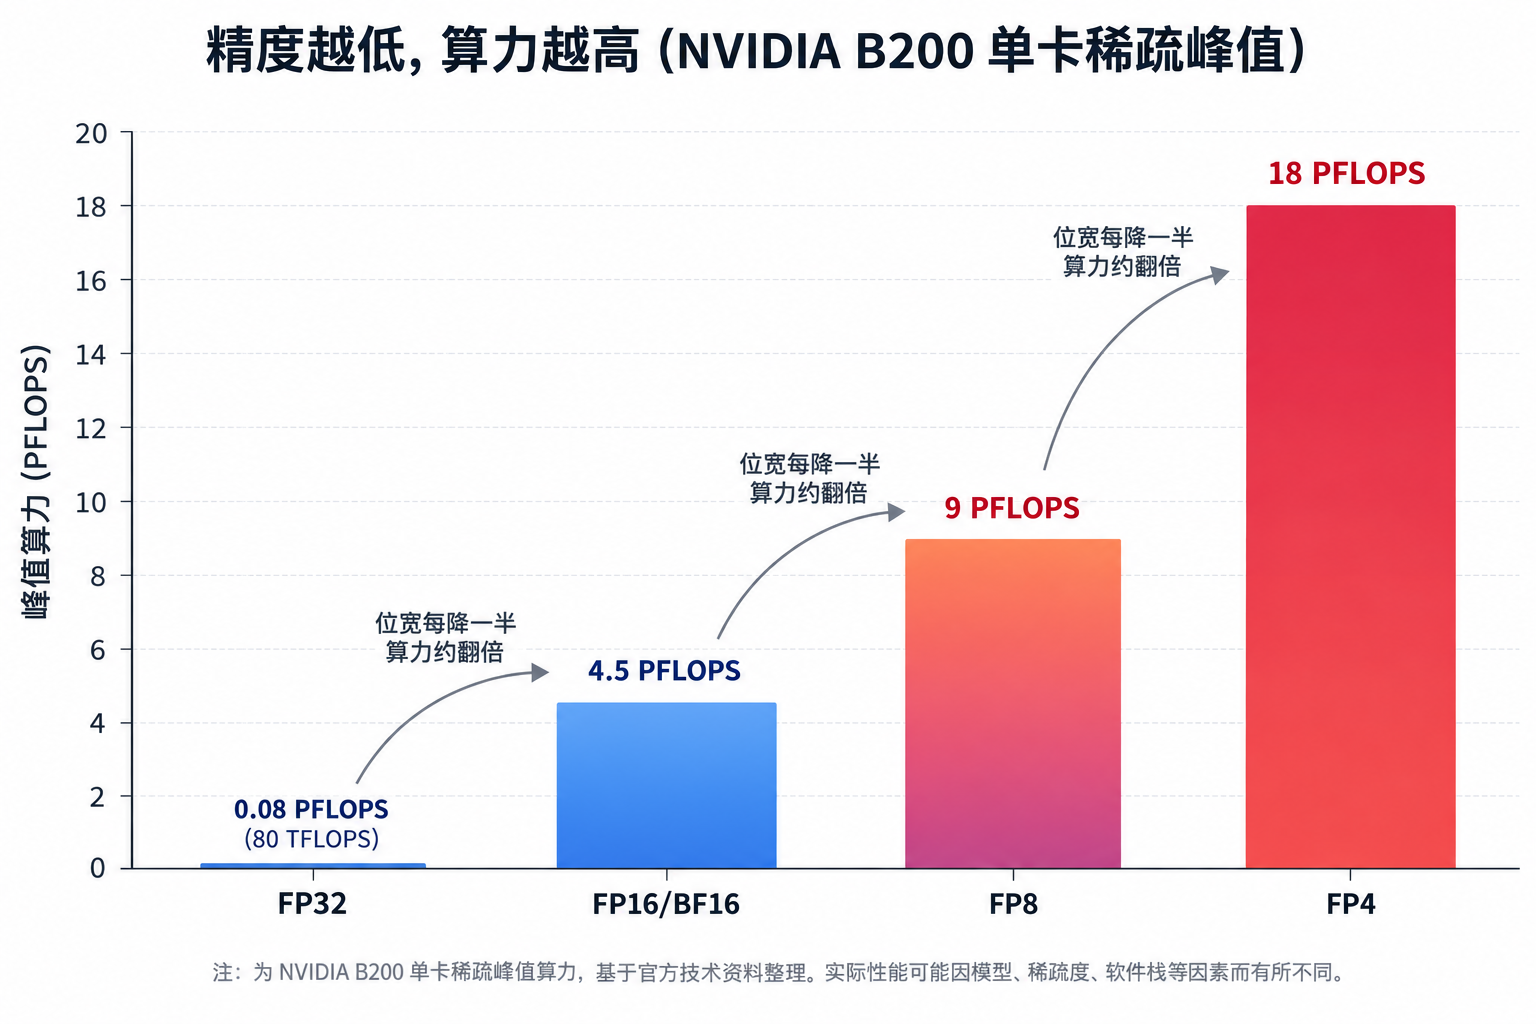
3.2 B200(Blackwell 架构,2024)
| 精度 | 峰值算力(稠密 / 稀疏) | 说明 |
|---|---|---|
| FP64 Tensor Core | 40 TFLOPS | HPC 明显被弱化 |
| FP32 | 80 TFLOPS | 通用单精度 |
| TF32 Tensor Core | 2.5 / — PFLOPS | |
| FP16 / BF16 Tensor Core | 2.25 / 4.5 PFLOPS | |
| FP8 / FP6 Tensor Core | 4.5 / 9 PFLOPS | |
| FP4 Tensor Core | 9 / 18(部分资料标 20)PFLOPS | Blackwell 新增,推理利器 |
注:NVIDIA 官方 Blackwell Datasheet 给出的单卡整数常见为 FP4 20 PFLOPS、FP8 10 PFLOPS、FP16 5 PFLOPS,这是含稀疏并做了取整的口径;上表以更细的稠密/稀疏拆分呈现,两者并不矛盾,只是统计口径不同。这也是看算力数字时最容易踩的坑。
Blackwell 的核心变化:新增 FP4,把推理吞吐相对 FP8 再翻倍(9 → 18 PFLOPS 稀疏),同时把 FP64 的 HPC 算力大幅削减——因为它就是一颗为 AI 推理/训练而生的芯片。
4. 华为昇腾举例:910B 与 910C
再看国产算力的代表华为昇腾。需要特别说明:昇腾的官方精细算力表不像英伟达那样完全公开,以下数字来自公开产品资料与业界估测,仅供量级参考。
4.1 昇腾 910B(达芬奇架构,SMIC N+1 工艺)
910B 按规格分为 B1/B2/B3/B4 多个子型号,算力有差异:
| 子型号 | FP16 / BF16 | INT8 | 显存 | 定位 |
|---|---|---|---|---|
| 910B1 | ~414 TFLOPS | ~828 TOPS | 64GB HBM2e | 训练(满血) |
| 910B2 | ~376 TFLOPS | ~752 TOPS | 64GB HBM2e | 训练 |
| 910B3 | ~313 TFLOPS | ~626 TOPS | 64GB HBM2e | 训练 |
| 910B4 | ~280 TFLOPS | ~560 TOPS | 32GB HBM2e | 推理 |
关键点:910B 没有独立的 FP8 硬件计算单元,这是它与 A100/H100 的一个重要差距。低精度加速主要依赖 INT8 量化(W8A8),走的是 TOPS 路线。
4.2 昇腾 910C(双 Die 封装,2025 量产)
910C 采用类似 B200 的双 Die 封装思路,把两颗 910B 级别的 Die 整合,实现性能翻倍:
| 参数 | Ascend 910C(估测) | NVIDIA H100(参考) |
|---|---|---|
| FP16 / BF16 | ~800 TFLOPS | ~989 TFLOPS(稠密) |
| INT8 | ~1600 TOPS | ~1979 TOPS(稠密) |
| 显存 | 128GB HBM2e | 80GB HBM3 |
| 显存带宽 | ~3200 GB/s | ~3352 GB/s |
业界普遍估测 910C 的 FP16 单卡算力约为 H100 的 60%~80%。值得注意的是它的显存容量(128GB)反而超过 H100,显存带宽也已接近 H100——这正是它在推理场景表现不俗的关键。
关于 FP8/FP4:据不可靠传闻,后续的 910D 才计划支持 FP8。因此在与 Blackwell 对比 FP8/FP4 算力时,昇腾当前主力型号并不在同一条赛道上。
5. 横向对比:一张表看清「精度 × 算力」
把上面的数字放在一起(单卡,含稀疏口径,昇腾为估测值,— 表示无对应硬件单元):
| 精度 | 昇腾 910B3 | 昇腾 910C | NVIDIA H100 | NVIDIA B200 |
|---|---|---|---|---|
| FP32 | 算力较低 | 算力较低 | 67 TFLOPS | 80 TFLOPS |
| FP16 / BF16 | ~313 TFLOPS | ~800 TFLOPS | 1979 TFLOPS | 4500 TFLOPS |
| FP8 | —(无单元) | —(无单元) | 3958 TFLOPS | 9000 TFLOPS |
| FP4 | — | — | — | 18000 TFLOPS |
| INT8 | ~626 TOPS | ~1600 TOPS | 3958 TOPS | 9000 TOPS |
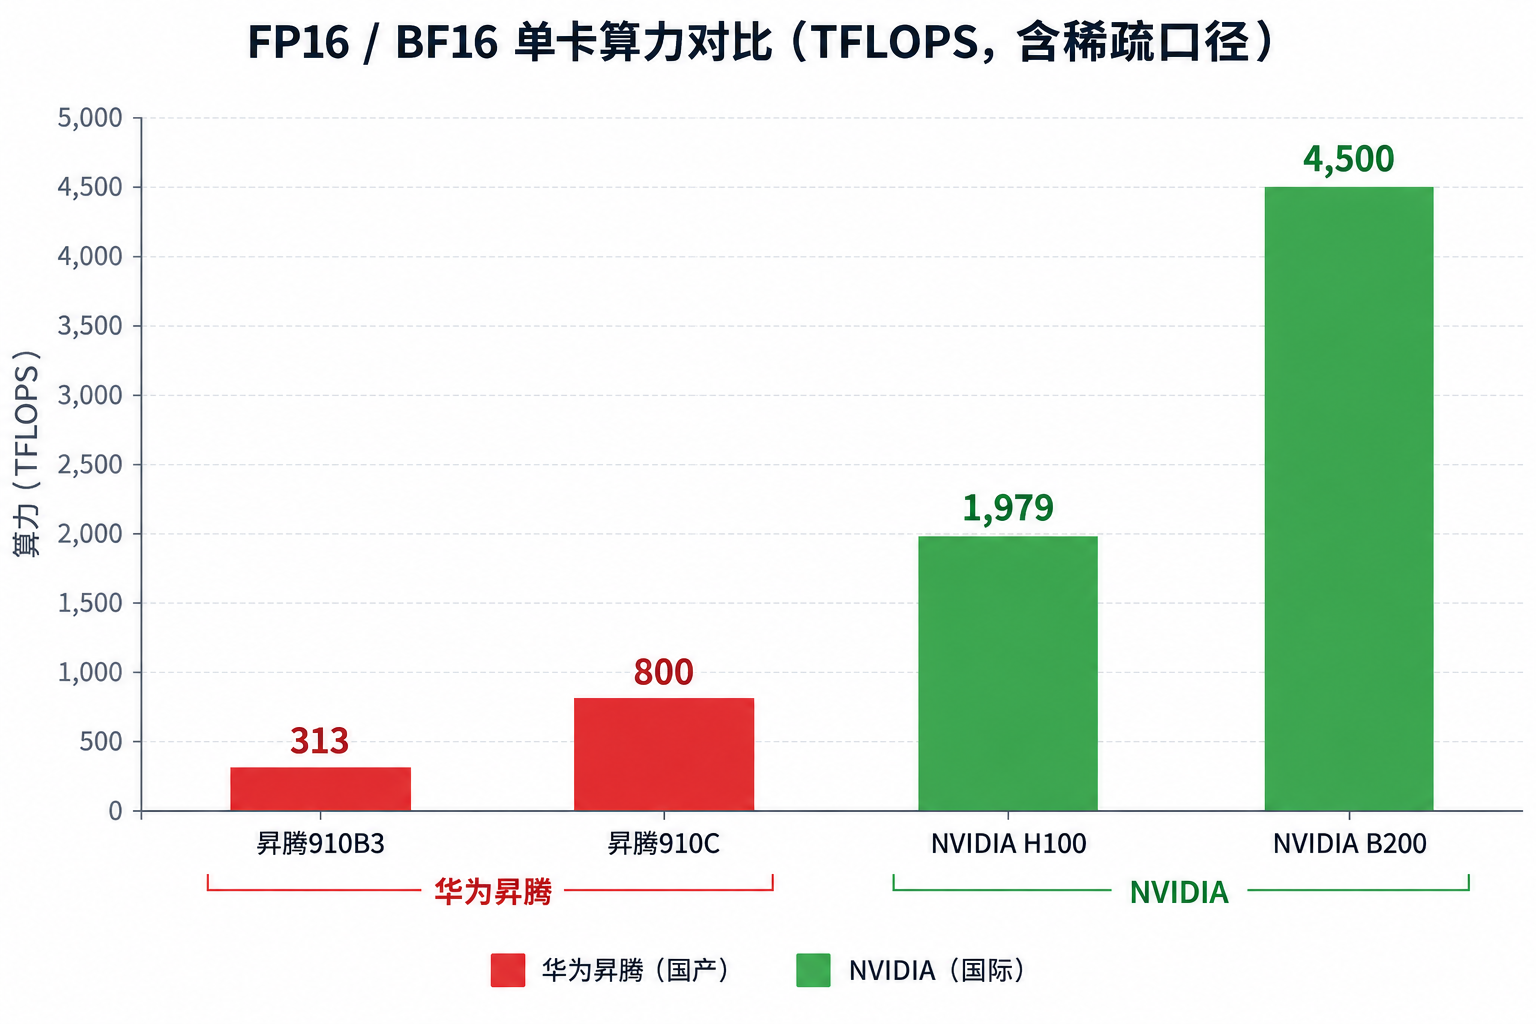
从这张表能读出几个规律:
- 同一列(同一张卡)自上而下,精度越低算力越高,且大致按倍数增长。这就是为什么会有「一张卡多个算力数字」。
- 代际差距明显:B200 的 FP16 算力(4.5 PFLOPS)已经超过 H100(~2 PFLOPS)一倍多;FP4 更是 H100 完全没有的能力。
- 国产与英伟达的差距集中在低精度:昇腾在 FP16 上能到 H100 的 60%~80%,但缺少 FP8/FP4 硬件单元,在推理降本这条路上主要靠 INT8 量化补位,赛道不完全重合。
6. 别被峰值算力骗了:几个重要提醒
看懂了纸面算力,还得知道它的局限。真实世界里,峰值算力(Peak FLOPS)和你实际能用到的算力,差距可能非常大。
6.1 「稀疏」是打了折扣的前提
英伟达标注的很多亮眼数字(比如 B200 FP4 的 18/20 PFLOPS)是稀疏(Sparse)算力,依赖 2:4 结构化稀疏——即权重里每 4 个元素有 2 个为 0。真实稠密(Dense)计算通常只有一半。看数字时务必确认是稠密还是稀疏口径。
6.2 算力利用率(MFU)通常只有 30%~50%
峰值算力是理论上限,实际训练大模型时能达到的**模型算力利用率(MFU,Model FLOPs Utilization)**往往只有 30%~50%。剩下的算力被通信、访存、调度、气泡(bubble)等开销吃掉了。所以「买了多少 PFLOPS」和「真正用上多少」是两回事。
6.3 显存带宽常常才是真正的瓶颈
大模型推理尤其是解码阶段,性能往往不是被算力卡住,而是被显存带宽卡住(memory-bound)。这也是为什么昇腾 910C 虽然 FP16 算力只有 H100 的七八成,但凭借接近 H100 的显存带宽和更大的显存容量,在推理场景反而有不错的性价比。
6.4 集群 > 单卡
单卡打不过,可以靠系统层面「群殴」。华为 CloudMatrix 384 超节点由 384 颗 910C 构成,在整体系统性能上可以对标甚至超越 NVIDIA GB200 NVL72。在大模型时代,高速互联能力(英伟达的 NVLink、华为的灵衢 UnifiedBus)和整机系统设计,和单卡算力同样重要。
7. 下一代卡展望:昇腾 950/960/970 与 NVIDIA Rubin
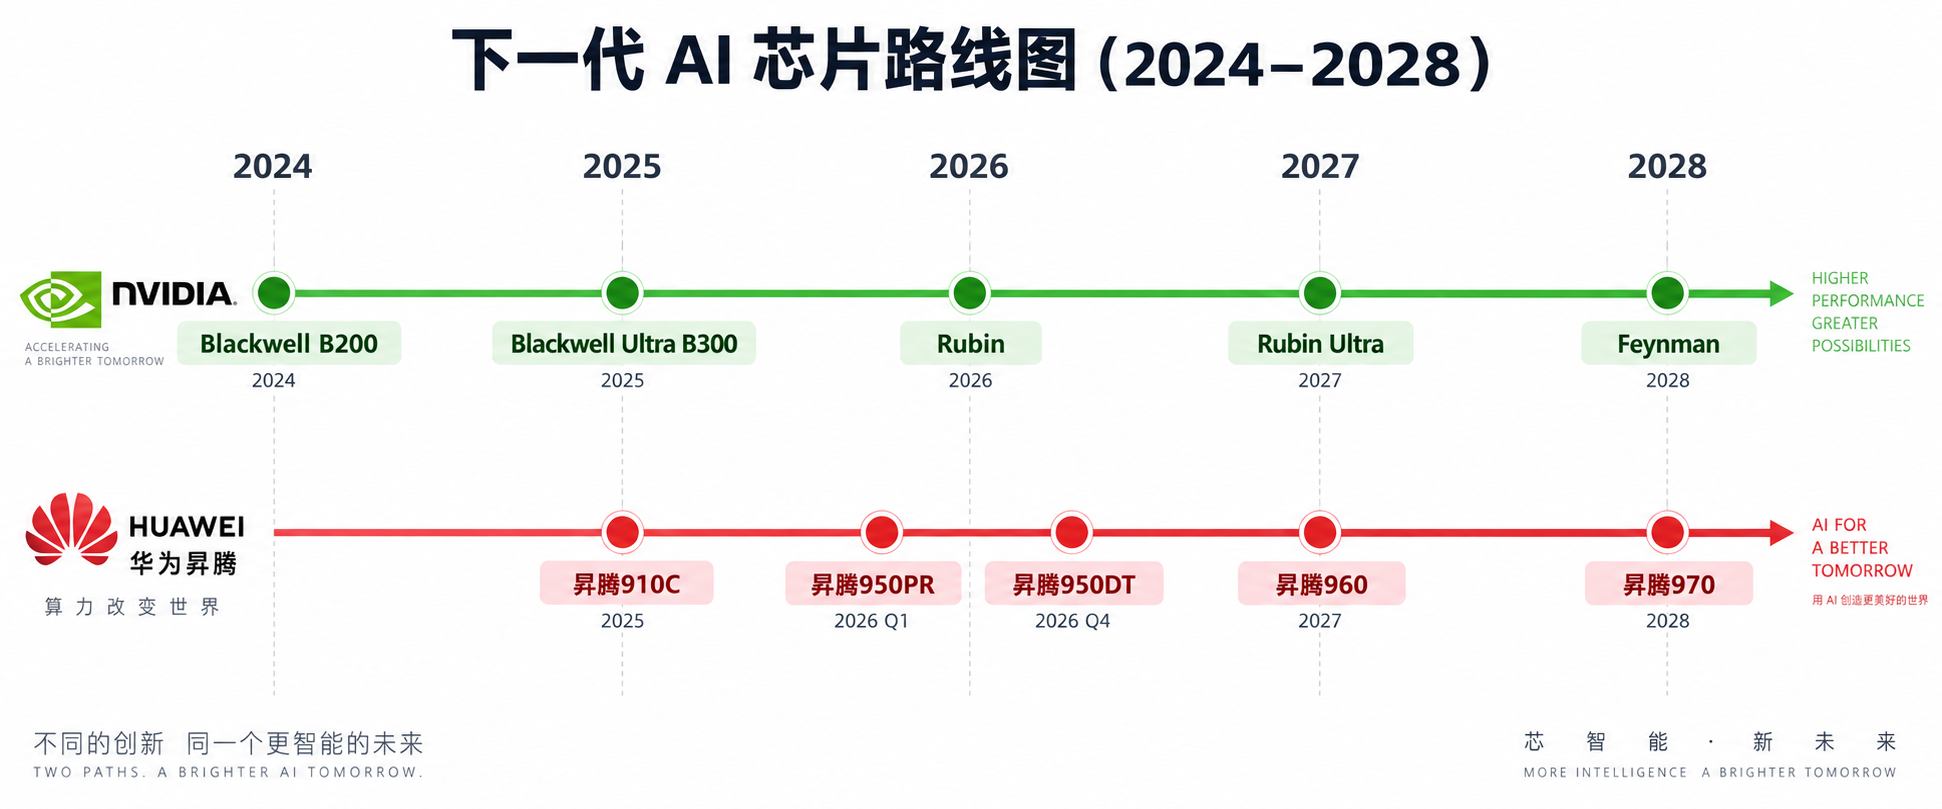
前面聊的都是已量产的卡。2025 下半年两家公布了下一代路线图,其中昇腾 950PR 已于 2026 年量产商用,其余仍在路线图上。下面分「已量产」和「路线图」两部分说明——路线图数据为官方发布会宣称值,产品尚未量产,最终规格以厂商正式发布为准。
7.1 华为昇腾:950 系列已落地,960/970 在路线图上
昇腾「四年五款」路线图(华为全联接大会 2025,2025-09-18 徐直军公布)最关键的变化是:昇腾 950 系列开始原生支持 FP8/FP4 低精度格式,补上了 910 系列最大的短板。
| 型号 | 状态 / 上市 | 定位 | 自研 HBM | 显存 / 带宽 | FP8 算力 | FP4 算力 |
|---|---|---|---|---|---|---|
| 昇腾 910C | 2025 Q1(已量产) | 训练 / 推理 | — | 128GB / ~3.2TB/s | —(无单元) | — |
| 昇腾 950PR | 2026-03 发布,2026-04 量产商用 | 推理 Prefill + 推荐 | HiBL 1.0 | 112GB / 1.4TB/s | ~0.8 PFLOPS | 1.56 PFLOPS(MXFP4) |
| 昇腾 950DT | 2026 Q4(计划) | 推理 Decode + 训练 | HiZQ 2.0 | 144GB / 4TB/s | 1 PFLOPS | 2 PFLOPS(MXFP4) |
| 昇腾 960 | 2027 Q4(路线图) | 训练 / 推理 | — | 288GB / 9.6TB/s | 2 PFLOPS | 4 PFLOPS(HiF4) |
| 昇腾 970 | 2028 Q4(路线图) | 训练 / 推理 | — | — / 14.4TB/s | 4 PFLOPS | 8 PFLOPS |
几个要点:
- 950PR 已经在跑真实业务:2026 年 3 月随 Atlas 350 加速卡发布、4 月起大规模量产。华为称其推理性能约为 NVIDIA H20 的 2.87 倍,价格约为 H200 的 1/4、单卡约 7 万元、功耗 600W。2026 年目标出货约 75 万片,其中字节、阿里等头部客户订单已占大头(一度"一卡难求")。所以你在新闻里看到「昇腾 950 已有大量客户在用」,指的就是这颗 950PR。
- 昇腾 950 补齐低精度:新增支持 FP8、MXFP8、HiF8、MXFP4,并提升向量算力配比、支持 SIMD/SIMT、内存访问粒度从 512B 细化到 128B。这意味着从 950 开始,昇腾在推理降本这条路上不再只靠 INT8 量化,终于能和 Blackwell 的 FP4/FP8 正面对话。
- 自研 HBM:950PR 用 HiBL 1.0(实测 112GB / 1.4TB/s),950DT 用 HiZQ 2.0(144GB / 4TB/s),绕开了 HBM 供应限制。
- 950PR vs 950DT 分工:PR 主打 Prefill(预填充)和推荐业务,DT 主打 Decode(解码)和训练——把推理的两个阶段拆开做专用优化,思路上很有辨识度。
注:950PR 路线图发布时曾标 128GB / 1.6TB/s、FP4 2 PFLOPS,实际量产的 Atlas 350 卡落在 112GB / 1.4TB/s、FP4 1.56 PFLOPS——这也是「路线图宣称值 ≠ 量产实测值」的又一个例子。
配套超节点(华为的核心打法仍是「系统级群殴」):
| 超节点 | 状态 / 上市 | 昇腾卡数 | FP8 算力 | FP4 算力 | 互联带宽 |
|---|---|---|---|---|---|
| Atlas 950 SuperPoD | 2026 Q4(基于 950DT) | 8,192 | 8 EFLOPS | 16 EFLOPS | 16.3 PB/s |
| Atlas 960 SuperPoD | 2027 Q4(路线图) | 15,488 | 30 EFLOPS | 60 EFLOPS | >20 PB/s |
EFLOPS = 1000 PFLOPS = 10¹⁸ FLOPS。对应的 Atlas 950/960 SuperCluster 集群规模分别达 50 万卡 / 百万卡级别。在华为全联接大会 2026(2026-09-17)上,华为轮值董事长汪涛称昇腾超节点已累计部署超 1000 套,昇腾 950 超节点已开始规模商用。华为的策略非常清晰:单芯片受工艺限制打不过,就用「灵衢(UnifiedBus)」高速互联把上万张卡拼成一台逻辑机器,靠系统级算力取胜。
7.2 NVIDIA Rubin(Vera Rubin 平台,GTC 2025/2026 公布)
Blackwell(2024)→ Blackwell Ultra(B300,2025)之后,NVIDIA 下一代是 Rubin,计划 2026 下半年出货,年更节奏锁死:Rubin(2026)→ Rubin Ultra(2027)→ Feynman(2028)。
单卡(Rubin GPU,产业界也称 R100/R200,双 die 封装)主要指标:
| 精度 / 指标 | Rubin(单卡) | B200(对比) | 相对 B200 |
|---|---|---|---|
| NVFP4 推理 | ~50 PFLOPS | ~10 PFLOPS(含稀疏整取) | ~5× |
| NVFP4 训练 | ~35 PFLOPS | — | — |
| FP8(估算) | ~16 PFLOPS | ~9 PFLOPS | ~1.8× |
| 显存 | 288GB HBM4 | 192GB HBM3e | +50% |
| 显存带宽 | ~22 TB/s | 8 TB/s | ~2.75× |
| 晶体管 | 336 亿 | 208 亿 | ~1.6× |
| TDP | 1800~2300W | 1000W | 强制液冷 |
- 换代 HBM4:Rubin 从 HBM3e 升到 HBM4,带宽大幅提升——呼应本文第 6.3 节,推理越来越是「带宽为王」。
- 系统级:Vera Rubin NVL144 整机可达 3.6 EFLOPS FP4 推理、1.2 EFLOPS FP8 训练。
- Rubin Ultra(2027 H2):进一步到 ~100 PFLOPS FP4、1TB HBM4e(16 层堆叠),部署在 NVL576「Kyber」机柜。
- 功耗爆表:单卡 1800~2300W,没有风冷版本,100% 液冷成为前提——这也是为什么算力竞争越来越是「机柜级 / 数据中心级」的工程战。
7.3 一句话对比
- 昇腾 950 系列的历史意义:不在于单卡追平 Rubin(工艺差距客观存在),而在于首次原生支持 FP8/FP4,补齐了与英伟达在低精度赛道上的「缺席」,之后靠超节点系统把规模堆上去。
- NVIDIA Rubin 的方向:单卡 FP4 推理直冲 50 PFLOPS、换代 HBM4、功耗突破 2000W,继续把「单卡怪兽 + NVLink 机柜」的路线推到极致。
- 两条路线的分野依旧:英伟达堆单卡与生态,华为堆系统与互联,只是从 950 开始,双方在「精度格式」这一维度终于站到了同一条起跑线上。
8. 小结
- PFLOPS = 1000 TFLOPS = 10¹⁵ 次浮点运算/秒,是现代 AI 加速卡的常用量级。
- 算力必须绑定精度来看:FP32 → FP16 → FP8 → FP4,位宽每降一半,峰值算力大致翻倍,代价是精度损失。
- NVIDIA:H100 支持到 FP8,B200 新增 FP4 并把 HPC 算力弱化,是纯粹的 AI 芯片;低精度(FP4)是它当前最大的护城河之一。
- 华为昇腾:910B FP16 约 313~414 TFLOPS、910C 约 800 TFLOPS,缺 FP8/FP4 硬件单元,靠 INT8 量化和大显存/高带宽 + 集群系统设计打差异化。
- 看算力别只看纸面峰值:注意稠密/稀疏口径、MFU 利用率、显存带宽瓶颈,以及集群层面的系统能力。
本文中英伟达数据来自官方 Datasheet 及公开资料,华为昇腾数据来自公开产品资料与业界估测,芯片规格与量产信息更新较快,具体数字请以厂商官方最新发布为准。
附录:官方与参考链接
NVIDIA 官方
- NVIDIA H100 Tensor Core GPU 产品页:https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA Blackwell 架构介绍:https://www.nvidia.com/en-us/data-center/technologies/blackwell-architecture/
- NVIDIA HGX 平台(含 HGX B200):https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA DGX B200 产品页:https://www.nvidia.com/en-us/data-center/dgx-b200/
- NVIDIA 数据中心 GPU Datasheet / 白皮书资源中心:https://resources.nvidia.com/en-us-tensor-core
H100 单卡关键规格(SXM,含稀疏):FP16/BF16 1,979 TFLOPS、FP8 3,958 TFLOPS、FP64 34 TFLOPS、80GB HBM3、带宽 3.35 TB/s。 B200 单卡关键规格(含稀疏):FP4 18 PFLOPS、FP8/FP6 9 PFLOPS、FP16/BF16 4.5 PFLOPS、FP64 40 TFLOPS,均以官方 Blackwell Datasheet 为准。
华为昇腾官方
- 华为昇腾社区(hiascend)官网:https://www.hiascend.com/
- 昇腾计算产品(Atlas 系列):https://www.hiascend.com/hardware/product
- Atlas 800 训练服务器(型号 9010)技术规格 - 华为企业技术支持:https://support.huawei.com/enterprise/zh/doc/EDOC1100149984/7eacfada
学术论文与技术报告
- 《Serving Large Language Models on Huawei CloudMatrix384》(华为 & 硅基流动,2025):https://arxiv.org/abs/2506.12708
- PDF:https://arxiv.org/pdf/2506.12708
- 该论文首次系统披露 CloudMatrix 384 超节点架构(384 颗昇腾 910C + 192 颗鲲鹏 CPU、UB 统一总线),并给出 910C 单 die ~376 TFLOPS FP16 的算力口径。
- 《xDeepServe: Model-as-a-Service on Huawei CloudMatrix384》:https://arxiv.org/pdf/2508.02520
下一代卡路线图来源
- 华为全联接大会 2025(HUAWEI CONNECT 2025,2025-09-18):https://www.huawei.com/cn/events/huawei-connect-2025
- 徐直军公布昇腾 950PR/950DT/960/970 芯片路线图,及 Atlas 950/960 SuperPoD、灵衢(UnifiedBus)2.0 技术规范。
- NVIDIA GTC / Vera Rubin 平台:https://www.nvidia.com/en-us/data-center/vera-rubin/
- Rubin GPU、NVL144 系统、Rubin Ultra、NVLink 6 等规格;部分为路线图/宣称值,未正式量产。
说明:昇腾未像英伟达那样公开完整的精细算力 Datasheet,文中 910B/910C 数字来自上述公开资料与业界估测;昇腾 950/960/970 与 NVIDIA Rubin 数据为官方路线图/发布会宣称值,产品尚未量产,最终规格以厂商正式发布为准,仅供量级参考。