0. 先看整机:一台 AI GPU 服务器由什么组成
聊某一张卡的算力之前,先建立「整机视角」很重要——现代 AI 算力早已不是单颗芯片的事,而是芯片 + 显存 + 互联 + 网络 + CPU + 散热 + 供电协同的系统工程。
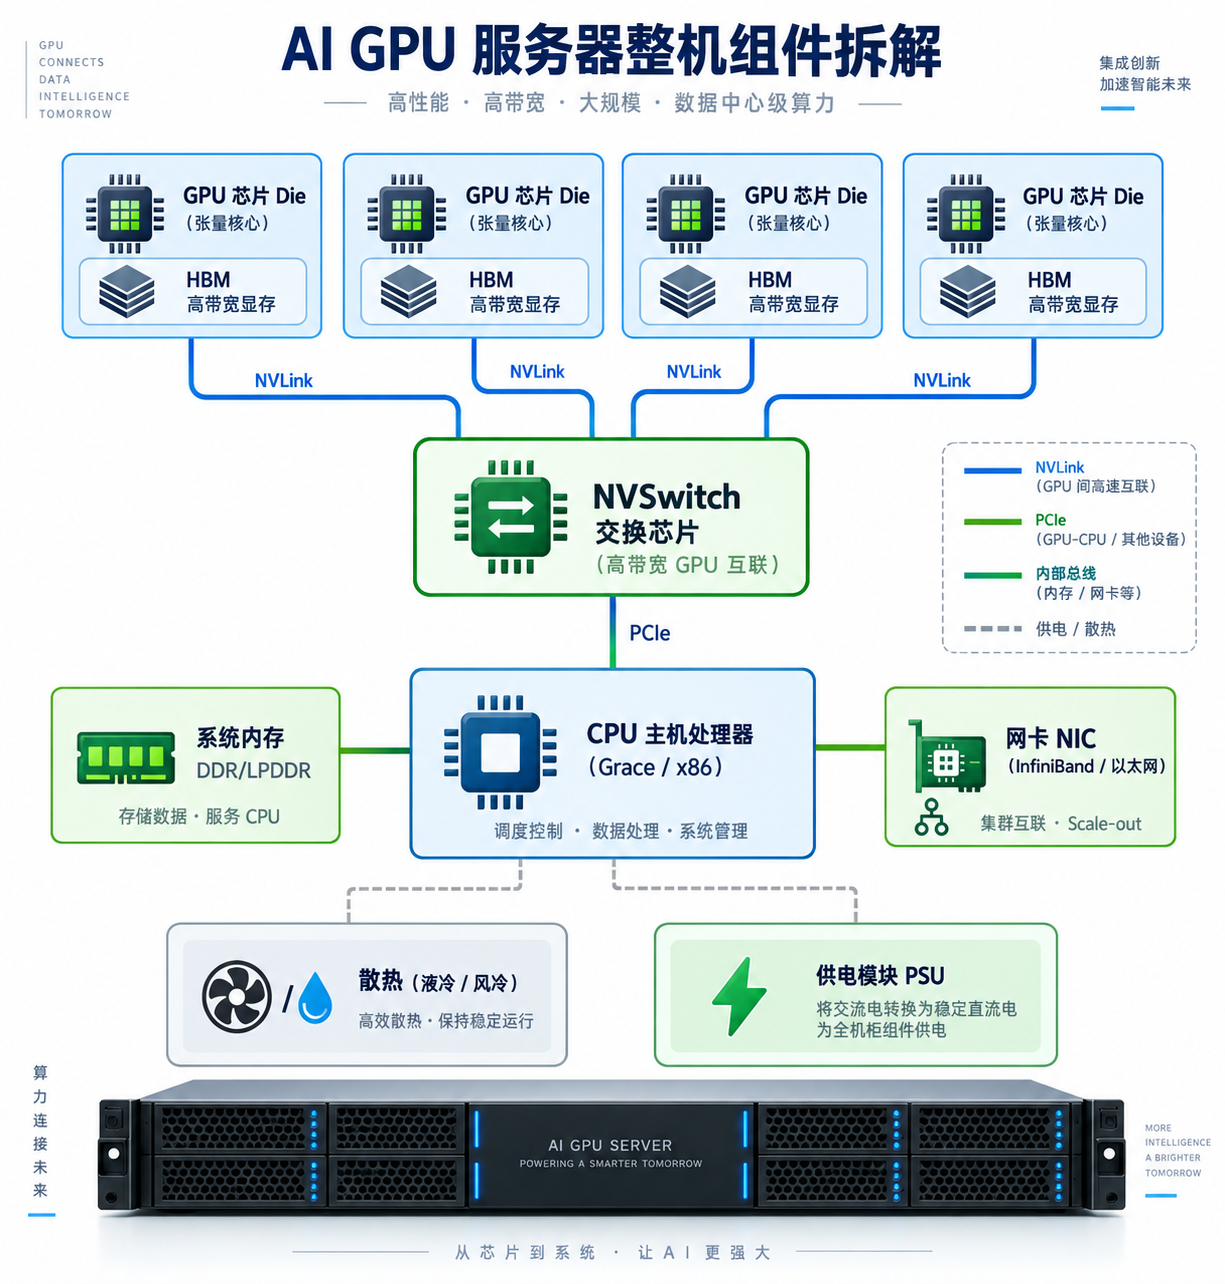
各组件的核心职责与能力:
- GPU 芯片(Die)/ 张量核心(Tensor Core):算力的来源。真正决定 AI 峰值算力的是 Tensor Core,支持 FP16/BF16/FP8/FP4 等精度;先进制程(如 4N、3nm)和 chiplet 多 die 封装决定单卡上限。
- HBM 高带宽显存:决定「装得下多大模型」和「喂得多快」。容量(GB)关系到能放多少参数/KV Cache,带宽(TB/s)在推理解码阶段往往才是真正瓶颈(memory-bound)。
- NVLink 片间高速互联:GPU 与 GPU 之间的高速通道,带宽远高于 PCIe,是多卡张量并行/专家并行的命脉。H100 为 900 GB/s,Blackwell 提升到 1.8 TB/s。
- NVSwitch 交换芯片:把多颗 GPU 组成「全互联」域,让任意两卡都能以 NVLink 全带宽通信,是构建 NVL72 这类超节点的关键。
- 网络 NIC(InfiniBand / 以太网):负责跨服务器的横向扩展(scale-out)。NVIDIA 的 ConnectX / BlueField DPU 提供 400G/800G 级别带宽,把成百上千台机器连成一个大集群。
- 交换机:机内用 NVLink Switch,机间用 InfiniBand 或 Spectrum 以太网交换机,决定集群的拓扑与无阻塞能力。
- CPU 主机处理器(Grace / x86):负责调度、数据预处理与系统管理。NVIDIA 自研的 Grace(Arm 架构)通过 NVLink-C2C 与 GPU 高速相连,替代传统 x86 减少 PCIe 瓶颈。
- 系统内存(DDR / LPDDR5X):CPU 侧内存,做数据缓冲与 CPU offload。Grace 用 LPDDR5X 提供大容量高带宽内存池。
- 散热(液冷 / 风冷):Blackwell/Rubin 单卡功耗冲到 1000~2300W,风冷已到极限,液冷成为高端方案的前提。
- 供电模块(PSU):把交流电转成稳定直流,为整机柜供电。单机柜功率从几十 kW 到数百 kW,供电与散热已是数据中心设计的核心约束。
- 本地存储(NVMe SSD / 并行文件系统):存放训练数据、Checkpoint 与模型权重。大规模训练还需 Lustre/GPFS 等并行文件系统 + 高速网络,避免「喂不饱 GPU」。
- PCIe 总线 / 交换:CPU 与 GPU、NIC、SSD 之间的通道(Gen5 ~128 GB/s)。带宽远低于 NVLink,是主机侧数据搬运的潜在瓶颈。
- 光模块 / 光互联(Optics):800G/1.6T 光模块承载 InfiniBand/以太网长距离互联,超节点里成千上万个光模块的成本、功耗与可靠性已成关键工程问题。
- DPU 数据处理器(BlueField):把网络、存储、安全卸载到独立芯片,释放主机 CPU,是云化多租户 AI 集群的重要一环。
- BMC / 带外管理:负责固件升级、健康监控、故障诊断,是大规模集群运维的基础。
- 整机 / 机柜形态:从 HGX 基板(8 卡)→ DGX/MGX 整机 → GB200 NVL72 整机柜,「机柜即计算单元」已成趋势。
抓重点:一台 AI 服务器最该盯的三个硬指标——算力、HBM 显存、显存带宽。
- 算力(FLOPS):决定「算得多快」,看清精度口径(FP16/FP8/FP4、稠密/稀疏)。
- HBM 显存容量(GB):决定「装得下多大模型 / 多长上下文」,放不下就得切分或 offload,代价巨大。
- 显存带宽(TB/s):决定「喂得多快」,大模型推理解码阶段往往是带宽瓶颈(memory-bound),此时带宽比峰值算力更关键。 其余互联、网络、CPU、散热供电,是把这三者「拼成规模、稳定跑起来」的支撑。
一句话:看一台 AI 服务器,别只看 GPU 算力,要看「算力 × 显存 × 带宽 × 互联 × 网络 × 散热供电」的木桶。
1. NVIDIA 数据中心 GPU 架构演进总览
NVIDIA 的数据中心 GPU 大致以「架构」为代际,从 2016 年的 Pascal 一路演进到 2024 年的 Blackwell,并已公布到 2028 年的路线图。近乎一年一迭代,每代在算力、精度格式、显存与互联带宽上持续翻倍。
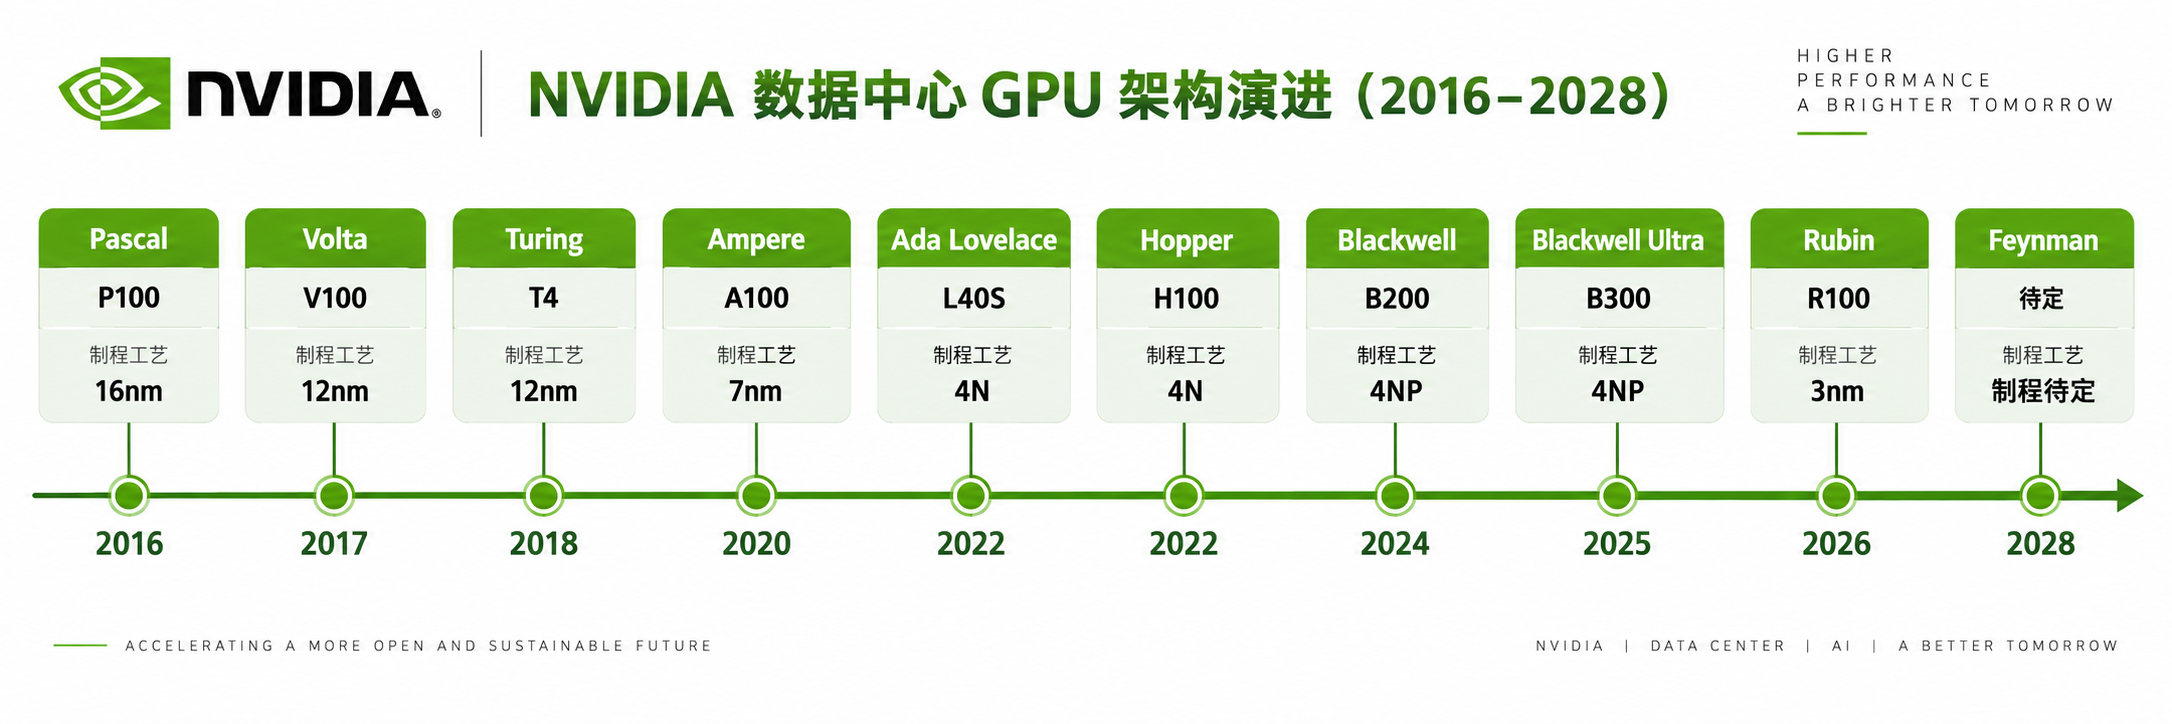
图中每格第三行是制程工艺(芯片用什么代工工艺制造)。其中 4N 是台积电(TSMC)为 NVIDIA 定制的 4nm 级工艺(“4N” = 4nm NVIDIA,基于 N5/5nm 家族的定制优化版),4NP 是它的性能增强版(P = Performance)。可以看到 Ada Lovelace、Hopper、Blackwell 连续三代都停留在同一「4nm 级」工艺(4N → 4N → 4NP),制程没有大跨越——这几代性能的提升更多靠架构改进、精度降低(FP8/FP4)、双 Die 封装与 HBM 升级,直到 Rubin(2026)才跳到真正的 3nm。
一条主线贯穿始终:从「通用浮点计算」走向「AI 张量计算」,精度越做越低(FP32 → FP16 → FP8 → FP4),显存越做越大,互联越做越快。
1.1 不止这些卡:还有哪些型号
上面时间轴只列了每代的数据中心代表型号,实际每一代还有一大家族:
- 更早的架构:Kepler(K80,2014)、Maxwell(M40,2015)——深度学习早期用得很多,现已淘汰。
- 同代不同档位 SKU:如 Ampere 的 A30 / A10 / A2、Ada 的 L4、Hopper 的 H100 PCIe / H100 NVL / GH200(Grace Hopper 超级芯片)、Blackwell 的 GB200 / GB300、以及各代的工作站/专业卡(RTX A6000、RTX 6000 Ada、RTX PRO 6000 等)。
- 消费级同架构:GeForce RTX 系列(如 RTX 3090/4090/5090)与数据中心卡同架构,但显存、互联、可靠性定位不同。
1.2 逐代规格总览对比表
把各代数据中心旗舰的关键指标放在一起(重点看算力 / 显存 / 带宽三列,含中国特供版):
| 架构(年份) | 代表型号 | 制程 | 显存(容量 / 类型) | 显存带宽 | NVLink | 代表 AI 算力 | 功耗 | 中国特供 |
|---|---|---|---|---|---|---|---|---|
| Pascal(2016) | P100 | 16nm | 16GB HBM2 | 0.73 TB/s | 160 GB/s | FP16 21 TFLOPS | 300W | — |
| Volta(2017) | V100 | 12nm | 16/32GB HBM2 | 0.9 TB/s | 300 GB/s | FP16(TC) 125 TFLOPS | 300W | — |
| Turing(2018) | T4 | 12nm | 16GB GDDR6 | 0.32 TB/s | — | FP16 65 / INT8 130 TOPS | 70W | — |
| Ampere(2020) | A100 | 7nm | 40/80GB HBM2e | 1.55 / 2.0 TB/s | 600 GB/s | FP16 624 TFLOPS(稀疏) | 400W | A800 |
| Ada(2022) | L40S | 4N | 48GB GDDR6 | 0.86 TB/s | — | FP8 1466 TFLOPS(稀疏) | 350W | L20 |
| Hopper(2022/23) | H100 / H200 | 4N | 80GB HBM3 / 141GB HBM3e | 3.35 / 4.8 TB/s | 900 GB/s | FP8 3958 TFLOPS(稀疏) | 700W | H800 / H20 |
| Blackwell(2024) | B200 | 4NP | 192GB HBM3e | 8 TB/s | 1.8 TB/s | FP4 18 PFLOPS(稀疏) | 1000W | B30 / B40 |
| Blackwell Ultra(2025) | B300 | 4NP | 288GB HBM3e | 8 TB/s | 1.8 TB/s | FP4 ~15 PFLOPS(稠密) | ~1400W | — |
| Rubin(2026) | R100 | 3nm | 288GB HBM4 | ~13–22 TB/s | NVLink 6 | FP4 ~50 PFLOPS(宣称) | 1800~2300W | — |
注:算力口径不统一(老卡 TFLOPS、新卡 PFLOPS;部分含稀疏,部分为稠密/宣称值),仅供量级对比;显存带宽为 HBM/GDDR 峰值。具体以官方 Datasheet 为准。
2. 逐代核心技术参数
说明:以下为各代数据中心代表型号的官方口径,AI 张量算力若无特别说明多为含稀疏(sparse)口径,稠密(dense)约为一半。
2.1 Pascal(2016)— P100:深度学习时代起步
- 制程 / 晶体管:TSMC 16nm FinFET / 153 亿
- 代表型号:Tesla P100、GTX 1080
- 算力:FP64 5.3 / FP32 10.6 / FP16 21.2 TFLOPS(无 Tensor Core)
- 显存:16GB HBM2,带宽 732 GB/s
- 互联:NVLink 1.0,160 GB/s;功耗 300W
- 定位:AI 训练的起点,首次在数据中心卡上引入 HBM 与 NVLink。
2.2 Volta(2017)— V100:首次引入 Tensor Core
- 制程 / 晶体管:TSMC 12nm / 211 亿
- 代表型号:Tesla V100
- 算力:FP64 7.8 / FP32 15.7 TFLOPS;Tensor Core(1 代)FP16 125 TFLOPS
- 显存:16 / 32GB HBM2,带宽 900 GB/s
- 互联:NVLink 2.0,300 GB/s;功耗 300W
- 定位:Tensor Core 的开山之作,深度学习训练性能一举拉开与通用计算的差距。
2.3 Turing(2018)— T4:推理与图形并重
- 制程:TSMC 12nm;引入 2 代 Tensor Core + RT Core,新增 INT8/INT4
- 代表型号:Tesla T4(推理)、Quadro RTX 6000、RTX 2080
- 算力(T4):FP16 65 TFLOPS、INT8 130 TOPS
- 显存(T4):16GB GDDR6,带宽 320 GB/s;功耗仅 70W(PCIe 半高卡)
- 定位:低功耗推理卡的经典,广泛用于云端推理与视频处理。
2.4 Ampere(2020)— A100:数据中心 AI 的中流砥柱
- 制程 / 晶体管:TSMC 7nm / 542 亿
- 代表型号:A100、RTX A6000、RTX 3090
- 算力:FP64 19.5(TC)/ TF32 312 / FP16 624 / INT8 1248 TOPS(含稀疏)
- 显存:40 / 80GB HBM2e,带宽 1.55 / 2.0 TB/s
- 互联:NVLink 3.0,600 GB/s;功耗 400W
- 新特性:TF32、BF16、结构化稀疏、MIG 多实例
- 中国特供:A800(NVLink 从 600 降到 400 GB/s)
2.5 Ada Lovelace(2022)— L40S:生成式 AI 与图形
- 制程:TSMC 4N;4 代 Tensor Core(支持 FP8)+ 3 代 RT Core
- 代表型号:L40 / L40S、RTX 6000 Ada、RTX 4090
- 算力(L40S):FP8 约 1466 TFLOPS(含稀疏)
- 显存(L40S):48GB GDDR6 ECC,带宽 864 GB/s;无 NVLink;功耗 350W
- 定位:偏推理与生成式 AI、图形渲染;性价比路线
- 中国特供:L20
2.6 Hopper(2022 / 2023)— H100 / H200:大模型训练主力
- 制程 / 晶体管:TSMC 4N / 800 亿
- 代表型号:H100、H200
- 算力(H100 SXM,含稀疏):FP64 67(TC)/ TF32 989 / FP16 1979 / FP8 3958 TFLOPS
- 显存:H100 80GB HBM3(3.35 TB/s);H200 141GB HBM3e(4.8 TB/s),算力与 H100 相同
- 互联:NVLink 4.0,900 GB/s;功耗 700W
- 新特性:Transformer Engine、首次硬件支持 FP8
- 中国特供:H800(互联/带宽受限)、H20(算力大幅削减但显存/带宽保留,主打推理)
⚠️ 别把 H200 和 H20 搞混,二者方向相反:H200 是全球版「满血升级卡」——H100 的显存升级版(141GB HBM3e / 4.8 TB/s,算力与 H100 相同,更强);H20 是中国特供「阉割卡」——算力砍到约 H100 的 15%,但刻意保留大显存与高带宽用于推理(更弱)。名字像,一个加强、一个缩水。
2.7 Blackwell(2024)— B200:迈入 FP4 时代
- 制程 / 晶体管:TSMC 4NP / 2080 亿(双 Die 封装,NV-HBI 10 TB/s 互联)
- 代表型号:B200、GB200(Grace+2×B200)、RTX 5090
- 算力(单卡,稠密 / 稀疏):FP4 9 / 18 PFLOPS、FP8 4.5 / 9、FP16 2.25 / 4.5 PFLOPS、FP64 40 TFLOPS
- 显存:192GB HBM3e,带宽 8 TB/s
- 互联:NVLink 5.0,1.8 TB/s;功耗 1000W(可配置到 1200W)
- 新特性:新增 FP4、2 代 Transformer Engine,把推理吞吐相对 FP8 再翻倍
- 中国特供:B30 / B40(规划/报道,算力与互联下降)
2.8 Blackwell Ultra(2025)— B300:过渡增强版
- 显存:288GB HBM3e,带宽 8 TB/s
- 算力(稠密):FP4 约 15 PFLOPS、FP8 约 7 PFLOPS、FP16 约 3.5 PFLOPS
- 功耗:约 1400W(强制液冷)
- 定位:Blackwell 与 Rubin 之间的过渡产品,主要提升显存与吞吐。
2.9 Rubin(2026)— 下一代:HBM4 + 3nm
- 制程 / 晶体管:TSMC 3nm / 约 3360 亿(双 Die)
- 平台:Vera Rubin(Vera CPU 88 核 Arm + Rubin GPU)
- 算力(单卡,官方/宣称):FP4 推理约 50 PFLOPS、FP4 训练约 35、FP8 约 16 PFLOPS
- 显存:288GB HBM4,带宽约 13~22 TB/s(口径不一)
- 互联:NVLink 6;功耗 1800~2300W(无风冷版本,100% 液冷)
- 后续:Rubin Ultra(2027) 约 100 PFLOPS FP4、1TB HBM4e;Feynman(2028) 更远期架构
- 状态:CES 2026 确认进入量产、2026 下半年上市;部分为路线图/宣称值,以官方正式发布为准。
3. 一图看懂:算力与显存带宽的量级跃迁
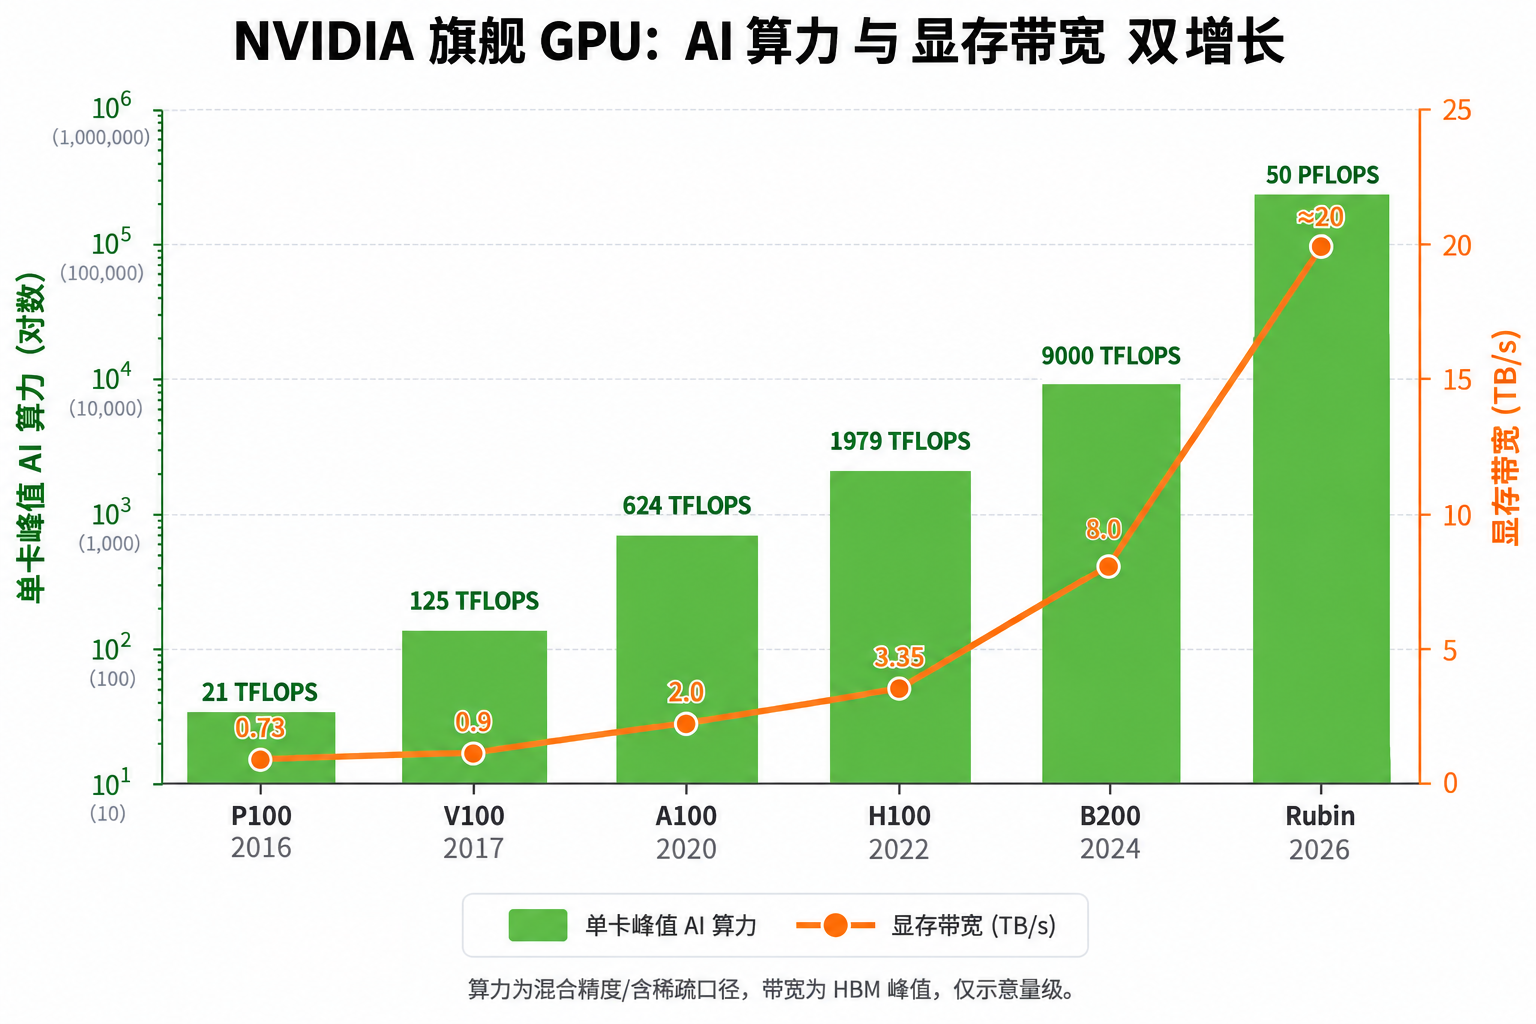
图中绿色柱是单卡 AI 算力,橙色线是显存带宽——两者必须同步增长,否则「算力再高也喂不饱」。
从 P100 到 Rubin:AI 算力约从 21 TFLOPS 涨到 50 PFLOPS(约六个数量级,注意纵轴为对数),显存带宽从 0.73 TB/s 涨到约 20 TB/s(约 27 倍)。这背后不只是制程进步,更来自:
- Tensor Core 的引入与迭代(Volta 起)→ 拉高算力
- 精度不断降低(FP32 → FP16 → FP8 → FP4,每降一半算力约翻倍)→ 拉高算力
- 多 Die chiplet 封装(Blackwell 起单封装塞进两颗 Die)→ 同时拉高算力与带宽
- HBM 的持续升级(HBM2 → HBM2e → HBM3 → HBM3e → HBM4)→ 拉高显存容量与带宽
关键认知:算力、显存、带宽三者要匹配。 大模型训练更吃算力+互联,大模型推理(尤其解码)更吃显存带宽——这也是为什么 H200、B300 在算力不变或小增的情况下,靠堆显存和带宽就能显著提升推理表现。
3.1 算力 × HBM × 带宽:一张表看清「概念 / 趋势 / 关系」
| 要素 | 是什么(概念) | 十年发展趋势 | 决定什么 / 何时是瓶颈 |
|---|---|---|---|
| 算力(FLOPS) | 每秒能做多少次浮点运算,需绑定精度口径(FP16/FP8/FP4、稠密/稀疏) | Tensor Core + 降精度 + 双 Die 封装驱动,21 TFLOPS → 50 PFLOPS(约 6 个数量级) | 决定「算得多快」;训练、计算密集场景的瓶颈 |
| HBM 显存容量(GB) | 高带宽显存能装多少数据(参数 / KV Cache / 激活) | 随 HBM 代次升级,16GB → 288GB(约 20×) | 决定「装得下多大模型 / 多长上下文」;放不下就切分或 offload,代价大 |
| 显存带宽(TB/s) | 每秒能从 HBM 读写多少数据 | HBM2 → HBM4,0.73 → ~20 TB/s(约 27×) | 决定「喂得多快」;大模型推理解码阶段常是带宽瓶颈(memory-bound) |
三者的关系(一句话):它们是一个木桶——算力负责「算」,HBM 容量负责「装」,带宽负责「喂」,短板决定实际性能。发展趋势上三条腿必须一起长:算力靠架构与精度,容量与带宽靠 HBM 代次同步升级。侧重点则随场景不同——训练更吃算力+互联,推理(尤其解码)更吃带宽+容量。
4. 重点:HBM 显存的演进,以及它和「显存」的关系
前面反复提到 HBM,这里单独讲清楚——因为显存(尤其 HBM)的进步,几乎和算力一样,是这十年 GPU 能扛起大模型的关键。
4.1 先分清三个概念
- 显存:GPU 自带的高速内存,用来放模型参数、KV Cache、激活值。是「显存」这个功能。
- HBM(High Bandwidth Memory,高带宽显存):显存的一种实现技术。它把多层 DRAM 垂直堆叠(3D 堆叠 + TSV 硅通孔)紧贴 GPU,用超宽位宽换极高带宽。数据中心 GPU 几乎都用 HBM;消费卡多用平铺的 GDDR(便宜、带宽低)。
- HBM 这块显存又有两个关键属性:容量(GB,能装多少) 和 带宽(TB/s,喂得多快)。
打个比方:HBM 是冰箱的型号,容量是冰箱多大(能囤多少食材 = 放得下多大模型),带宽是取放通道多宽(厨师取菜多快 = 数据喂得多快)。厨师(算力)再强,冰箱小了装不下、门窄了取得慢,都白搭。
4.2 HBM 代次演进,与 NVIDIA 卡的对应
HBM 几乎和 GPU 架构同步升级,每一代都在容量与带宽上同时翻番:
| HBM 代次 | 代表 NVIDIA 卡 | 单卡显存容量 | 单卡显存带宽 |
|---|---|---|---|
| HBM2 | P100 / V100 | 16 / 32GB | 0.73 ~ 0.9 TB/s |
| HBM2e | A100 | 40 / 80GB | 1.55 ~ 2.0 TB/s |
| HBM3 | H100 | 80GB | 3.35 TB/s |
| HBM3e | H200 / B200 / B300 | 141 / 192 / 288GB | 4.8 ~ 8 TB/s |
| HBM4 | Rubin(2026) | 288GB 起 | ~13 ~ 22 TB/s |
可以看到:从 HBM2 到 HBM4,单卡显存容量涨了近 20 倍,带宽涨了约 27 倍——这条曲线和算力曲线几乎并肩上扬(见上一节双轴图)。
4.3 为什么显存的进步这么关键
- 模型越来越大:参数量、上下文长度、KV Cache 暴涨,容量决定「单卡/单机放不放得下」,放不下就得切分或 offload,通信与调度开销陡增。
- 推理常是带宽瓶颈:大模型解码阶段每生成一个 token 都要把海量权重从 HBM 读一遍,性能被带宽卡住(memory-bound),此时带宽比峰值算力更决定实际速度。
- HBM 已成稀缺资源与成本大头:先进封装(CoWoS)与 HBM 供应,是当前 AI 芯片产能的核心瓶颈之一;华为等厂商也在自研 HBM 绕开限制。
一句话:算力决定「算得多快」,HBM(容量 + 带宽)决定「装得下 + 喂得饱」——两条腿必须一起长,缺一条都会成为大模型的短板。
5. 关于中国特供版
由于出口管制,NVIDIA 为中国市场推出了多款「阉割版」,核心思路是降低互联带宽和/或 AI 峰值算力,以满足出口合规阈值:
| 原型号 | 中国特供版 | 主要阉割点 |
|---|---|---|
| A100 | A800 | NVLink 互联带宽 600 → 400 GB/s |
| L40 | L20 | 显存带宽、算力受限,偏推理 |
| H100 | H800 | NVLink / 带宽 / 算力受限 |
| H100 | H20 | 算力大幅削减,但保留大显存 / 高带宽,主打推理 |
| B200 | B30 / B40 | 算力与互联能力下降(规划/报道) |
特供版的规格随政策变化调整较快,具体以当期实际发售版本为准。
6. 小结
- 看 GPU 先看整机:算力 = 芯片 + 显存 + 互联 + 网络 + CPU + 散热供电的系统能力,任何一环都可能成为瓶颈。
- 盯三个硬指标:算力(算得多快)、HBM 显存容量(装得下多大)、显存带宽(喂得多快),三者要匹配,短板决定实际性能。
- 架构主线:Pascal(HBM/NVLink 起步)→ Volta(Tensor Core)→ Turing(推理/INT8)→ Ampere(TF32/稀疏)→ Ada(FP8/图形)→ Hopper(Transformer Engine/FP8)→ Blackwell(FP4/双 Die)→ Rubin(HBM4/3nm)。
- 两条腿一起长:算力靠 Tensor Core + 降精度 + chiplet;显存靠 HBM 代次升级(HBM2→HBM4),容量与带宽同步翻番。
- 系统级竞争:从单卡到 NVL72 超节点,NVLink/NVSwitch 与网络互联,和单卡算力同样决定最终性能。
本文数据来自 NVIDIA 官方 Datasheet 及公开资料,Rubin 等未量产产品为官方路线图/宣称值,芯片规格更新较快,具体请以厂商官方最新发布为准。
附录:官方与参考链接
- NVIDIA 数据中心 GPU 总览:https://www.nvidia.com/en-us/data-center/
- NVIDIA H100 Tensor Core GPU:https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA H200:https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA A100:https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA L40S:https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA Blackwell 架构:https://www.nvidia.com/en-us/data-center/technologies/blackwell-architecture/
- NVIDIA HGX 平台(含 HGX B200):https://www.nvidia.com/en-us/data-center/hgx/
- NVIDIA Grace CPU:https://www.nvidia.com/en-us/data-center/grace-cpu/
- NVIDIA Vera Rubin 平台:https://www.nvidia.com/en-us/data-center/vera-rubin/
- NVIDIA 网络(ConnectX / BlueField / Spectrum):https://www.nvidia.com/en-us/networking/