本文基于各厂商官网/官方发布会、公开财报与行业研报整理,数据截至 2026年10月。 重要说明:国产AI芯片相当一部分规格官方并未完整披露,网络流传数值常混淆精度口径(如把 INT8 TOPS 当作 FP16 TFLOPS)。本文已对关键数据做口径校正,并逐项标注来源(官方 / 研报估算),不确定处如实说明,不做夸大。
核心结论速览(TL;DR)
如果只看三分钟,记住这六条:
- 算力追平:昇腾910C 稠密 FP16 达 800 TFLOPS,逼近 H100(989)。
- 显存反超:沐曦C600 / 燧原L600 144GB HBM3e、昇腾910C 128GB,容量已局部追齐国际主流配置。
- 互联仍落后约 1 代:卡间互联多在 400–784 GB/s,不及 NVLink 的 900 GB/s+,国产因此走"超节点集群化“补短板。
- 先进封装突围:Chiplet / 2.5D 封装(壁仞、昇腾910C、沐曦)绕过制程封锁,用成熟工艺逼近先进制程性能。
- 三大卡点未解:先进封装产能、HBM 供应、软件生态仍是自主化核心矛盾(昇腾已被动走上自研 HBM)。
- 市场放量:2025 国产 AI 加速卡出货约 165 万张、占国内约 41%;机构预测 2026 昇腾份额约 50%。
本文覆盖的 10 家主流厂商:华为昇腾、壁仞科技、寒武纪、百度昆仑芯、摩尔线程、沐曦、海光信息、天数智芯、阿里平头哥、燧原科技。
一、技术路线与发展历程:七年四级跳
国产GPU沿着"成立起步 → 初代量产 → 集群规模化 → 路线图成熟"的节奏推进,下图把 10 家厂商按五个阶段铺在同一条时间线上。
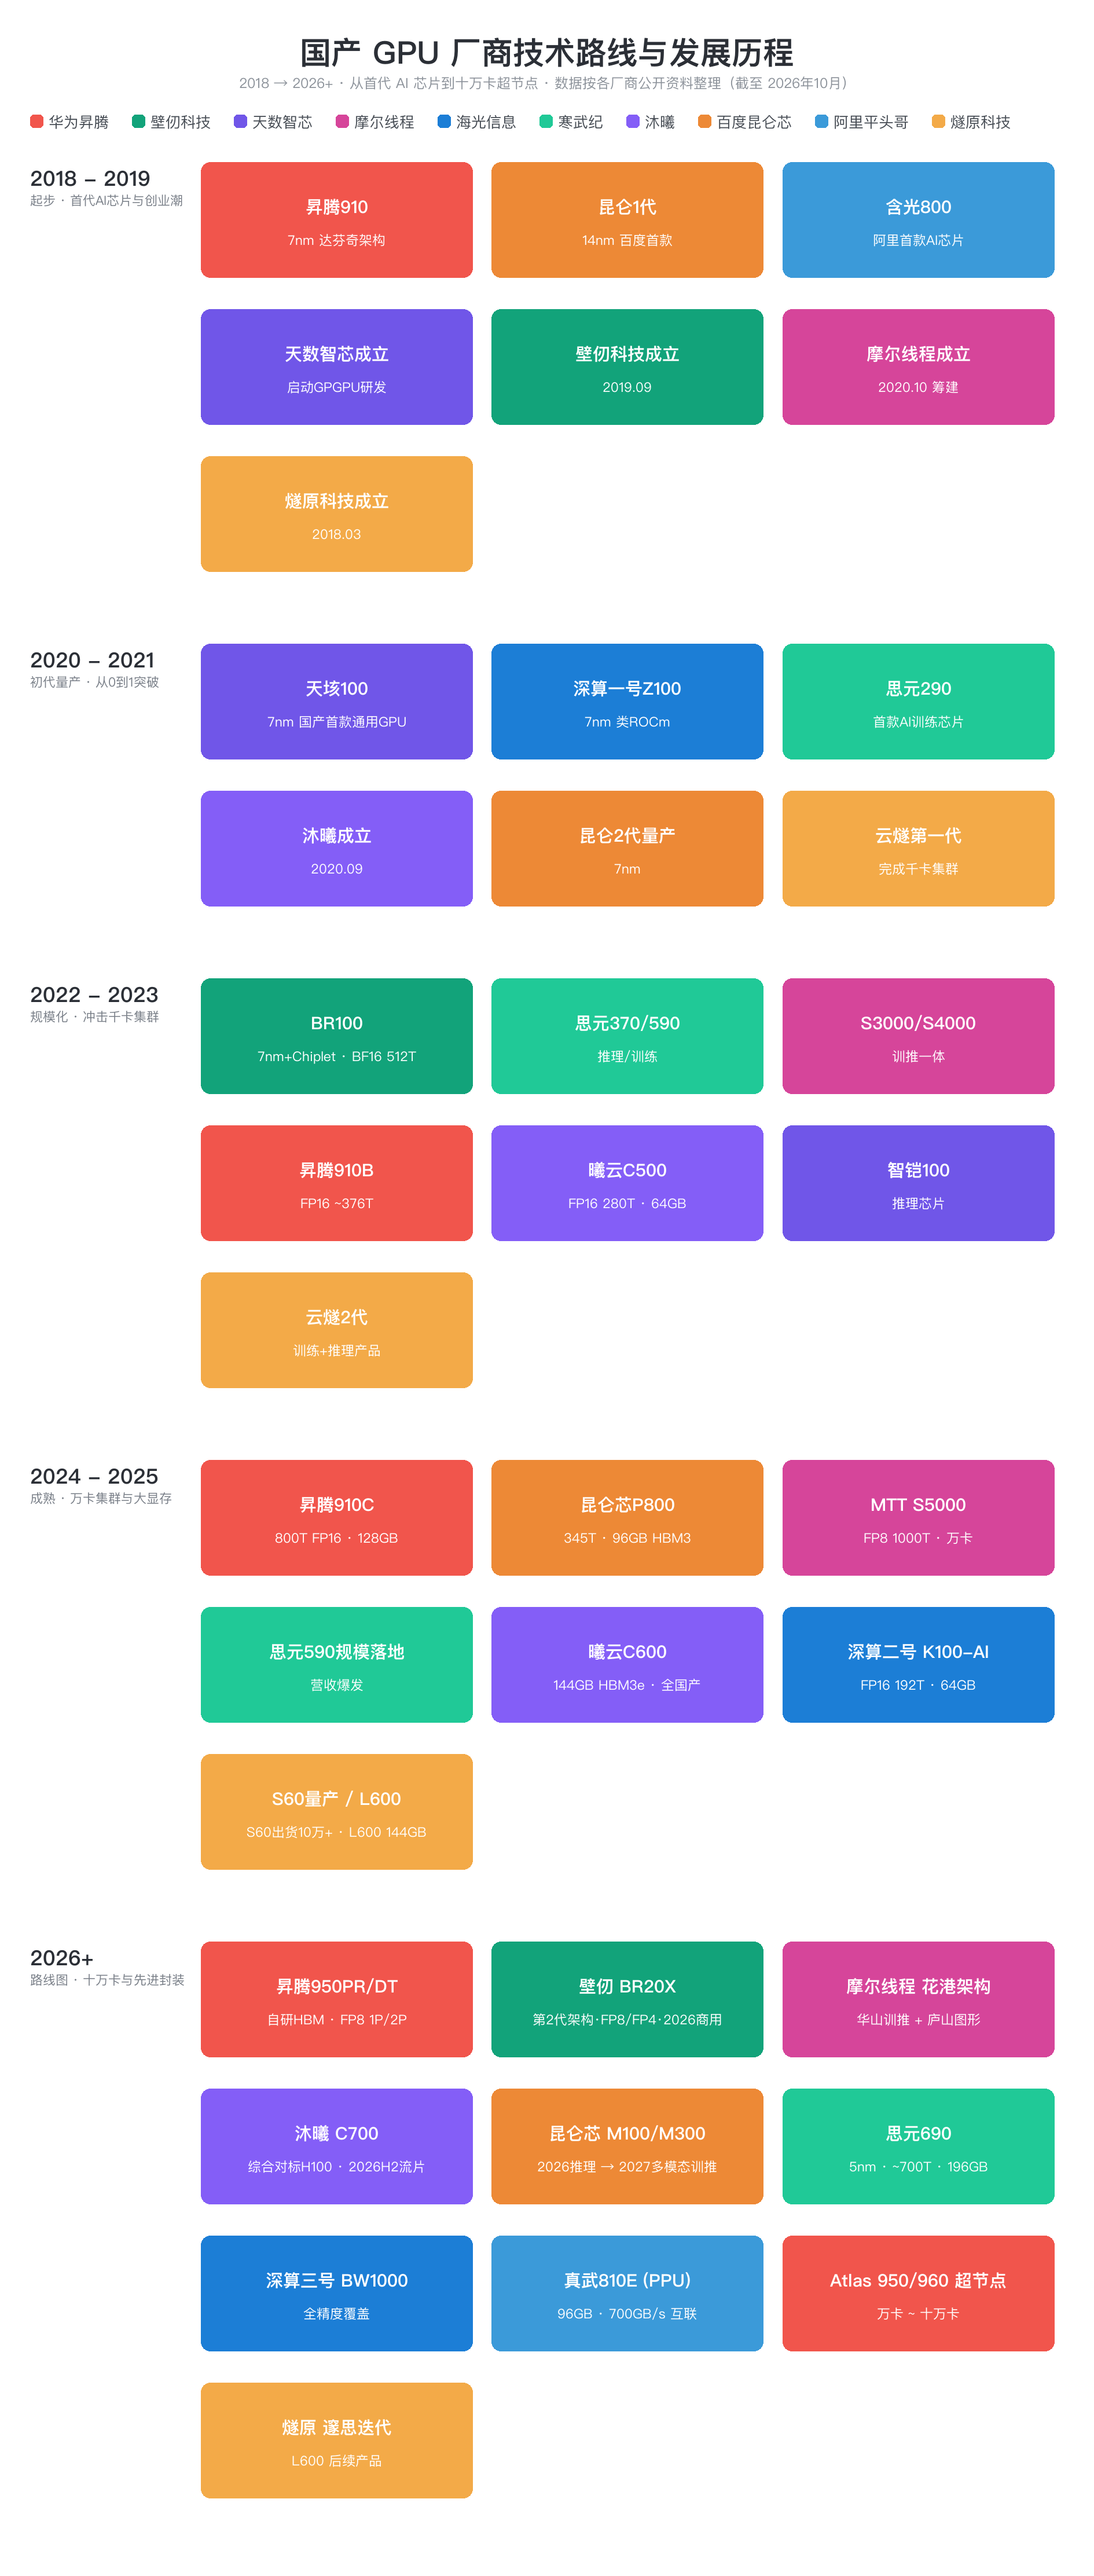
- 2018–2019 起步期:华为昇腾910(7nm 达芬奇)、百度昆仑1代(14nm)、阿里含光800问世;壁仞、摩尔线程、天数智芯密集成立。
- 2020–2021 量产期:天垓100(国产首款通用GPU)、海光深算一号Z100、寒武纪思元290落地,完成从0到1。
- 2022–2023 规模化:壁仞BR100(7nm+Chiplet,BF16 512 TFLOPS)、思元370/590、摩尔线程S3000/S4000、昇腾910B(FP16约376T)冲击千卡集群。
- 2024–2025 成熟期:昇腾910C(800T FP16、128GB)、昆仑芯P800(345T、96GB HBM3)、摩尔线程S5000(FP8 1000T、万卡集群)、沐曦C600(144GB HBM3e)量产。
- 2026+ 路线图:高端化、十万卡与先进封装并进——
- 华为昇腾:950PR(2026Q1,自研HBM、FP8 1P)→ 950DT(2026Q4,2P)→ 960(2027)→ 970(2028);Atlas 950/960 超节点剑指万卡~十万卡。
- 壁仞科技:第二代架构旗舰 BR20X(新增 FP8/FP4、更大内存与超节点互连)2026 商业化;2026.01 登陆港交所(“港股 GPU 第一股”),BR30X/BR31X 瞄准 2028。
- 摩尔线程:新一代"花港"架构(算力密度 +50%、能效 ×10)衍生 华山(训推一体,支持十万卡)与 庐山(图形渲染)2026 陆续上市。
- 沐曦:曦云 C600 2026H1 量产、C700(综合性能对标 H100)2026 下半年流片。
- 百度昆仑芯:M100(2026 初,大规模推理)、M300(2027 初,多模态训推);天池 256/512 超节点 2026 落地(512 单节点可训万亿参数模型)。
- 寒武纪思元 690(5nm)、海光深算三号 BW1000、燧原 L600 量产后邃思系列迭代接续推进。
二、性能参数横向对比:算力追平,显存反超
先用一张图看全局:下图统一口径对比稠密 FP16 算力与显存容量,并附逐项标注来源的"核心规格汇总"表。
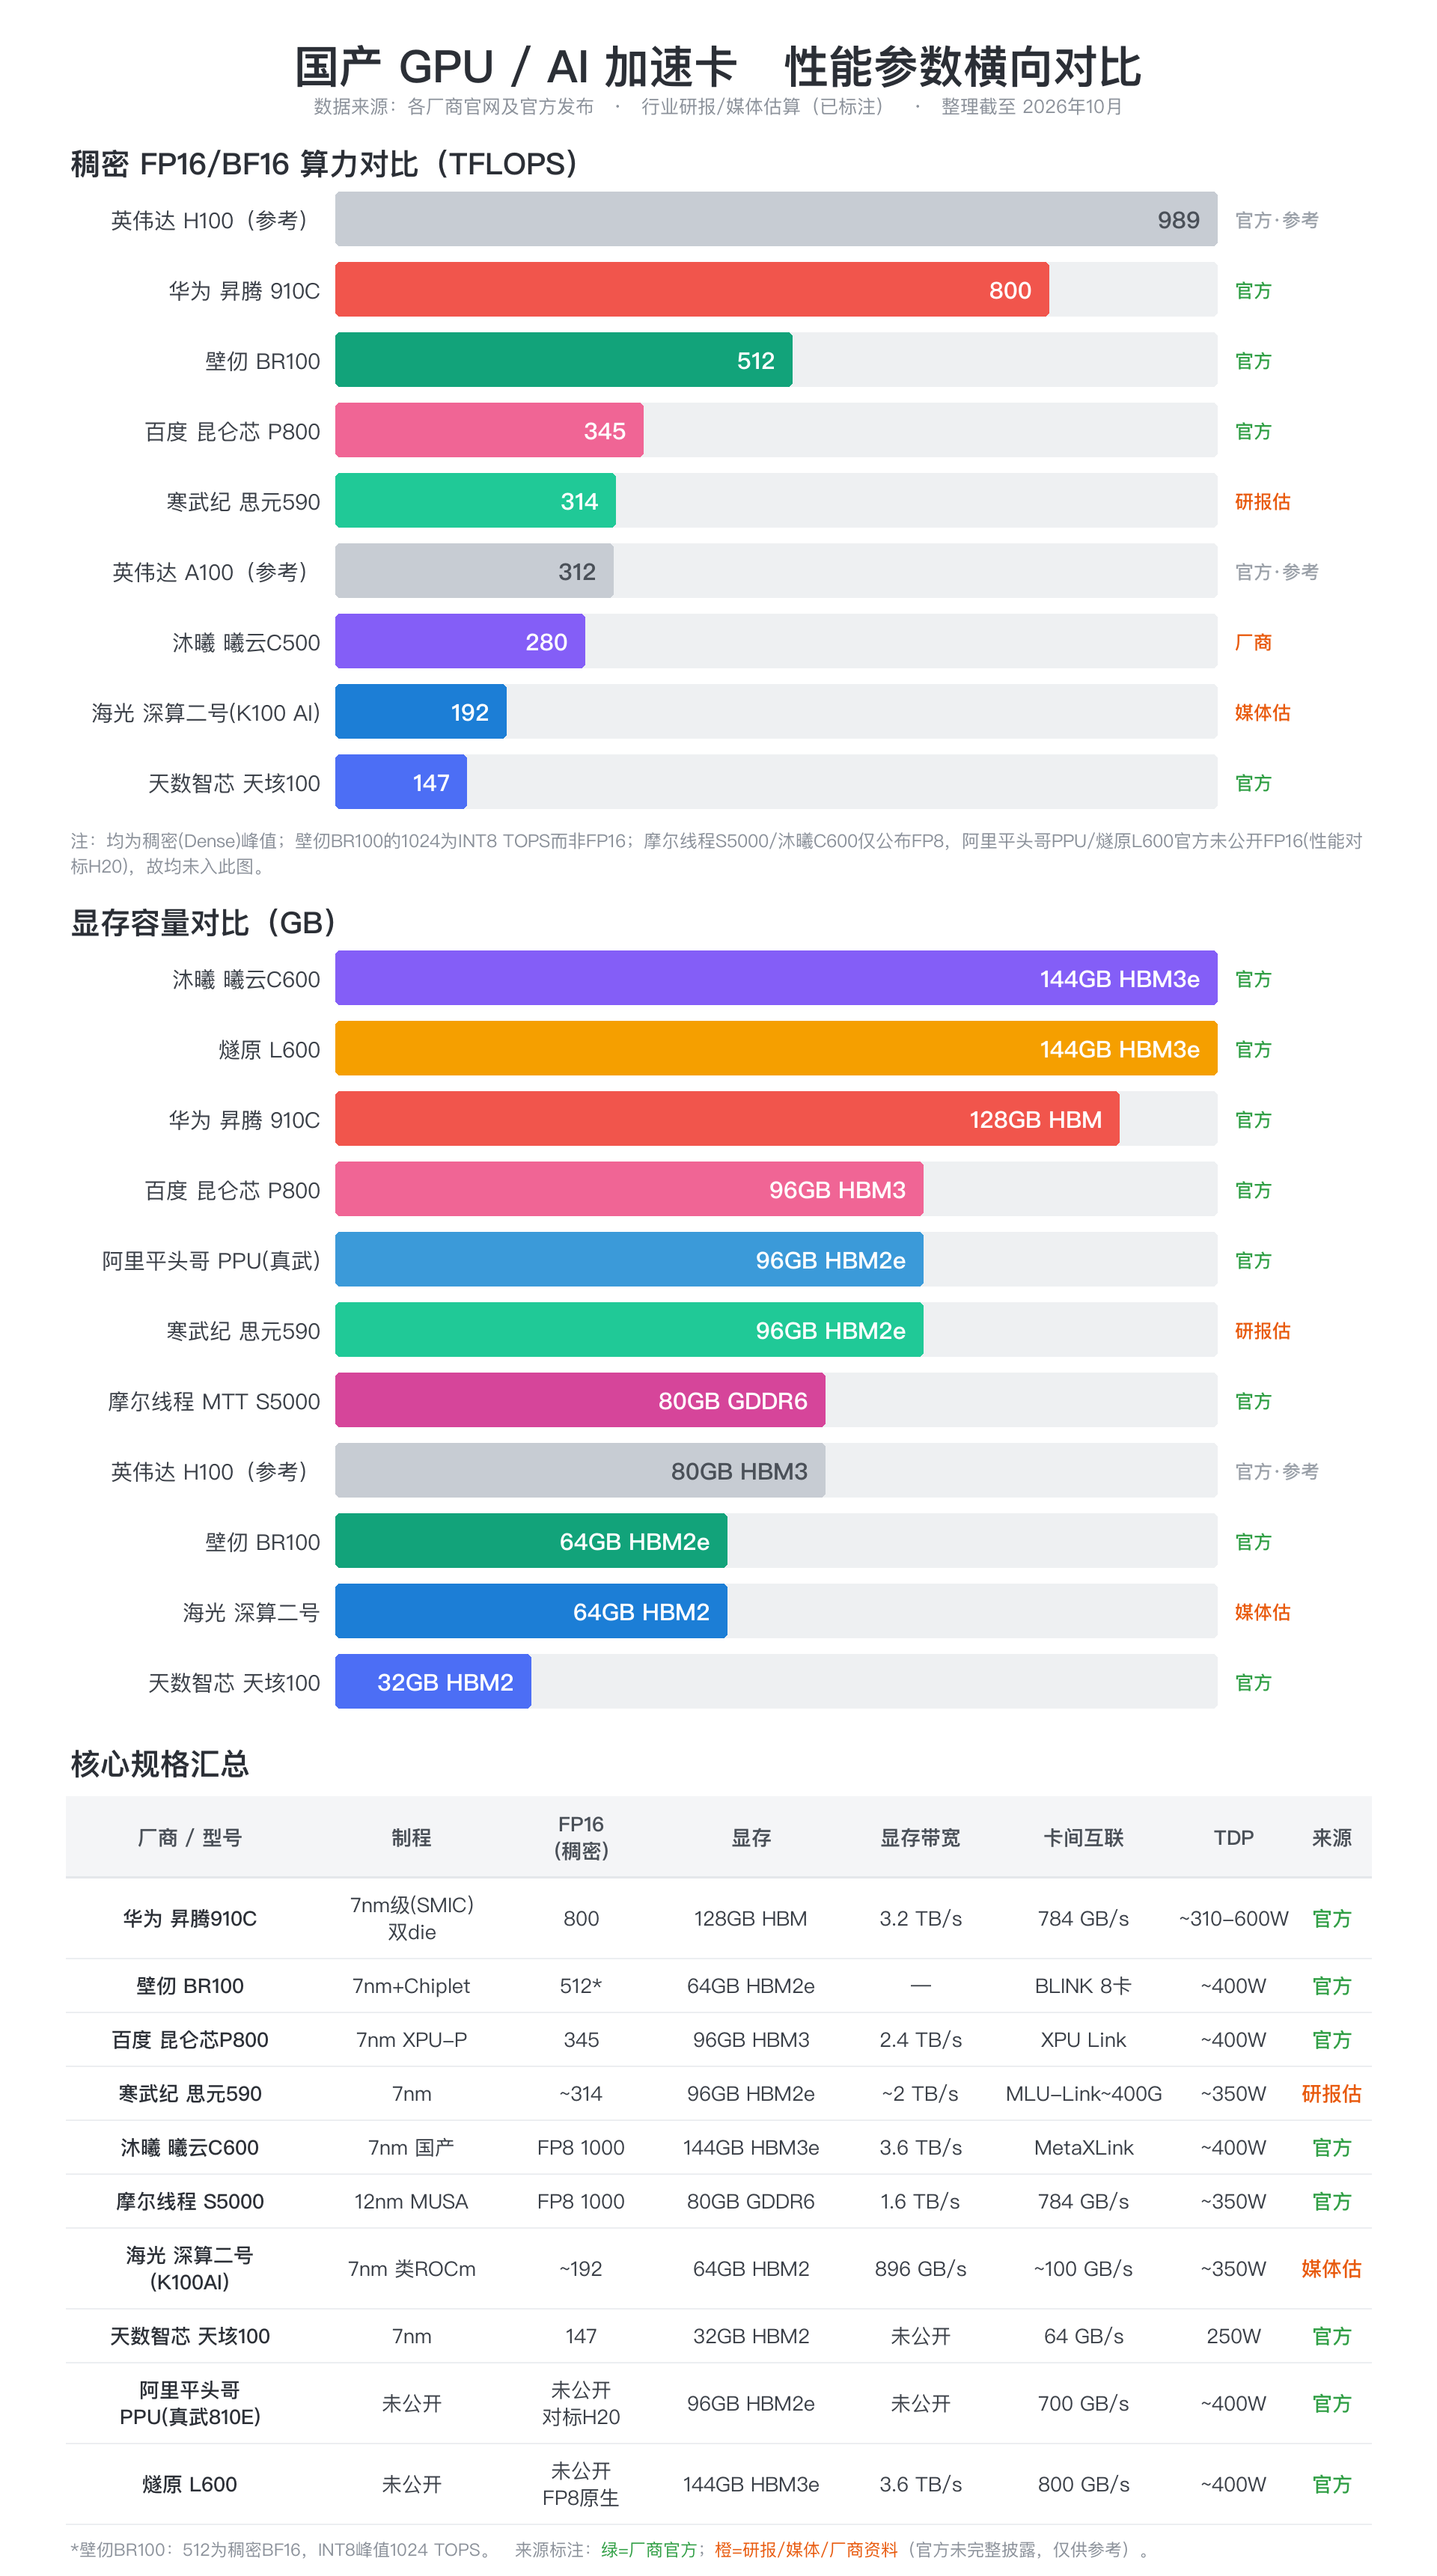
稠密 FP16/BF16 算力(TFLOPS,统一口径):
- 华为昇腾910C:800(官方,华为全联接大会2025)
- 壁仞BR100:512(官方,稠密BF16)— 注:媒体常引用的"1024"实为 INT8 TOPS,并非FP16
- 百度昆仑芯P800:345(官方)
- 寒武纪思元590:约 314(研报估算,官方未完整披露,范围约256–345)
- 沐曦曦云C500:280(厂商资料)
- 海光深算二号K100-AI:约 192(媒体/研报)
- 天数智芯天垓100:147(厂商/百度百科)
- 参考:英伟达 A100 312、H100 989(稠密FP16)
口径提醒:摩尔线程S5000、沐曦C600官方仅公布 FP8 1000 TFLOPS(PFLOPS级),未公布稠密FP16,故未并入FP16柱状对比,避免跨精度误导。
显存容量(GB)——国产的意外亮点,部分型号反超国际主流:
- 沐曦曦云C600 / 燧原L600:144GB HBM3e(官方,并列最大)
- 华为昇腾910C:128GB HBM(官方)
- 百度昆仑芯P800:96GB HBM3(官方)
- 阿里平头哥PPU(真武810E):96GB HBM2e(官方)
- 寒武纪思元590:96GB HBM2e
- 摩尔线程S5000:80GB GDDR6(非HBM,官方)
- 壁仞BR100:64GB HBM2e
- 海光深算二号:64GB HBM2
- 天数天垓100:32GB HBM2
备注:HBM 的"职级”(代际)是什么?
HBM(High Bandwidth Memory,高带宽显存)是专为 GPU/AI 加速卡设计的堆叠式显存,通过 2.5D 封装与芯片做在一起,带宽远高于 GDDR。名字里的数字和后缀代表代际与改良版,越新带宽越高、单堆容量越大:
- HBM(第1代,2015):初代,带宽/容量最低,现已基本淘汰。
- HBM2(第2代,2016):主流化起点,单堆带宽约 256 GB/s;A100、海光深算二号、天数天垓100 等采用。
- HBM2e(HBM2 增强版,2020):e = enhanced,提频提容,单堆带宽约 450 GB/s;壁仞BR100、寒武纪590、阿里平头哥PPU 等采用。
- HBM3(第3代,2022):单堆带宽约 800 GB/s,容量更大;昆仑芯P800 采用。
- HBM3e(HBM3 增强版,2024):e = enhanced,当前量产最强,单堆带宽约 1 TB/s+;英伟达 H200/B200、沐曦C600、燧原L600 等采用。
- 下一代 HBM4(2026 前后)将进一步翻倍带宽。
简记:HBM → HBM2 → HBM2e → HBM3 → HBM3e → HBM4,数字升级代表换代,
e后缀代表同代的增强版;越靠右,带宽越高、越新。昇腾910C 文中只标"HBM"是因华为未公开具体代际。另外,GDDR6(如摩尔线程S5000)是显卡常用的另一类显存,成本低但带宽显著低于 HBM,不属于 HBM 家族。
上表 10 家厂商中,有两家因口径特殊需要单独说明:
- 阿里平头哥 PPU(真武810E):官方公布 96GB HBM2e、片间互联 700 GB/s、PCIe 5.0×16、功耗约400W;FP16未公开,公开报道称整体性能"与英伟达H20相当、升级版强于A100",已在阿里云多个万卡集群部署、服务400+客户。
- 燧原科技 L600(第四代"邃思400"):官方公布 144GB 存储、3.6 TB/s 带宽、800 GB/s 互联、原生FP8;FP16未公开,性能对标H20。上一代推理卡S60已出货超10万片。
- 口径一致性:平头哥PPU、燧原L600因官方未披露稠密FP16,未并入FP16柱状图,仅进入"核心规格汇总"表(已标注"未公开"),避免跨精度误导。
通信 / 带宽:
- 显存带宽:昇腾910C 3.2 TB/s、沐曦C600 3.6 TB/s、昆仑芯P800 2.4 TB/s、寒武纪590 约2 TB/s、沐曦C500 1.8 TB/s、摩尔S5000 1.6 TB/s、海光K100-AI 896 GB/s。
- 卡间互联:昇腾910C 784 GB/s(HCCS)、摩尔线程S5000 784 GB/s、寒武纪MLU-Link 约400–500 GB/s、天数天垓100 仅 64 GB/s。
- 参考差距:英伟达 NVLink 900 GB/s(H100)起步,国产卡间互联仍落后约1代,这也是华为等走"超节点集群化"路线弥补单卡互联的根因。
详见图中"核心规格汇总"表(含制程/FP16/显存/显存带宽/卡间互联/TDP/来源逐项标注)。
三、落地场景与市场格局:用财报与出货说话
参数之外,真正说明问题的是场景、营收与份额。下图左侧是五大核心落地场景,右侧依次为 2025 年营收、第三方机构市场格局与 DeepSeek 适配情况。
五大落地场景:电信运营商智算中心、互联网大厂 AI 基础设施、政务云与东数西算、金融与关键行业(海光 x86 生态)、云游戏与云桌面(摩尔线程 vGPU)——覆盖了国产算力从"集采风向标"到"信创末端"的主要需求面。
2025 全年营收(公开年报/业绩快报):海光信息 143.77 亿(+57%,净利 25.45 亿)、寒武纪 64.97 亿(+453%,上市后首次年度盈利 20.59 亿)、沐曦 16.44 亿(+121%)、摩尔线程 15.05 亿;壁仞、天数智芯等尚未上市、无公开年报,故不列。
市场格局(第三方机构口径):2025 年国产 AI 加速卡出货约 165 万张、占国内约 41%(IDC);Bernstein、TrendForce 等预测 2026 年华为昇腾份额升至约 50%、英伟达降至约 8%,寒武纪 / 海光 / 平头哥 / 昆仑芯居第二梯队。
生态拐点:DeepSeek V3/V4 发布后已有超百家厂商实现"Day 0 接入",本文覆盖的 10 家国产厂商(昇腾 / 沐曦 / 壁仞 / 天数 / 摩尔线程 / 海光 / 燧原 / 昆仑芯 / 平头哥 / 寒武纪)均已完成适配。
四、Chiplet:突破制程限制的国产方案
既然先进制程被卡,国产怎么把算力堆上去?答案是先进封装。下图以壁仞 BR100 的 2.5D CoWoS 为例,拆解 Chiplet 的架构、优劣势与挑战。
核心原理:以壁仞BR100为例,7nm、770亿晶体管、Chiplet+2.5D CoWoS封装,在硅中介层上集成多个计算核心 + HBM,用成熟工艺逼近先进制程性能。
Chiplet vs 传统单片:可混合多种制程、小芯片良率更高、硅中介层高速互联、按需灵活组合、成本结构向封装倾斜。
采用方代表(按封装路线区分):壁仞BR100(Chiplet + 2.5D CoWoS,硅中介层)、沐曦C600(2.5D)、华为昇腾910C(双die 共封装,有机基板互联);寒武纪思元690亦被列为 Chiplet 方案,但为研报估算,官方未完整披露,谨慎引用。
四大挑战:2.5D CoWoS封装成本高、多芯片散热密度大、系统级互联设计复杂、先进封装产能仍依赖台积电等海外厂商。
五、未来发展趋势:五个确定性方向(对标国际前沿)
技术大方向由全球前沿共同牵引,下面每条先给国际先进方案(主要是 NVIDIA)作锚点,再落到国产对标/路线,便于看清"追赶在哪、差距多大、国产特殊性在哪"。
集群规模持续跃升
- 国际前沿:NVIDIA GB200 NVL72 机柜级整机(72 GPU 全互联,NVLink 5 单卡 1.8 TB/s 双向),xAI/Meta 已落地 10 万卡级集群。
- 国产方向:卡间互联仍落后约 1 代,华为昇腾 Atlas 950/960 以"超节点 + 集群化“弥补单卡互联短板,剑指万卡→十万卡,超大规模互联成竞争焦点。
Chiplet / 先进封装成主流
- 国际前沿:NVIDIA Blackwell 采用双 die(NV-HBI 10 TB/s 片内互联)+ CoWoS-L,Rubin 延续多 die 封装路线。
- 国产方向:制程受限下,2.5D/3D 封装(壁仞 Chiplet、昇腾910C 双 die、沐曦 C600)是绕过制程封锁、突破算力天花板的核心手段。
大显存与高带宽
- 国际前沿:B200 192GB HBM3e、约 8 TB/s 带宽,Rubin 将升级到 HBM4。
- 国产方向:昇腾 128GB、沐曦 C600 / 燧原 L600 144GB HBM3e 已在容量上局部反超,验证"大显存适配大模型"路线。
供应链自主:自研 HBM(国产独有命题)
- 国际现状:NVIDIA 不自研 HBM,直接向海力士/三星/美光采购,无此卡点。
- 国产方向:受制裁影响,HBM 是国产最大卡点之一,华为昇腾 950 起采用自研 HBM,属被动突破而非跟随国际——这正是国产路线与国际的关键分叉。
软件生态加速成熟
- 国际前沿:CUDA 近 20 年沉淀,是 NVIDIA 最深的护城河。
- 国产方向:昇腾 CANN、昆仑 XPU 等自有栈 + DeepSeek 全面适配,标志”硬件可用→软件好用“的转折,但与 CUDA 生态差距仍大。
六、总结
国产GPU已完成"0到1”,正处"1到N"的规模化放量:头部算力追平国际主流、大显存反超、Chiplet绕过制程封锁、三大场景规模化落地。
核心矛盾仍在先进封装产能、HBM供应与软件生态三大环节尚未完全自主——这也正是昇腾自研HBM、沐曦全国产供应链等动作的指向。
数据来源:各厂商官网/官方发布会、公开财报(海光688041、寒武纪688256、沐曦688802、摩尔线程年报/业绩快报)、招投标公告,以及 IDC、Bernstein、TrendForce 等第三方机构研报整理(截至2026年10月)。标注为"研报估/媒体估"或"机构预测"的数值因官方未完整披露,仅供参考,可能与最终官方数据存在差异。
附:各家国产GPU厂商官网
建议以下列官方渠道为准核对最新规格:
- 华为昇腾(Ascend):https://www.hiascend.com
- 壁仞科技(Biren):https://www.birentech.com
- 寒武纪(Cambricon):https://www.cambricon.com
- 百度昆仑芯(Kunlunxin):https://www.kunlunxin.com
- 摩尔线程(Moore Threads):https://www.mthreads.com
- 沐曦(MetaX):https://www.metax-tech.com
- 海光信息(Hygon):https://www.hygon.cn
- 天数智芯(Iluvatar CoreX):https://www.iluvatar.com
- 阿里平头哥(T-Head):https://www.t-head.cn
- 燧原科技(Enflame):https://www.enflame-tech.com