写在前面
把一个 70 亿参数的模型跑在一张消费级显卡上,或者把推理吞吐翻几倍、显存砍一半——背后几乎都离不开一个词:量化(Quantization)。
量化的本质,是用更少的比特数(bit)表示原本用 FP32/FP16 存储的权重和激活。FP32 一个数占 4 字节,INT8 只占 1 字节,INT4 只占半字节。比特数降下来,显存占用、带宽压力、计算延迟一起降,而精度只掉一点点——这就是量化的性价比。
但「少用比特」这件事远没有听起来简单。它牵扯一整套概念:怎么把连续的浮点值映射到离散的整数?映射要不要带偏移(对称 vs 非对称)?一个 scale 管一整个张量还是每个通道一个(per-tensor vs per-channel)?什么时候算 scale(动态 vs 静态)?不重训(PTQ)还是边训边量化(QAT)?
这篇文章先讲地基层(基础概念),再讲通用范式(PTQ/QAT)——因为下篇要讲的 GPTQ、AWQ、SmoothQuant、NF4 这些大模型专用方案,全都建立在这两层之上。理解了地基,LLM 量化就不再是黑盒。
术语约定
x:待量化的浮点值(权重或激活);q:量化后的整数值。scale(缩放因子):浮点与整数之间的比例;zero_point(零点,简称 zp):整数域中对应浮点 0 的位置。q_min / q_max:整数类型的取值边界,如 INT8 对称为[-127, 127],非对称为[0, 255]或[-128, 127]。- W 指权重(Weight),A 指激活(Activation)。
W8A8表示权重和激活都量化到 8-bit;W4A16表示权重 4-bit、激活保持 16-bit。
0. 全局对比表:先建立全景
下图把本系列(上+下)涉及的所有方法先摆出来。上篇讲前两类(基础 / 范式),下篇讲 LLM 专用。
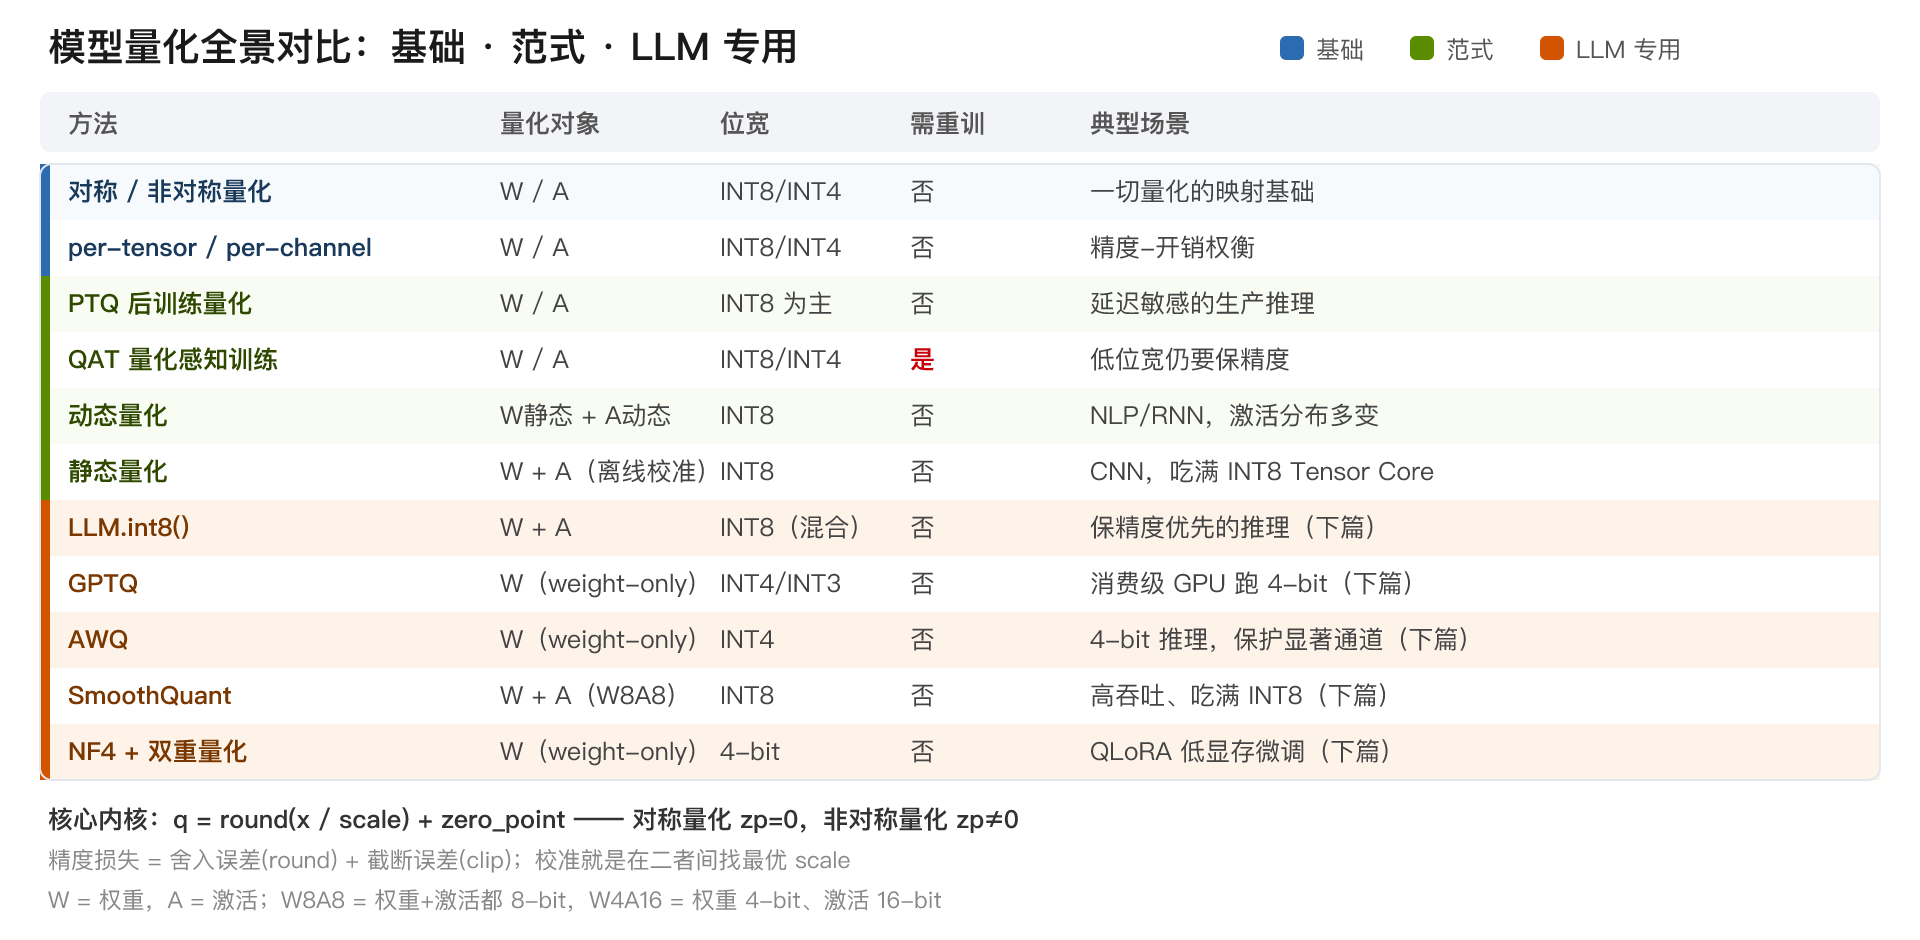
三句话抓住上篇:
- 均匀量化都是一次仿射映射
q = round(x / scale) + zero_point:对称量化zp=0,非对称量化zp≠0(下篇的 NF4 等非均匀量化是例外,格点不等距)。 - 精度损失来自两处:舍入误差(round)和截断误差(clip);scale 选大了截断少但舍入粗,选小了舍入细但截断多——校准就是在找这个平衡点。
- 范式二选一:PTQ 不重训、拿校准集统计一下就上,便宜;QAT 边训边插伪量化节点,贵但低位宽也能保精度。
1. 基础概念:一切量化的地基
1.1 浮点与定点表示
1. 定义与语义
一句话:用更少的 bit 表示一个数值。不同格式在「动态范围」和「精度」之间做不同取舍。
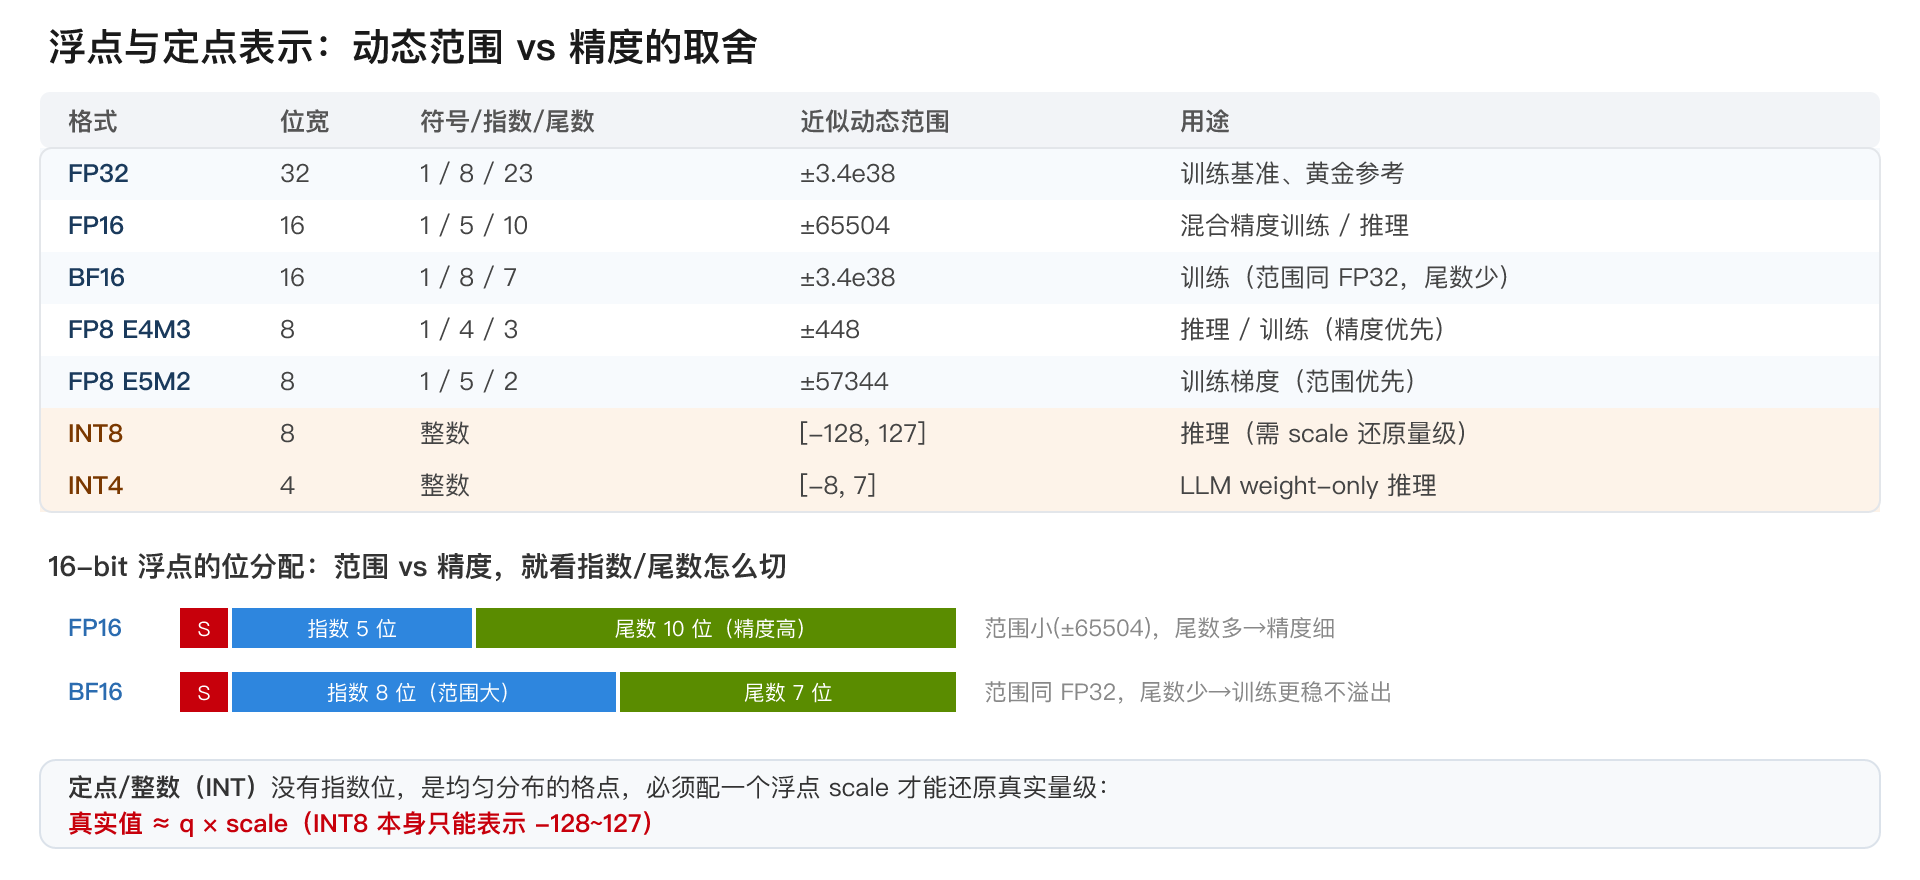
关键区别:
- 浮点(FP):指数位决定动态范围,尾数位决定精度。BF16 和 FP16 都占 16 bit,但 BF16 把更多位分给指数——所以 BF16 范围和 FP32 一样大,不易溢出,代价是尾数只有 7 位、精度更粗。训练中 BF16 比 FP16 更稳就是这个原因。
- 定点/整数(INT):没有指数位,数值是均匀分布的格点。INT8 本身只能表示 -128~127,必须配一个浮点
scale才能还原真实量级:真实值 ≈ q × scale。
2. 为什么量化能加速
三个层面,缺一不可:
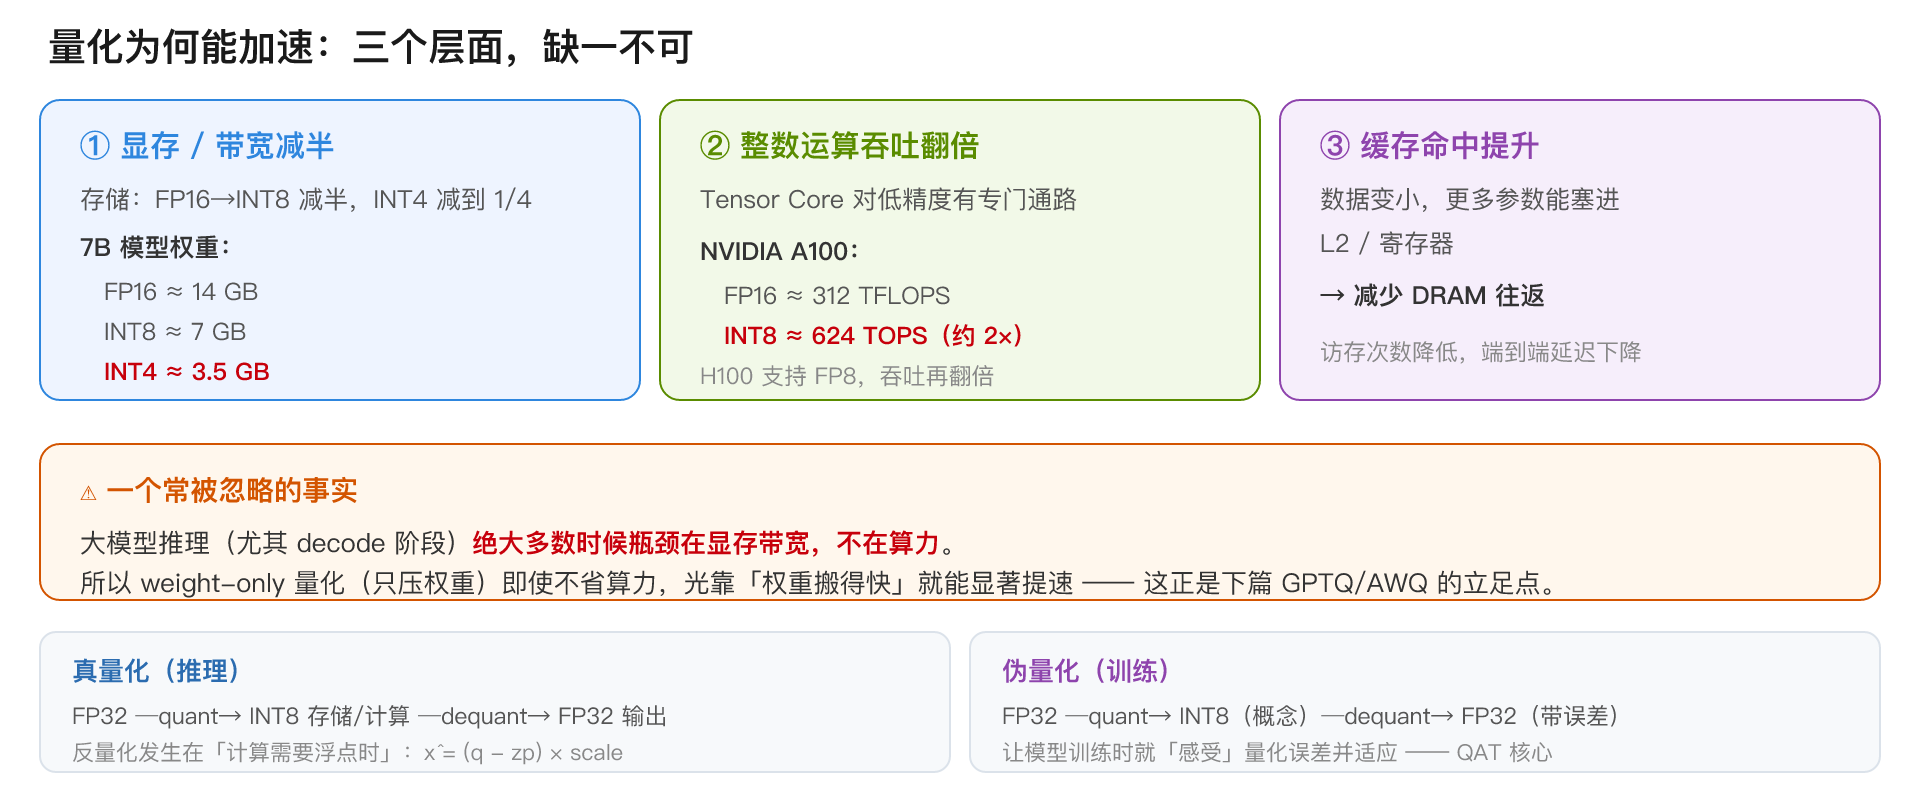
- 显存/带宽:FP16→INT8 存储减半,INT4 减到 1/4。一个 7B 模型权重:FP16 ≈ 14 GB,INT8 ≈ 7 GB,INT4 ≈ 3.5 GB。搬运同样多的参数,字节数少一半 → 访存延迟减半。
- 整数运算吞吐:Tensor Core 对低精度有专门通路。NVIDIA A100:FP16 ≈ 312 TFLOPS,INT8 ≈ 624 TOPS(约 2×);H100 还支持 FP8,吞吐再翻倍。
- 缓存命中:数据变小,更多参数能塞进 L2/寄存器 → 减少 DRAM 往返。
一个常被忽略的事实:大模型推理(尤其 decode 阶段)绝大多数时候瓶颈在显存带宽,不在算力。所以 weight-only 量化(只压权重、激活仍是 FP16)即使不省算力,光靠「权重搬得快」就能显著提速——这正是下篇 GPTQ/AWQ 的立足点。
3. 反量化与伪量化
- 反量化(Dequantization):把整数还原回浮点,
x_hat = (q - zero_point) × scale。它发生在计算需要浮点时。比如 INT8 矩阵乘,Tensor Core 内部用 INT8 累加成 INT32,最后一步再乘 scale 反量化回 FP16/FP32 输出。 - 伪量化(Fake Quantization):训练时用的「假量化」。它做一次「量化再立刻反量化」
x → q → x_hat,数据类型还是 FP32,但数值已经经历了量化误差。作用是让模型在训练时就『感受』到量化误差并适应它——这正是 QAT 的核心手段(见 3.2)。
真量化(推理):
FP32 ─quant→ INT8 存储/计算 ─dequant→ FP32 输出;伪量化(训练):FP32 ─quant→ INT8(概念)─dequant→ FP32(带误差,继续反向传播)。两者对比见上图右下。
1.2 量化映射:仿射映射
1. 定义与语义
一句话:把浮点值 x 通过仿射变换映射到整数 q。
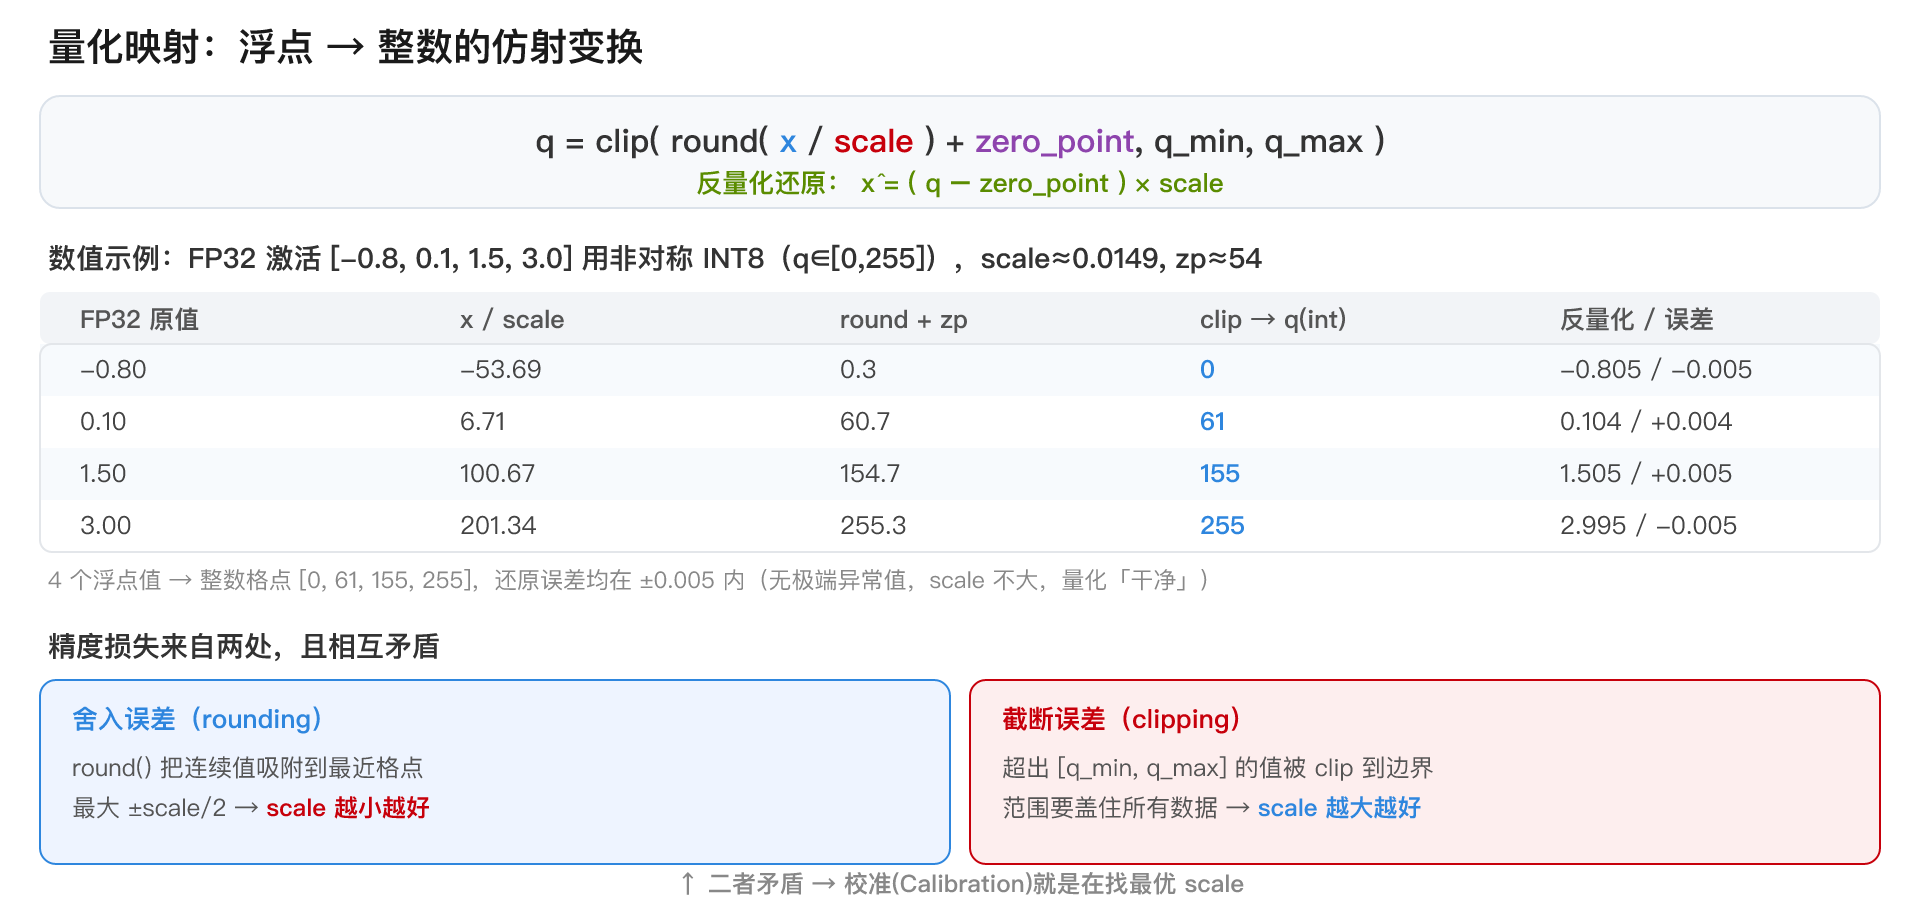
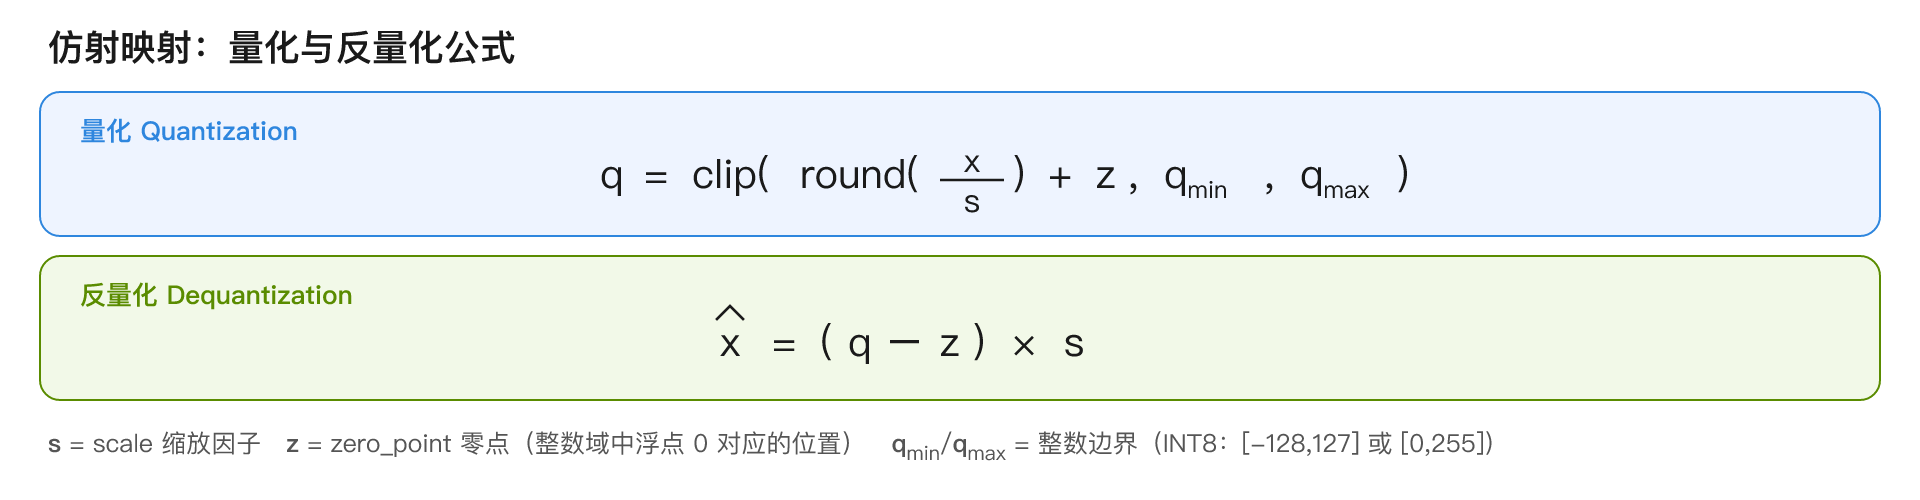
其中 s 为 scale(缩放因子),z 为 zero_point(零点,整数域中浮点 0 对应的位置)。
数值示例:设某组 FP32 激活值 x = [-0.8, 0.1, 1.5, 3.0],用非对称 INT8(q∈[0,255])量化,得到 scale≈0.0149, zp≈54。原始 4 个浮点值被映射到 [0, 61, 155, 255] 这 4 个整数格点,还原后误差最大约 ±0.005(详见上图数值表)——因为这组数据没有极端异常值,scale 不大,量化很「干净」。
下面把这个示例一步步算透(所有数都可手算验证)。
第 1 步:定 scale(缩放因子)——用数据真实的最小/最大值撑满整个整数区间:
x_min = -0.8,x_max = 3.0scale = (x_max − x_min) / (q_max − q_min) = 3.8 / 255 ≈ 0.0149
含义:整数每跳 1 格,浮点就变化约 0.0149。
第 2 步:定 zero_point(零点)——回答「浮点 0 落在整数轴哪个位置」:
zp = q_min − round(x_min / scale) = 0 − round(-0.8 / 0.0149) = -(-54) = 54
含义:整数 54 代表浮点 0。因为有负值 -0.8,得把 0 右推 54 格给负半轴腾空间——这正是「非对称」的意义。
第 3 步:逐个量化 q = round(x / scale) + zp:
| 浮点 x | x / scale | round() | + zp(54) | 整数 q |
|---|---|---|---|---|
| -0.8 | -53.68 | -54 | -54+54 | 0 |
| 0.1 | 6.71 | 7 | 7+54 | 61 |
| 1.5 | 100.66 | 101 | 101+54 | 155 |
| 3.0 | 201.32 | 201 | 201+54 | 255 |
最小值 -0.8 正好落在 0、最大值 3.0 正好落在 255,整个 [0,255] 被用满——这是非对称量化精度高的来源。
第 4 步:反量化验证 x̂ = (q − zp) × scale:
| 整数 q | (q − 54) × scale | 还原 x̂ | 原值 x | 误差 |
|---|---|---|---|---|
| 0 | -54 × 0.0149 | -0.8047 | -0.8 | 0.0047 |
| 61 | 7 × 0.0149 | 0.1043 | 0.1 | 0.0043 |
| 155 | 101 × 0.0149 | 1.5051 | 1.5 | 0.0051 |
| 255 | 201 × 0.0149 | 2.9953 | 3.0 | 0.0047 |
还原误差最大约 0.005,都在量化步长一半(scale/2 ≈ 0.0075)以内——这是舍入误差的理论上界。
为什么量化得「干净」:关键在没有异常值。数据跨度只有 3.8,scale 被压得很小(0.0149),格点密、误差小。反过来,若混进一个
50,x_max变 50,scale 立刻被撑到50.8/255 ≈ 0.199(13 倍),-0.8 / 0.1 / 1.5这些小值挤在相邻几格里,误差放大十几倍——这正是 3.4 节「异常值为什么致命」的核心矛盾。
2. 底层原理与算法
整个映射由两个参数决定:scale 和 zero_point。它们的计算方式取决于对称还是非对称(见 1.3)。核心是让浮点区间 [x_min, x_max] 对齐到整数区间 [q_min, q_max]。
误差来源拆解(见上图下半部分):总误差 = 舍入误差(rounding) + 截断误差(clipping)。舍入误差来自 round() 把连续值吸附到最近格点(最大 ±scale/2,scale 越小越好);截断误差来自超出 [q_min, q_max] 的值被 clip 到边界(范围要盖住所有数据,scale 越大越好)。二者矛盾,校准(Calibration)就是在找最优 scale(见 3.4)。
1.3 对称量化 vs 非对称量化
1. 定义与语义
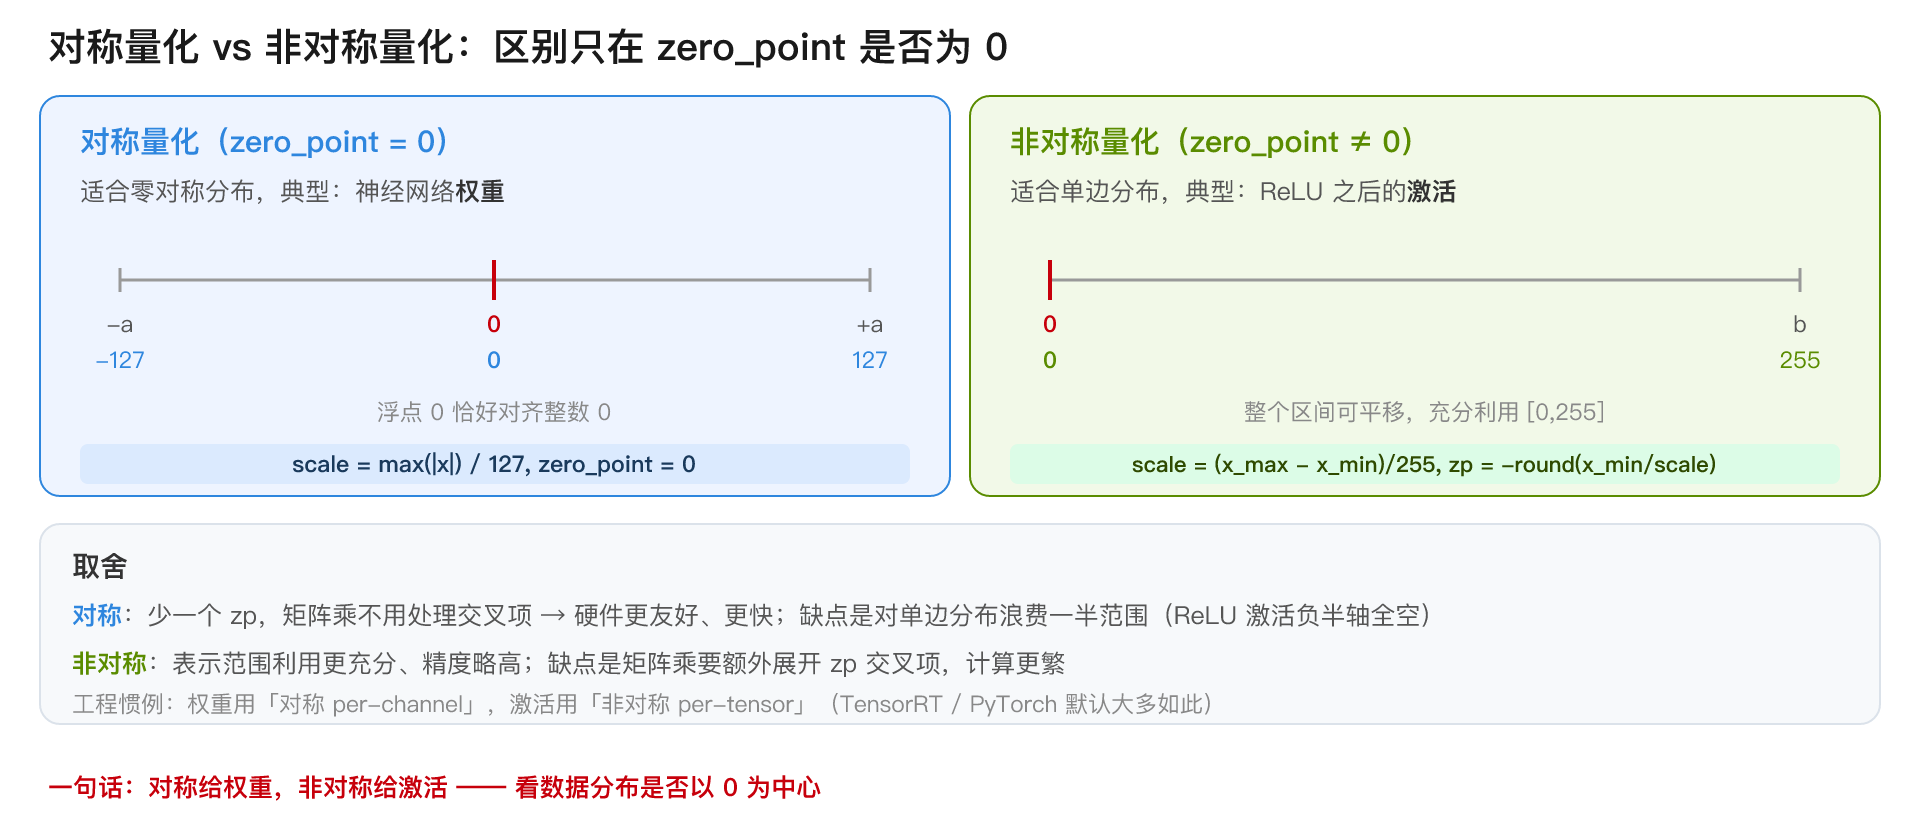
区别只在一处:zero_point 是不是 0。
- 对称量化:
zero_point = 0。浮点 0 直接映射到整数 0。适合零对称分布的数据,典型是神经网络的权重(通常以 0 为中心、正负大致对称)。 - 非对称量化:
zero_point ≠ 0,允许整个区间平移。适合非对称/单边分布的数据,典型是 ReLU 之后的激活(全是非负数,范围如[0, 6])。
2. 底层原理与算法
对称量化(整数范围取对称的 [-127, 127],留出 -128 不用以保证对称):
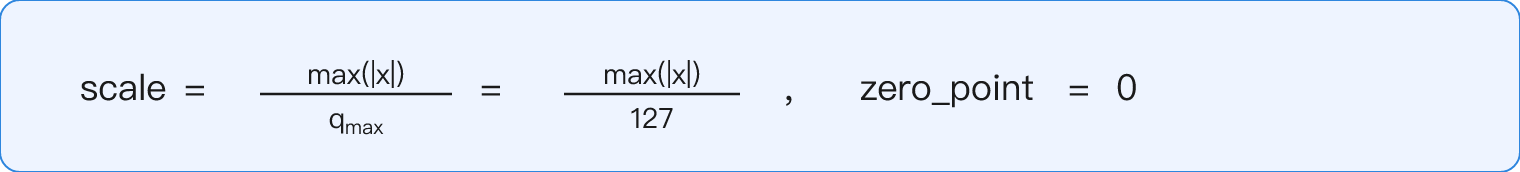
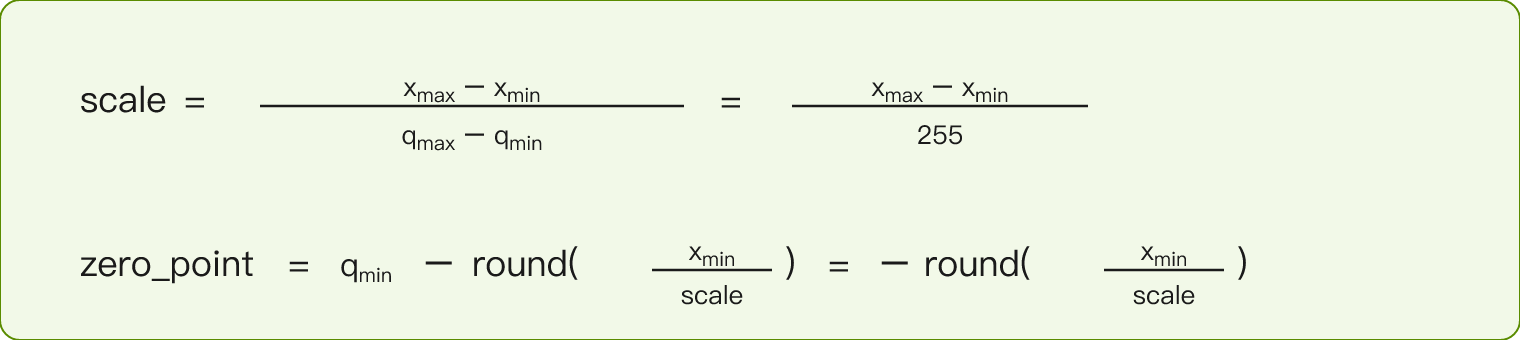
非对称量化(整数范围 [0, 255]):
取舍:
- 对称量化少一个 zp,矩阵乘时不用处理交叉项(
(q_x·scale_x)·(q_w·scale_w)直接整数乘再乘 scale),硬件更友好、更快。缺点是对单边分布浪费一半表示范围(如 ReLU 激活全正,对称量化的负半轴全空着)。 - 非对称量化表示范围利用更充分,精度略高,但矩阵乘要额外展开 zp 的交叉项,计算更繁。
工程惯例:权重用对称 per-channel,激活用非对称 per-tensor(或对称,取决于硬件)。TensorRT、PyTorch 默认大多如此。
1.4 逐张量 vs 逐通道(per-tensor / per-channel)
1. 定义与语义
指的是 scale 的粒度——一个 scale 管多大一片数据。
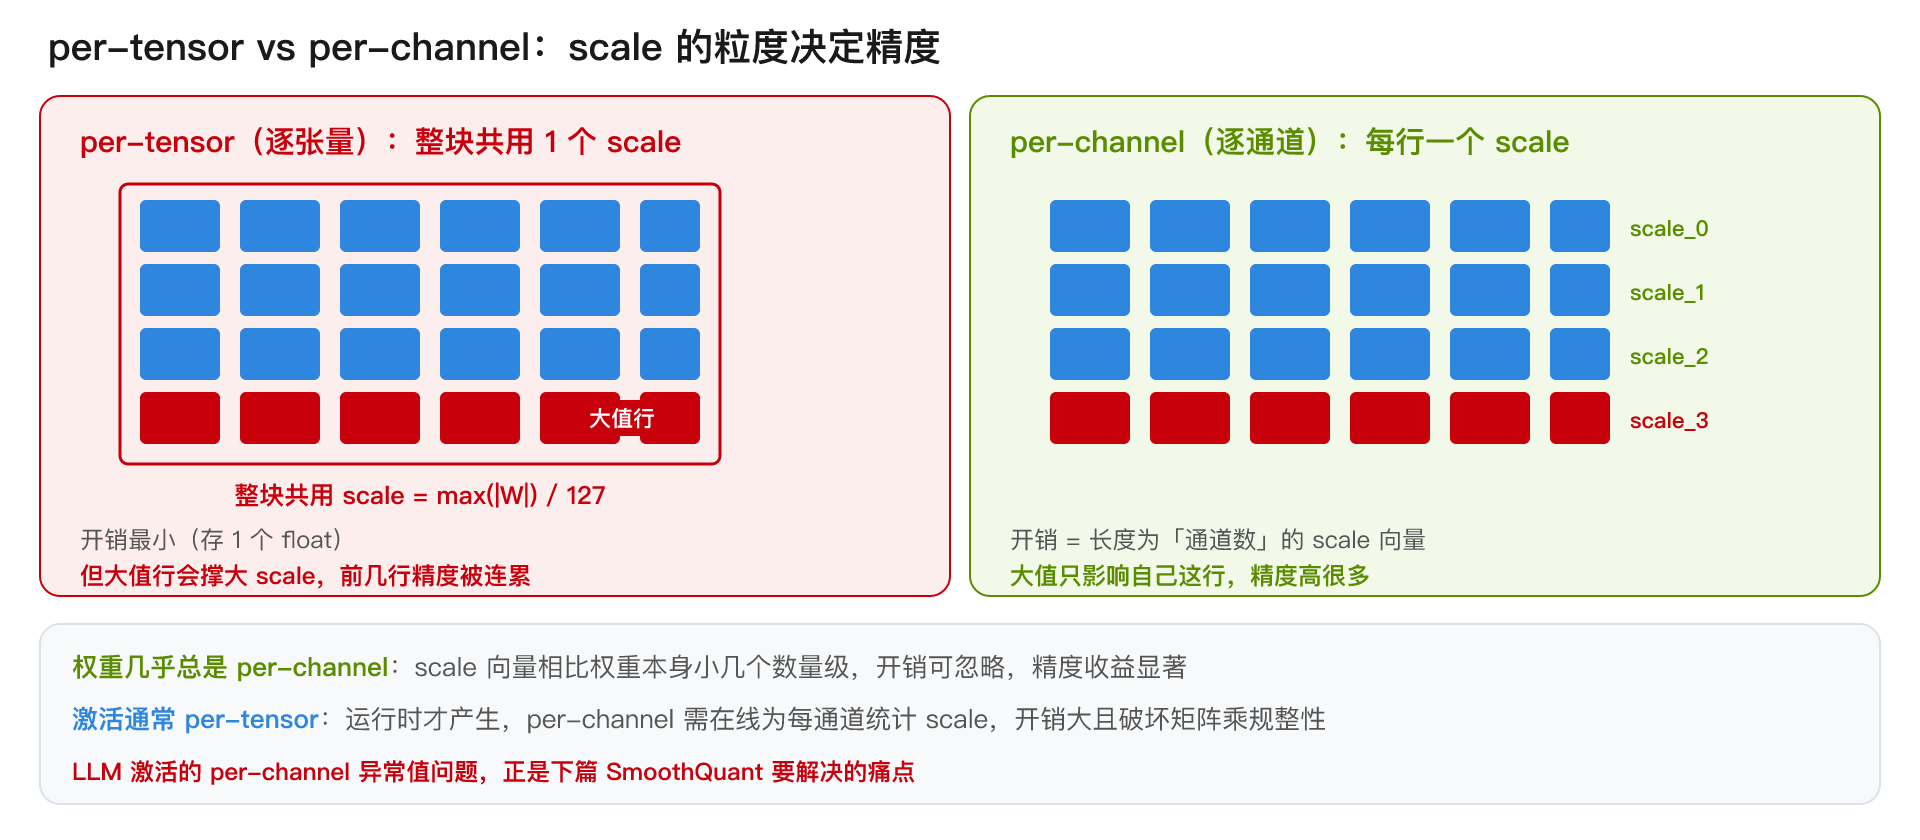
- per-tensor(逐张量):整个张量共用一个 scale。开销最小(存一个 float),但只要有一个通道数值特别大,就会把 scale 撑大,其他通道精度被连累。
- per-channel(逐通道):每个输出通道(权重的每一行 / 每个卷积核)单独一个 scale。精度高很多,开销是一个长度为「通道数」的 scale 向量。
2. 取舍
- 权重几乎总是 per-channel:开销可忽略(scale 向量相比权重本身小几个数量级),精度收益显著。
- 激活通常 per-tensor:因为激活是运行时才产生的,per-channel 需要在线为每个通道统计 scale,开销大且破坏矩阵乘的规整性。LLM 激活的 per-channel 异常值问题,正是下篇 SmoothQuant 要解决的痛点。
3. 延伸:per-token — 激活侧的细粒度
per-tensor / per-channel 只是「粒度」这把尺子的两端,中间还有一档专门服务激活的 per-token(逐 token):沿序列维度,每个 token 一个 scale(一条 [N_tokens, hidden] 的激活就有 N_tokens 个 scale)。
它和 per-channel 本质是同一件事在不同对象、不同维度上的应用,区别在三点:
- 作用对象:per-channel 多用于权重(静态,离线算好);per-token 用于激活(动态,运行时随输入现算)。
- 切分维度:权重 per-channel 切输出通道维,激活 per-token 切token维。
- 为什么这么切:矩阵乘
Y = XW沿hidden维求和,只有把 scale 加在非求和维(激活的 token 维、权重的输出通道维)上,反量化才能提到求和外面——Y[t,o] = s_x[t] · s_w[o] · (X_q W_q)[t,o],其中s_x按 token、s_w按输出通道,都是向量;因二者都与求和维hidden无关,可整体提到整数 GEMM 外面,不破坏 GEMM。
这正是 W8A8 的经典搭配 —— 激活 per-token + 权重 per-channel(LLM.int8()、SmoothQuant 都用它)。一句话记忆:在求和维上保持粗粒度(per-tensor),在正交维上做细粒度(per-channel / per-token),是精度与 kernel 效率的最佳平衡。
2. 实战:从零实现量化与反量化
下面这段不依赖任何量化库,纯手工实现对称/非对称量化,帮你把前面的公式跑通。复制即可运行。
# file: quant_from_scratch.py
# 运行: python quant_from_scratch.py   (只需 torch)
# 依赖: pip install torch
import torch

def quantize_symmetric(x: torch.Tensor, num_bits: int = 8):
    """对称量化: zero_point=0, 整数范围 [-(2^(b-1)-1), 2^(b-1)-1]"""
    qmax = 2 ** (num_bits - 1) - 1          # INT8 -> 127
    scale = x.abs().max() / qmax            # scale = max(|x|)/127
    q = torch.round(x / scale).clamp(-qmax, qmax)   # 量化: round + clip
    return q.to(torch.int32), scale

def dequantize_symmetric(q, scale):
    return q.float() * scale                # 反量化: q * scale

def quantize_asymmetric(x: torch.Tensor, num_bits: int = 8):
    """非对称量化: 整数范围 [0, 2^b-1]"""
    qmin, qmax = 0, 2 ** num_bits - 1       # INT8 -> [0, 255]
    x_min, x_max = x.min(), x.max()
    scale = (x_max - x_min) / (qmax - qmin)
    zero_point = torch.round(qmin - x_min / scale).clamp(qmin, qmax)
    q = torch.round(x / scale + zero_point).clamp(qmin, qmax)
    return q.to(torch.int32), scale, zero_point

def dequantize_asymmetric(q, scale, zero_point):
    return (q.float() - zero_point) * scale

if __name__ == "__main__":
    torch.manual_seed(0)
    x = torch.tensor([-0.8, 0.1, 1.5, 3.0])
    print("原始 FP32 :", x.tolist())

    # ---- 对称 ----
    q_s, s_s = quantize_symmetric(x)
    x_hat_s = dequantize_symmetric(q_s, s_s)
    print("\n[对称] scale = %.6f" % s_s.item())
    print("  量化后 INT8 :", q_s.tolist())
    print("  反量化      :", [round(v, 4) for v in x_hat_s.tolist()])
    print("  最大误差    : %.6f" % (x - x_hat_s).abs().max().item())

    # ---- 非对称 ----
    q_a, s_a, zp_a = quantize_asymmetric(x)
    x_hat_a = dequantize_asymmetric(q_a, s_a, zp_a)
    print("\n[非对称] scale = %.6f, zero_point = %d" % (s_a.item(), int(zp_a)))
    print("  量化后 INT8 :", q_a.tolist())
    print("  反量化      :", [round(v, 4) for v in x_hat_a.tolist()])
    print("  最大误差    : %.6f" % (x - x_hat_a).abs().max().item())

    # ---- per-tensor vs per-channel 对比(制造一个异常值通道)----
    W = torch.tensor([[0.1, -0.2, 0.15],
                      [0.05, 0.1, -0.08],
                      [10.0, -9.5, 8.0]])   # 第3行是异常大的通道
    # per-tensor
    qt, st = quantize_symmetric(W)
    err_t = (W - dequantize_symmetric(qt, st)).abs().max()
    # per-channel(按行)
    scales = W.abs().amax(dim=1, keepdim=True) / 127
    qc = torch.round(W / scales).clamp(-127, 127)
    err_c = (W - qc * scales).abs().max()
    print("\n[per-tensor]  最大误差 = %.4f" % err_t.item())
    print("[per-channel] 最大误差 = %.4f  (前两行小值不再被大值连累)" % err_c.item())
参考输出(数值可能因环境略有不同):
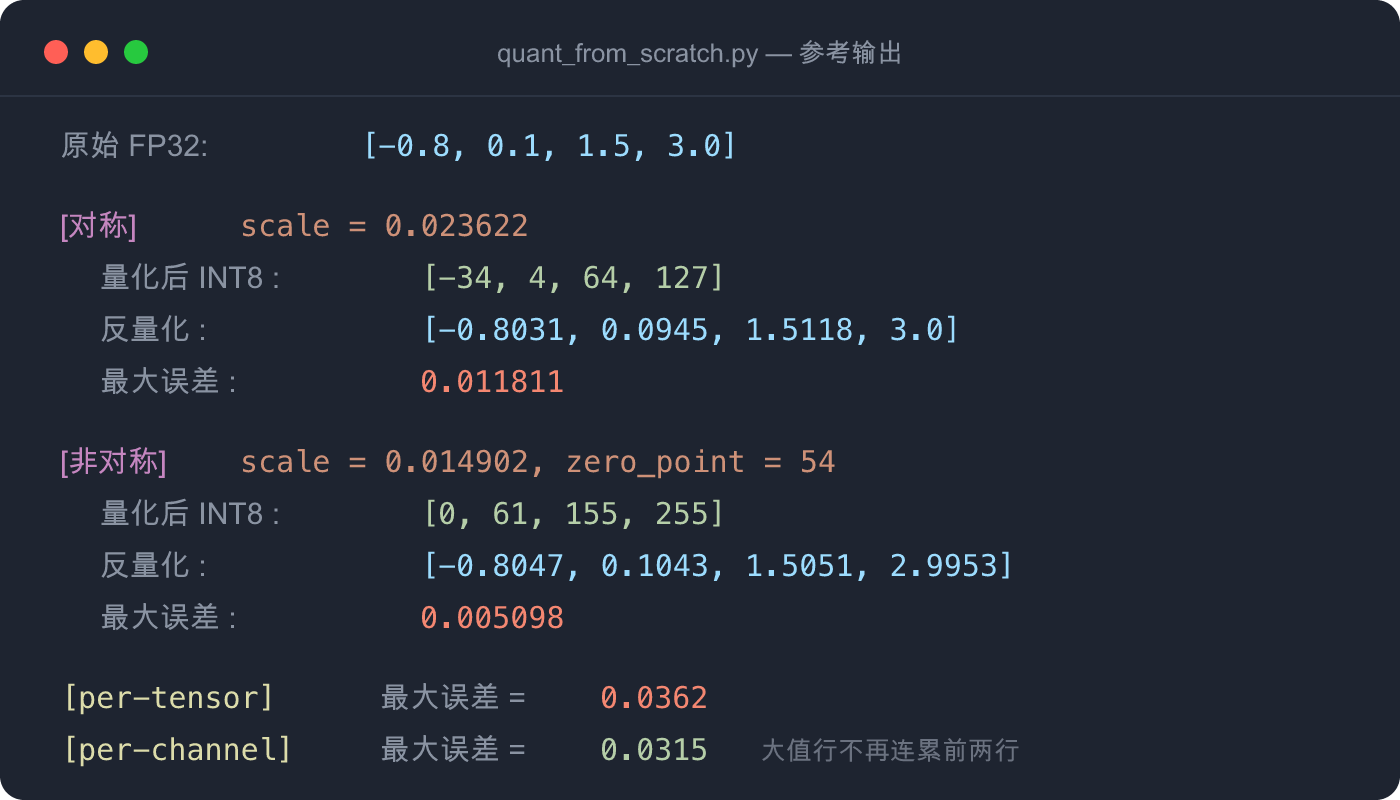
两点直觉:① 同样 INT8,非对称这组数据误差更小(
0.0051 < 0.0118),因为它充分利用了[0,255]全程;② per-channel 的价值在异常值隔离——第 3 行的大值只撑大自己那行的 scale,不再连累前两行小值,所以整体最大误差也更低(0.0315 < 0.0362)。
3. 通用量化范式
地基打好,现在上「怎么把量化用到真实模型里」。两条主线:不重训(PTQ) vs 重训(QAT);以及激活的 scale 在线算(动态) vs 离线算(静态)。
3.1 PTQ:后训练量化
1. 定义与语义
一句话:训练完的模型直接拿来量化,不动梯度。用一小批「校准集」跑几次前向,统计出激活的数值范围,定好 scale,就能把权重和激活都转成 INT8。
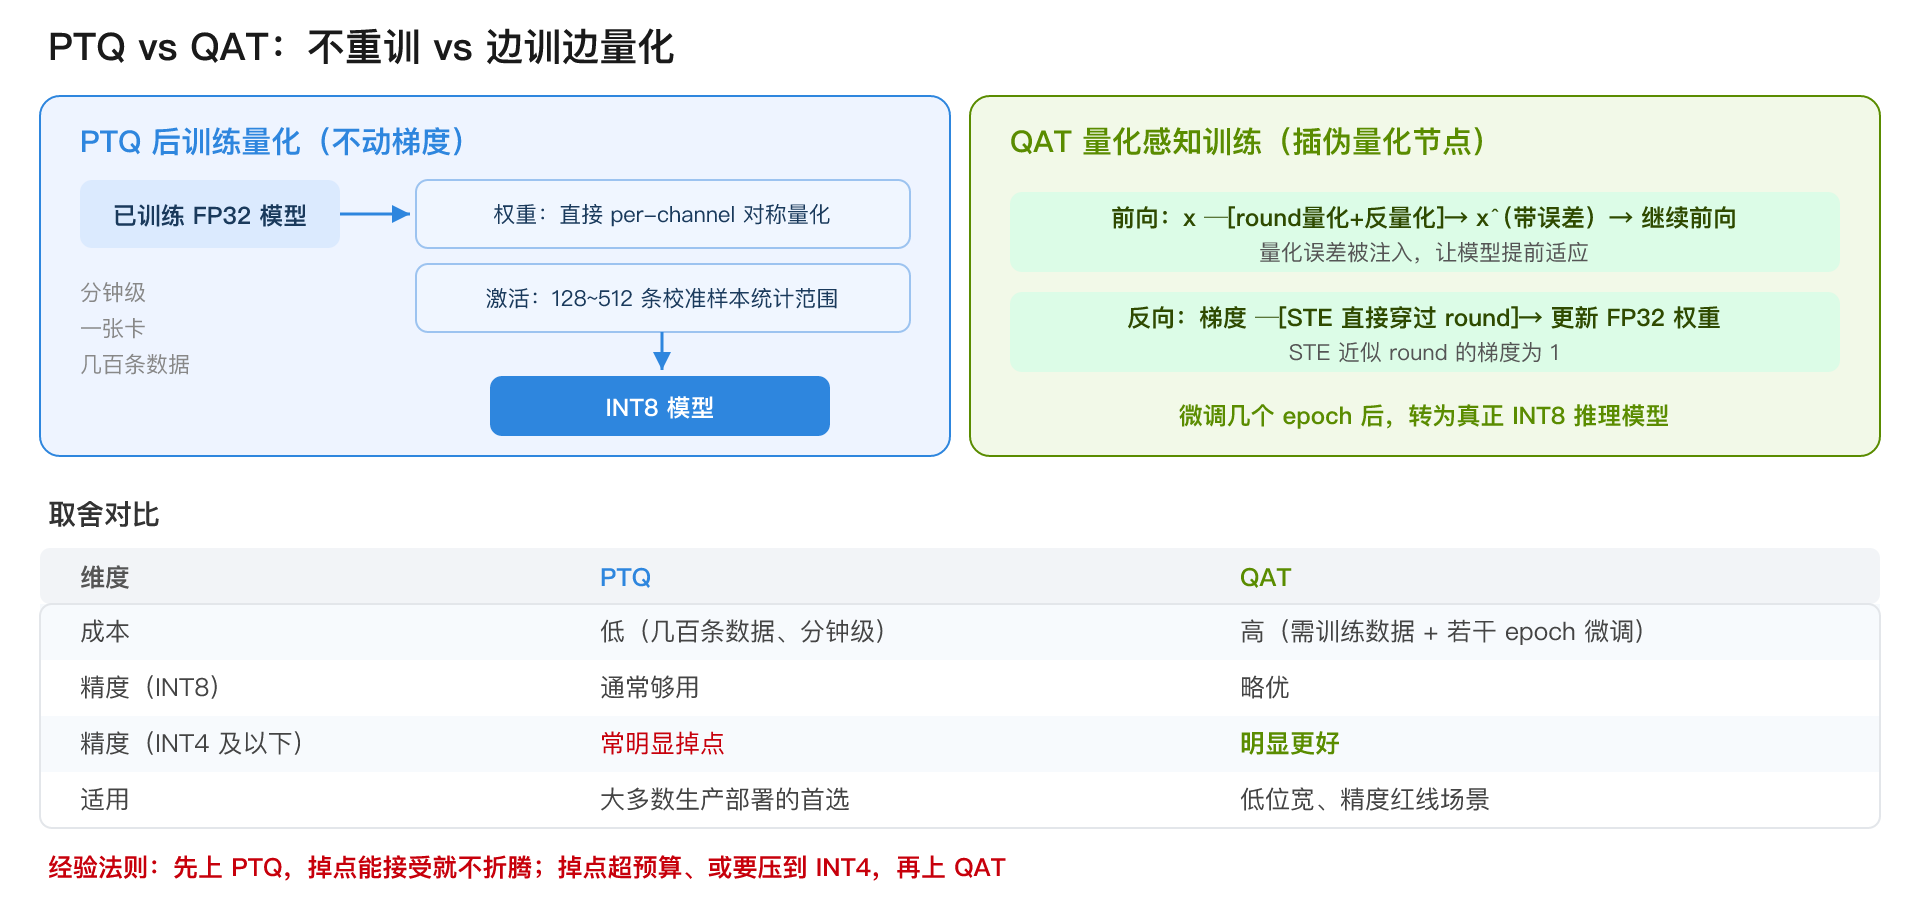
权重是已知常量,直接按 per-channel 对称量化、无需数据;激活则拿 128~512 条校准样本跑前向,统计每层范围后定 scale,最终得到权重+激活都量化的 INT8 模型。
2. 原理与适用
PTQ 便宜(几分钟到几十分钟,一张卡、几百条数据),对 CNN 和大部分 8-bit 场景精度损失很小(通常 <1%)。但位宽压到 INT4 或遇到激活异常值严重的 LLM 时,PTQ 掉点明显——这时要么上 QAT,要么用下篇的 LLM 专用算法。
3. 实例代码:PyTorch 静态 PTQ
# file: ptq_static.py
# 运行: python ptq_static.py
# 依赖: pip install torch
import torch, torch.nn as nn
from torch.ao.quantization import get_default_qconfig, QConfigMapping
from torch.ao.quantization.quantize_fx import prepare_fx, convert_fx

class TinyNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(64, 128)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(128, 10)
    def forward(self, x):
        return self.fc2(self.relu(self.fc1(x)))

torch.manual_seed(0)
model = TinyNet().eval()

# 1) 配置量化方案(x86 后端,INT8)
qconfig = get_default_qconfig("x86")
qmap = QConfigMapping().set_global(qconfig)

# 2) 插入观测器(observer),准备收集激活范围
example_inputs = (torch.randn(1, 64),)
prepared = prepare_fx(model, qmap, example_inputs)

# 3) 校准:拿一批无标签数据跑前向,让 observer 统计 min/max
with torch.no_grad():
    for _ in range(32):                       # 32 个 batch 作为校准集
        prepared(torch.randn(16, 64))

# 4) 转换为真正的 INT8 模型
quantized = convert_fx(prepared)

# 5) 对比:输出误差 + 体积
x = torch.randn(4, 64)
with torch.no_grad():
    y_fp32 = model(x)
    y_int8 = quantized(x)
print("输出最大绝对误差:", (y_fp32 - y_int8).abs().max().item())

def size_mb(m):
    import io
    buf = io.BytesIO(); torch.save(m.state_dict(), buf)
    return buf.getbuffer().nbytes / 1e6
print("FP32 体积 (MB):", round(size_mb(model), 4))
print("INT8 体积 (MB):", round(size_mb(quantized), 4))
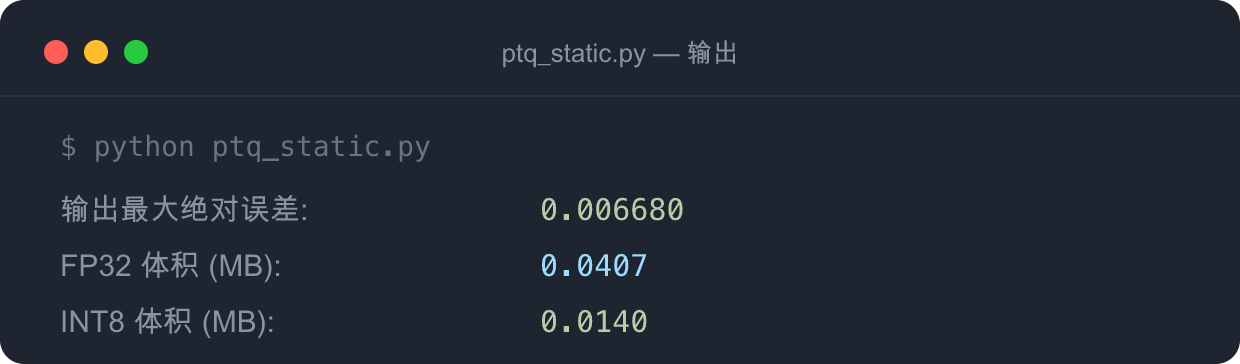
输出误差在 1e-2 量级(上例约 0.0067),精度几乎无损。体积这里从 0.0407 MB 降到 0.014 MB、约 1/3——注意这是个极小模型,偏置与每层量化参数(scale/zero_point)的固定开销摊薄了压缩比;权重本身仍是 FP32→INT8 的 4 倍压缩,模型越大越接近 1/4。
3.2 QAT:量化感知训练
1. 定义与语义
一句话:训练时就在网络里插入「伪量化」节点,让模型提前适应量化误差,再微调几个 epoch。
伪量化节点做 x → quant → dequant → x_hat,前向把量化误差注入,反向用 STE(Straight-Through Estimator) 让梯度直接穿过 round(因为 round 的导数几乎处处为 0,STE 近似其梯度为 1)。流程见上图右侧。
2. PTQ vs QAT 取舍
| 维度 | PTQ | QAT |
|---|---|---|
| 成本 | 低(几百条数据、分钟级) | 高(需训练数据+若干 epoch 微调) |
| 精度(INT8) | 通常够用 | 略优 |
| 精度(INT4 及以下) | 常明显掉点 | 明显更好 |
| 适用 | 大多数生产部署的首选 | 低位宽、精度红线场景 |
经验法则:先上 PTQ,掉点能接受就不折腾;掉点超预算、或要压到 INT4,再上 QAT。
3. 实例代码:QAT 骨架
# file: qat_demo.py
# 运行: python qat_demo.py
# 依赖: pip install torch
import torch, torch.nn as nn
from torch.ao.quantization import get_default_qat_qconfig, QConfigMapping
from torch.ao.quantization.quantize_fx import prepare_qat_fx, convert_fx

class TinyNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(64, 128); self.relu = nn.ReLU(); self.fc2 = nn.Linear(128, 10)
    def forward(self, x): return self.fc2(self.relu(self.fc1(x)))

torch.manual_seed(0)
model = TinyNet().train()
qconfig = get_default_qat_qconfig("x86")
qmap = QConfigMapping().set_global(qconfig)

# 插入伪量化节点(fake-quant),模型仍是 FP32,但前向带量化误差
prepared = prepare_qat_fx(model, qmap, (torch.randn(1, 64),))

opt = torch.optim.SGD(prepared.parameters(), lr=0.01)
loss_fn = nn.CrossEntropyLoss()
for step in range(50):                        # 用真实任务数据微调;此处用随机数演示流程
    x = torch.randn(16, 64); y = torch.randint(0, 10, (16,))
    opt.zero_grad()
    loss = loss_fn(prepared(x), y)
    loss.backward(); opt.step()               # STE 让梯度穿过 round,正常更新
print("QAT 微调后 loss:", round(loss.item(), 4))

prepared.eval()
quantized = convert_fx(prepared)              # 转为真正 INT8 推理模型
print("转换为 INT8 模型完成:", type(quantized).__name__)
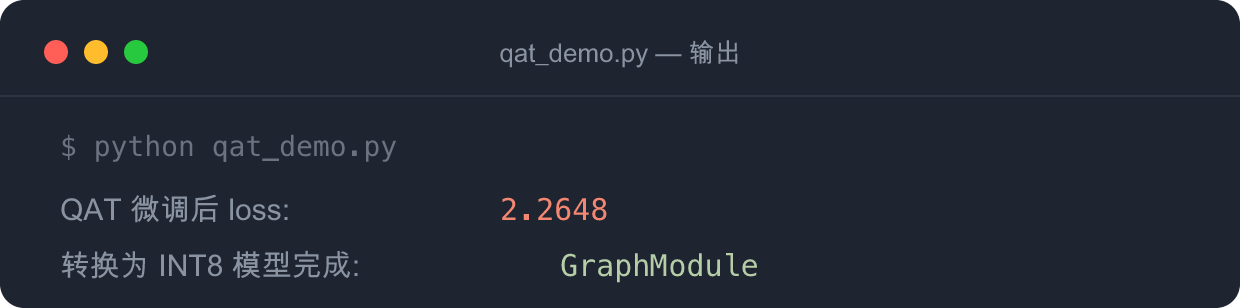
convert_fx 后得到真正的 INT8 推理模型(GraphModule);此处用随机数据演示流程,loss 数值本身无意义,关键是跑通「插伪量化节点 → STE 微调 → 转 INT8」这条链路。
3.3 动态量化 vs 静态量化
二者都属 PTQ,区别在激活的 scale 什么时候算(权重都是离线量化好的)。
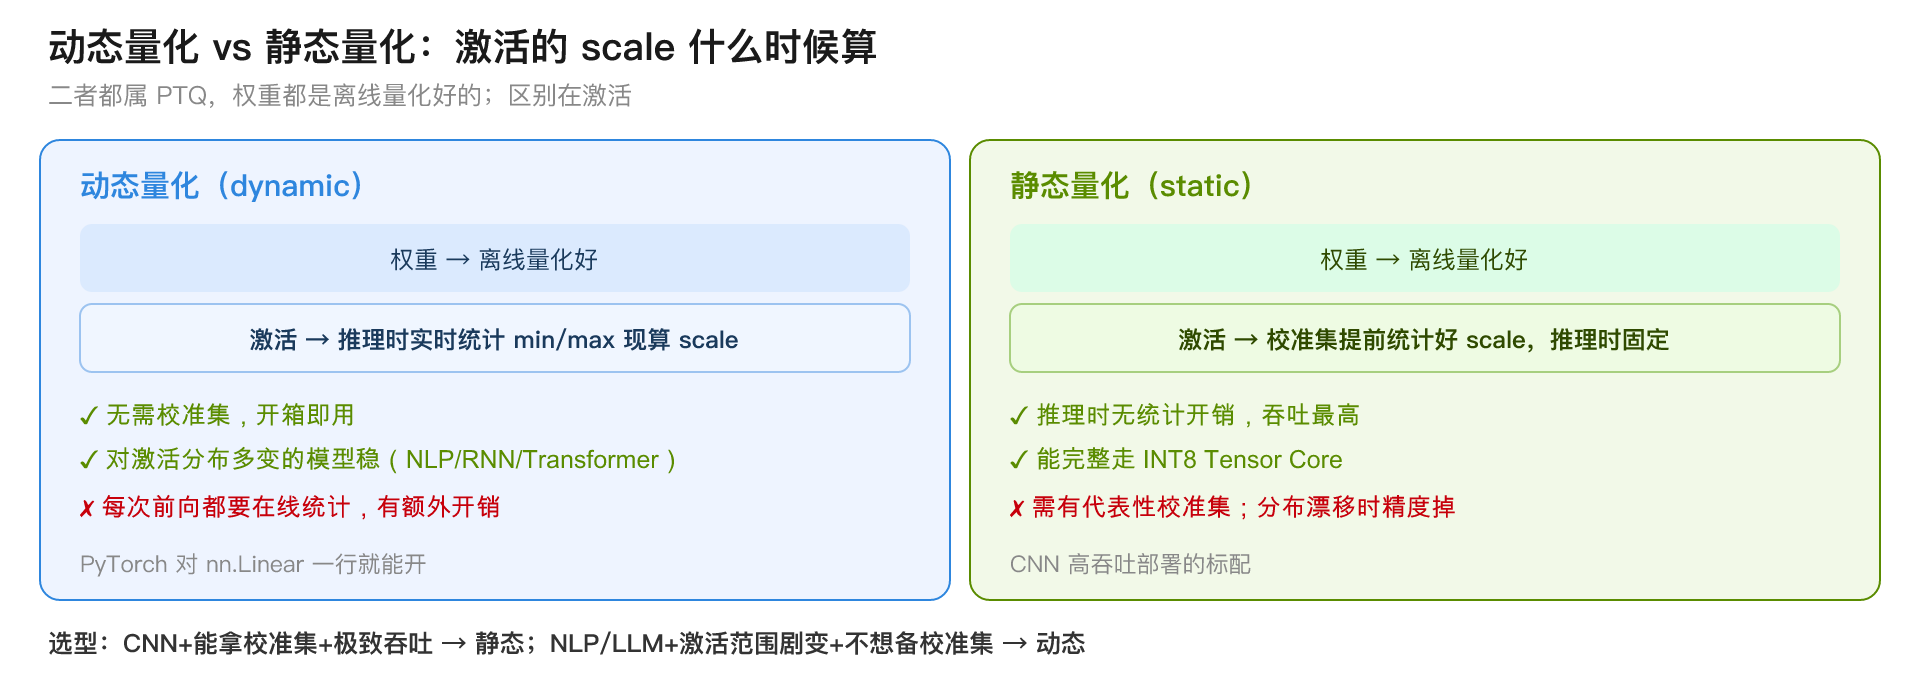
选型:CNN、能拿到校准集、追求极致吞吐 → 静态;NLP/LLM、激活范围随输入剧烈变化、不想准备校准集 → 动态(PyTorch 对 nn.Linear 的动态量化一行就能开)。
1. 实例代码:动态量化一行开启
# file: dynamic_quant.py
# 运行: python dynamic_quant.py
# 依赖: pip install torch
import torch, torch.nn as nn

class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(512, 512); self.act = nn.ReLU(); self.fc2 = nn.Linear(512, 512)
    def forward(self, x): return self.fc2(self.act(self.fc1(x)))

torch.manual_seed(0)
model = MLP().eval()

# 一行开启动态量化:只量化 Linear 的权重为 INT8,激活推理时动态量化
qmodel = torch.ao.quantization.quantize_dynamic(
    model, {nn.Linear}, dtype=torch.qint8
)

x = torch.randn(8, 512)
with torch.no_grad():
    print("输出最大误差:", (model(x) - qmodel(x)).abs().max().item())

def size_mb(m):
    import io; buf = io.BytesIO(); torch.save(m.state_dict(), buf)
    return buf.getbuffer().nbytes / 1e6
print("FP32 (MB):", round(size_mb(model), 3))
print("INT8 (MB):", round(size_mb(qmodel), 3))   # 约 1/4
参考输出(已固定 torch.manual_seed(0)):
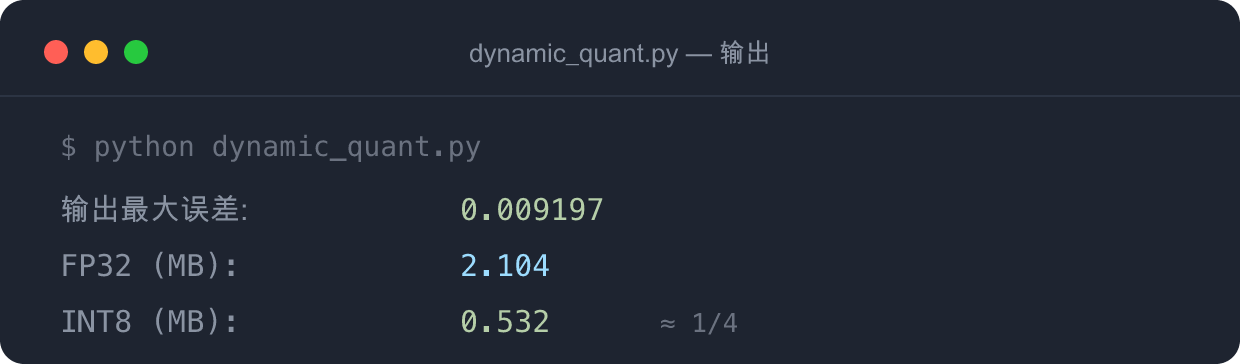
两点可验证:① 误差在 1e-2 量级——动态量化只把权重压成 INT8,激活推理时才临时量化,精度损失很小;② 体积从 2.104 MB 降到 0.532 MB,正好约 1/4(两层 512×512 权重 FP32→INT8,每权重 4 字节变 1 字节,偏置仍保留 FP32)。
3.4 校准方法:怎么挑 scale
静态量化的灵魂在校准(Calibration)——用校准集统计出激活的「代表性范围」,据此定 scale。常见四种策略:
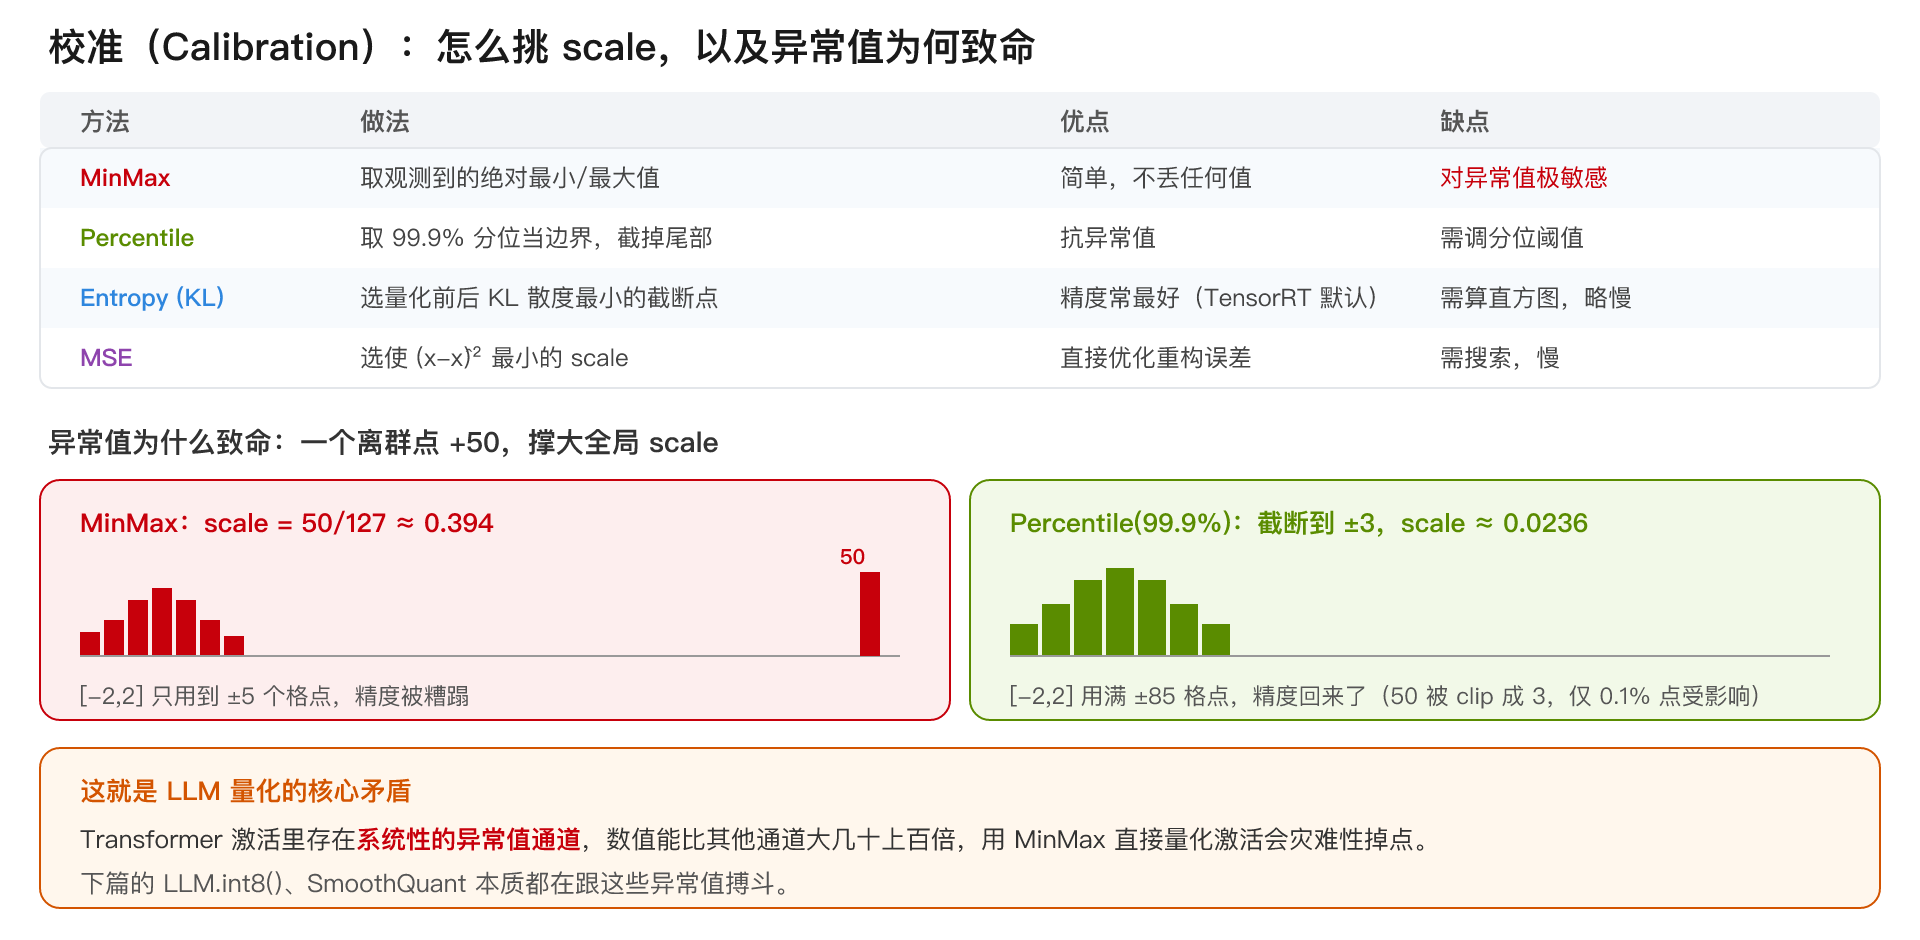
| 方法 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| MinMax | 取观测到的绝对最小/最大值 | 简单,不丢任何值 | 对异常值极其敏感,一个离群点撑大 scale |
| Percentile | 取 99.9% 分位数当边界,截掉尾部 | 抗异常值 | 需调分位阈值 |
| Entropy (KL) | 选使量化前后分布 KL 散度最小的截断点 | 精度常最好(TensorRT 默认) | 计算直方图,略慢 |
| MSE | 选使 (x - x_hat)² 最小的 scale | 直接优化重构误差 | 需搜索,慢 |
1. 异常值为什么致命
如上图下半部分所示:当一组激活大部分挤在 [-2, 2]、却混入一个离群点 +50 时,MinMax 的 scale 被撑到 50/127 ≈ 0.394,[-2, 2] 只用到 ±5 个整数格点,精度被糟蹋;而 Percentile(99.9%) 截断到 ±3、scale 降到 ≈0.0236,[-2, 2] 用满 ±85 格点,精度回来了,代价仅是 50 被 clip 成 3(只有 0.1% 的点受影响)。
这就是 LLM 量化的核心矛盾:Transformer 激活里存在系统性的异常值通道(outlier channels),数值能比其他通道大几十上百倍,用 MinMax 直接量化激活会灾难性掉点。下篇的 LLM.int8()、SmoothQuant 本质都在跟这些异常值搏斗。
2. 实例代码:三种校准策略对比
# file: calibration_compare.py
# 运行: python calibration_compare.py
# 依赖: pip install torch numpy
import torch, numpy as np

def quant_dequant_symmetric(x, scale, qmax=127):
    q = torch.round(x / scale).clamp(-qmax, qmax)
    return q * scale

def scale_minmax(x, qmax=127):
    return x.abs().max() / qmax

def scale_percentile(x, pct=99.9, qmax=127):
    thr = torch.quantile(x.abs(), pct / 100.0)
    return thr / qmax

def scale_mse(x, qmax=127, steps=100):
    amax = x.abs().max().item()
    best_s, best_err = None, float("inf")
    for r in np.linspace(0.3, 1.0, steps):      # 在 [0.3,1.0]*amax 之间搜最优截断
        s = amax * r / qmax
        err = ((x - quant_dequant_symmetric(x, torch.tensor(s))) ** 2).mean().item()
        if err < best_err: best_err, best_s = err, s
    return torch.tensor(best_s)

torch.manual_seed(0)
# 构造:主体 N(0,1),混入少量异常值
x = torch.randn(10000)
x[:10] = torch.tensor([40., -38., 42., 45., -41., 39., 44., -40., 43., 41.])  # 10 个离群点

for name, s in [("MinMax", scale_minmax(x)),
                ("Percentile99.9", scale_percentile(x)),
                ("MSE", scale_mse(x))]:
    xq = quant_dequant_symmetric(x, s)
    # 只看主体(非异常值)的重构误差,这才是真正关心的精度
    body = x[10:]
    body_err = (body - quant_dequant_symmetric(body, s)).abs().mean().item()
    print(f"{name:16s} scale={s.item():.5f}  主体平均误差={body_err:.5f}")
参考输出(已固定 torch.manual_seed(0)):
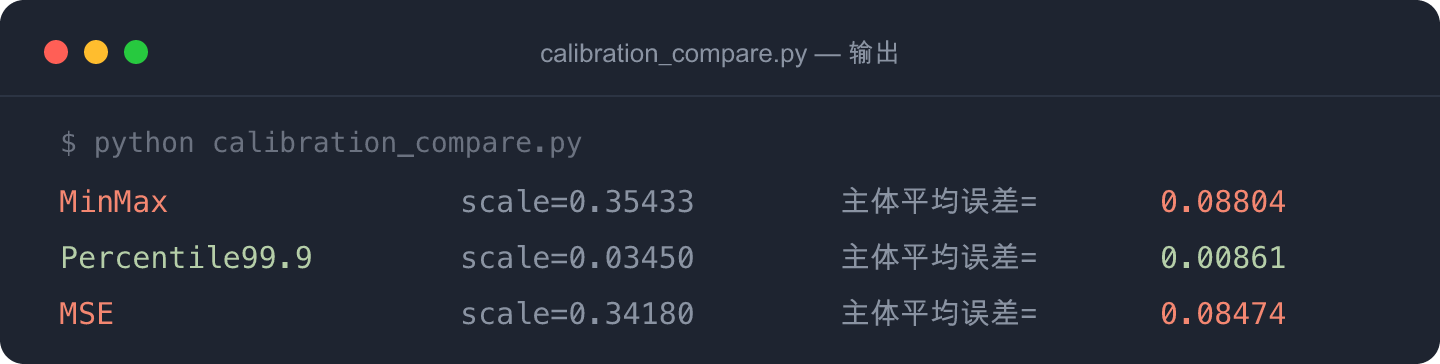
读这组数要小心一个反直觉点:只有 Percentile 真正救回了精度(主体误差 0.00861,比 MinMax 的 0.08804 低约 10 倍);而 MinMax 和 MSE 都被 ±40 的离群点带偏了——MSE 在含异常值的全量数据上最小化平方误差,离群点的巨大平方项迫使它保留大 scale(0.342,几乎等于 MinMax),结果主体精度和 MinMax 一样差。
这恰恰说明:朴素的「全量 MSE」对极端异常值并不鲁棒,这也是实践中激活量化偏爱 Percentile / Entropy(KL) 截断的原因——先把尾部离群点挡在外面,再优化主体。
上篇小结与下篇预告
上篇我们把量化的地基和通用范式讲透了:
- 地基三件套:① 仿射映射
q=round(x/scale)+zp是均匀量化的数学内核(下篇 NF4 为非均匀量化);② 对称(zp=0,适合权重)vs 非对称(zp≠0,适合单边激活);③ per-tensor(省)vs per-channel(准,权重标配),核心价值是隔离异常值通道。 - 加速三来源:显存/带宽减半、整数 Tensor Core 吞吐翻倍、缓存命中提升——其中大模型 decode 阶段瓶颈在带宽,所以 weight-only 量化即使不省算力也能提速。
- 两条范式主线:PTQ(不重训、便宜,首选)vs QAT(插伪量化节点+STE 微调,低位宽保精度);动态(激活在线算 scale)vs 静态(离线校准,吞吐最高)。
- 校准是灵魂:MinMax 对异常值极度敏感;Percentile / Entropy(KL) 通过截断尾部离群点救回主体精度,而朴素的「全量 MSE」会被极端离群点带偏——异常值问题正是 LLM 量化的命门。
下篇将进入大模型专用方案,专治 LLM 的激活异常值与超大权重:LLM.int8()(异常值分离+混合精度分解)、GPTQ(基于 Hessian 二阶信息的逐层权重量化)、AWQ(激活感知、保护显著权重通道)、SmoothQuant(把激活的量化难度数学等价地「平滑」给权重,让 W8A8 可行)、NF4+双重量化(QLoRA 的 4-bit NormalFloat,为什么比 INT4 更适配正态分布权重)。每个方法配
transformers+bitsandbytes/auto-gptq/autoawq的可运行代码,并给出显存占用的量化估算。
附录:参考资料
本篇涉及的概念、公式与工程实践,主要参考以下资料。想深入某个点,顺着对应条目读下去即可。
- Jacob et al., Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference, CVPR 2018 — 仿射映射
q=round(x/scale)+zp与整数推理、QAT 的奠基之作(arXiv:1712.05877)。 - Krishnamoorthi, Quantizing Deep Convolutional Networks for Efficient Inference: A Whitepaper, 2018 — per-tensor/per-channel、对称/非对称、PTQ/QAT 的系统梳理(arXiv:1806.08342)。
- Bengio et al., Estimating or Propagating Gradients Through Stochastic Neurons, 2013 — STE(直通估计器)的来源,QAT 反向穿过
round的理论依据(arXiv:1308.3432)。 - Nagel et al., A White Paper on Neural Network Quantization, Qualcomm 2021 — 校准、异常值、PTQ/QAT 实践的权威综述(arXiv:2106.08295)。
- Gholami et al., A Survey of Quantization Methods for Efficient Neural Network Inference, 2021 — 量化方法全景综述(arXiv:2103.13630)。
- Migacz, 8-bit Inference with TensorRT, NVIDIA GTC 2017 — Entropy(KL) 校准的经典实现思路。
- PyTorch Quantization 文档 — 本篇 PTQ / QAT / 动态量化代码所用
torch.ao.quantizationAPI:https://pytorch.org/docs/stable/quantization.html。 - PyTorch FX Graph Mode Quantization —
prepare_fx/convert_fx/prepare_qat_fx的用法与后端(x86/qnnpack)说明。