写在前面
上篇我们把地基打好了:仿射映射、对称/非对称、per-channel、PTQ/QAT、校准。结尾留下一个悬念——异常值(outlier)是 LLM 量化的命门。下篇就从这里切入。
术语沿用上篇:
W指权重、A指激活;W8A8表示权重和激活都量化到 8-bit,W4A16表示权重 4-bit、激活保持 16-bit;scale(缩放因子)、zero_point(零点)、per-tensor / per-channel / per-token(量化粒度)均见上篇定义。
三句话抓住下篇:
- LLM 量化只跟两件事搏斗:激活里的「异常值通道」和「4-bit 权重的精度损失」——5 个方案都是对这两件事的不同打法。
- 先分两条路:只压权重、激活留 FP16 的 weight-only(GPTQ / AWQ / NF4,为省显存);权重激活都压的 W8A8(LLM.int8() / SmoothQuant,为吃满 INT8 吞吐)。
- 处理异常值有两招:LLM.int8() 把异常列拎出来单独用 FP16 算;SmoothQuant 用等价变换把难度迁给权重,让激活重新变得好量化。
为什么 LLM 的 W8A8 比 CNN 难?
CNN 时代,INT8 静态量化(W8A8)几乎是免费午餐,掉点 <1%。但同样的套路搬到 LLM(尤其 6.7B 以上)上,激活一量化就崩。原因是:
Transformer 的激活里存在系统性的「异常值特征维度」(outlier feature dimensions):在某些固定的 channel 上,激活值能比其他 channel 大 几十到上百倍,且随模型规模增大愈发显著。
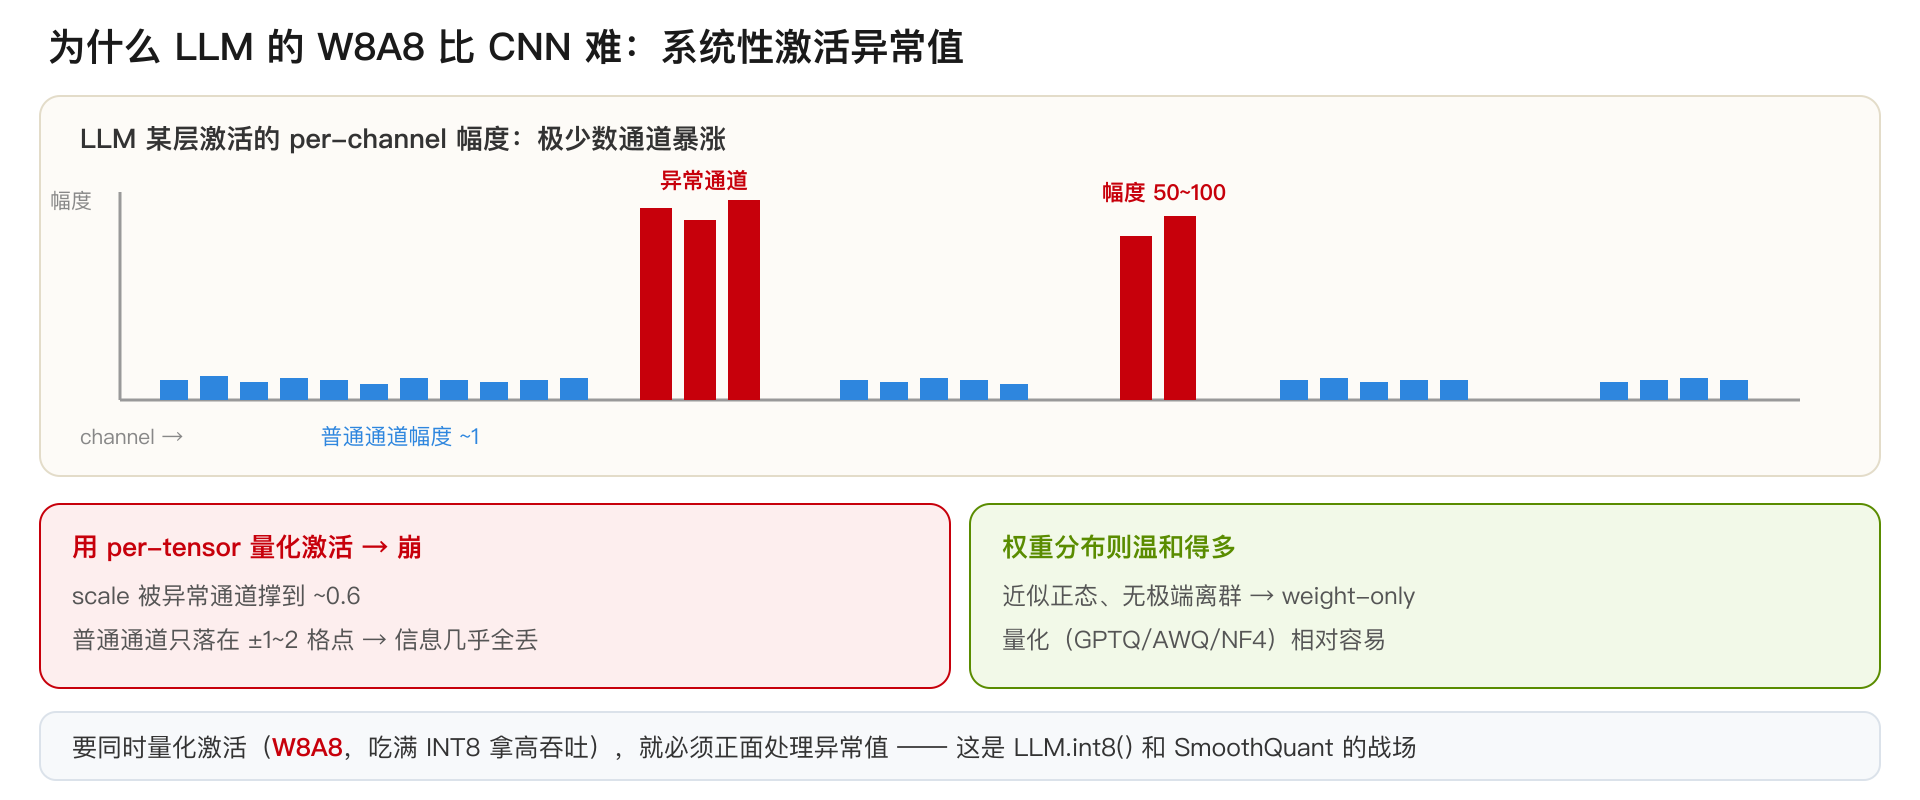
用 per-tensor 量化激活时,scale 会被异常通道撑到约 0.6,普通通道(幅度约 1)量化后只落在 1 到 2 个整数格点上,信息几乎全丢,模型就崩了。
权重分布则温和得多(近似正态、无极端离群),所以 weight-only 量化(只压权重、激活留 FP16)相对容易——GPTQ、AWQ、NF4 走的都是这条路。而要同时量化激活(W8A8,吃满 INT8 Tensor Core 拿高吞吐),就必须正面处理异常值——这是 LLM.int8() 和 SmoothQuant 的战场。
4-bit 权重量化对显存的决定性影响
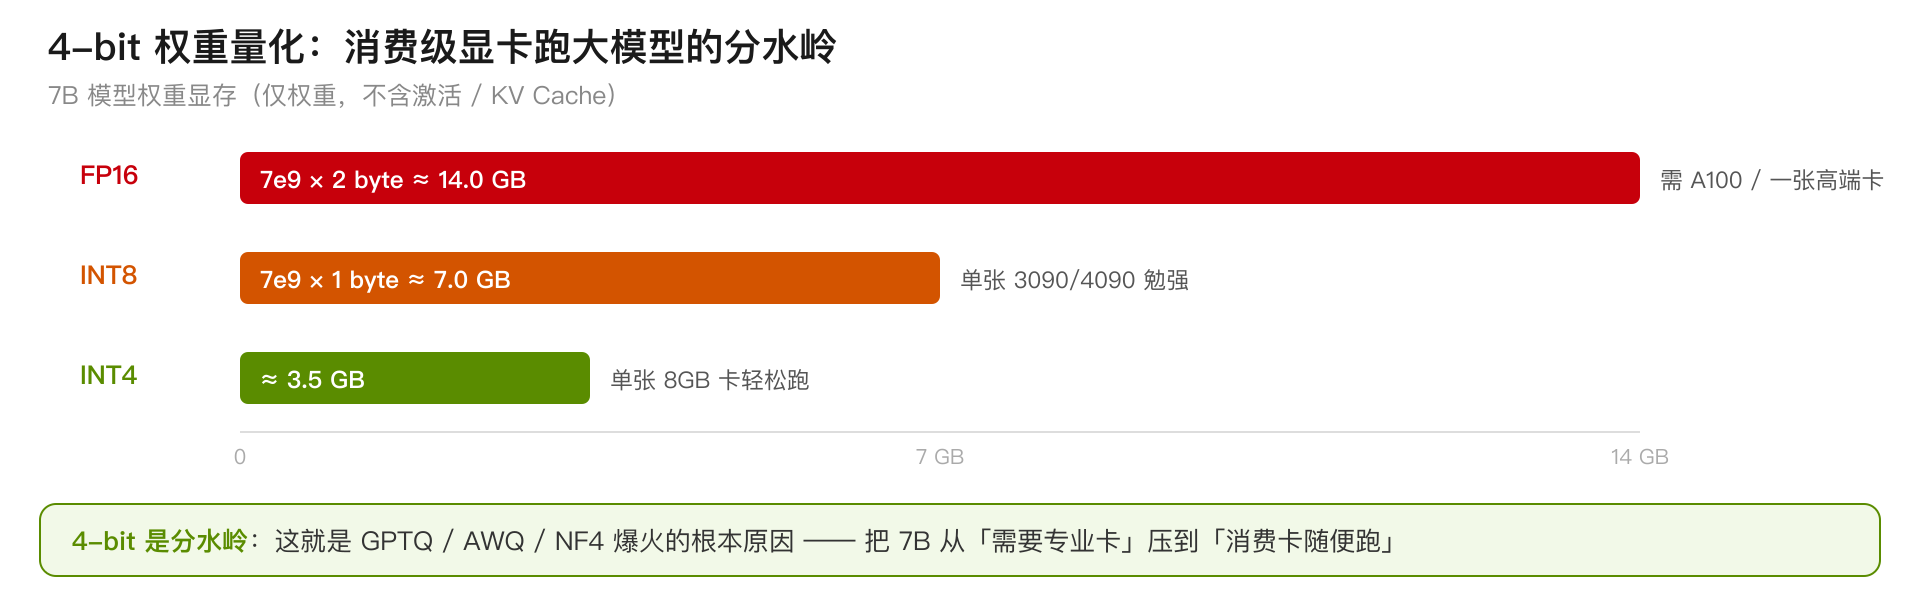
7B 模型仅权重的显存:FP16 ≈ 14 GB(需 A100/高端卡)、INT8 ≈ 7 GB(单张 3090/4090 勉强)、INT4 ≈ 3.5 GB(单张 8GB 卡轻松跑)。4-bit 是「消费级显卡跑大模型」的分水岭,这就是 GPTQ/AWQ/NF4 爆火的根本原因。
本篇全局定位(续上篇对比表):
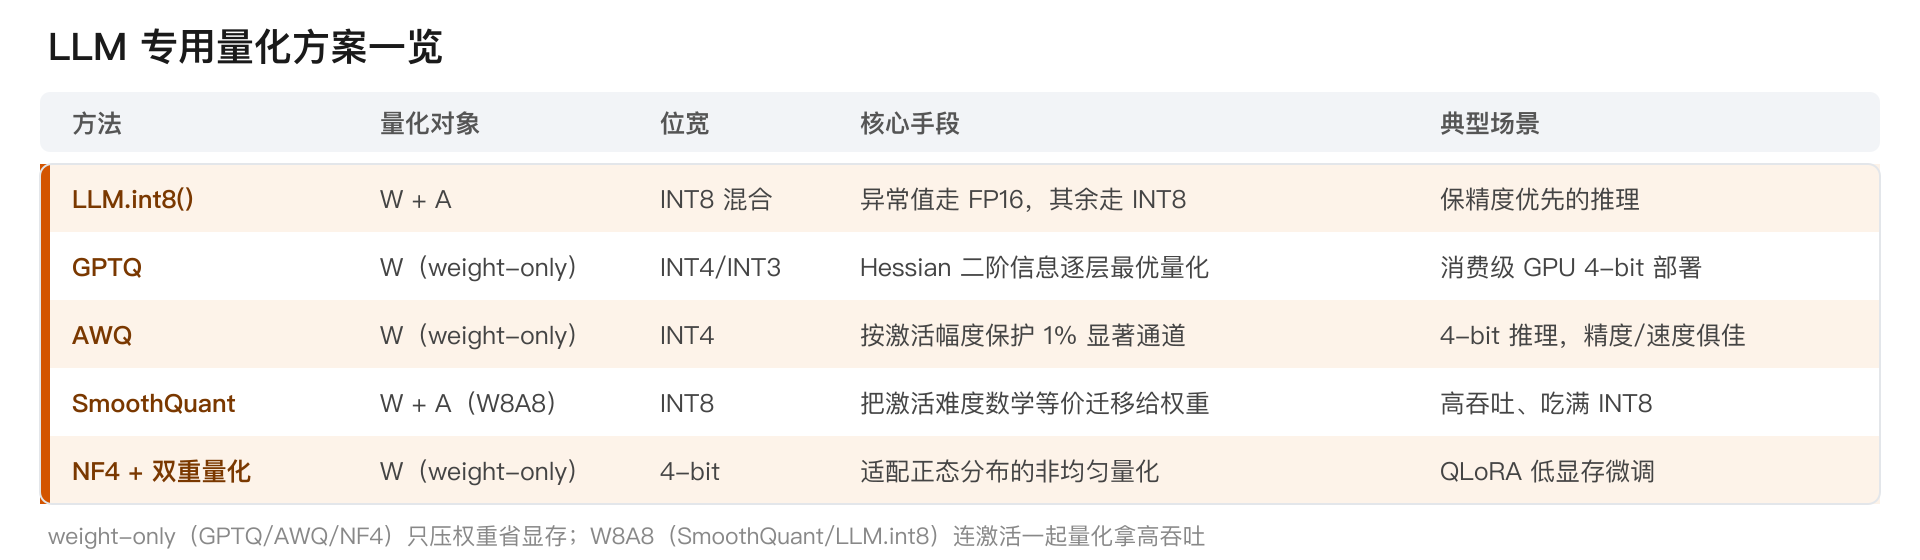
| 方法 | 量化对象 | 位宽 | 核心手段 | 典型场景 |
|---|---|---|---|---|
| LLM.int8() | W+A | INT8(混合) | 异常值走 FP16,其余走 INT8 | 保精度优先的推理 |
| GPTQ | W(weight-only) | INT4/INT3 | Hessian 二阶信息逐层最优量化 | 消费级 GPU 4-bit 部署 |
| AWQ | W(weight-only) | INT4 | 按激活幅度保护 1% 显著通道 | 4-bit 推理,精度/速度俱佳 |
| SmoothQuant | W+A(W8A8) | INT8 | 把激活难度数学等价迁移给权重 | 高吞吐、吃满 INT8 |
| NF4+双重量化 | W(weight-only) | 4-bit | 适配正态分布的非均匀量化 | QLoRA 低显存微调 |
1. LLM.int8():异常值分离 + 混合精度分解
1.1 定义与语义
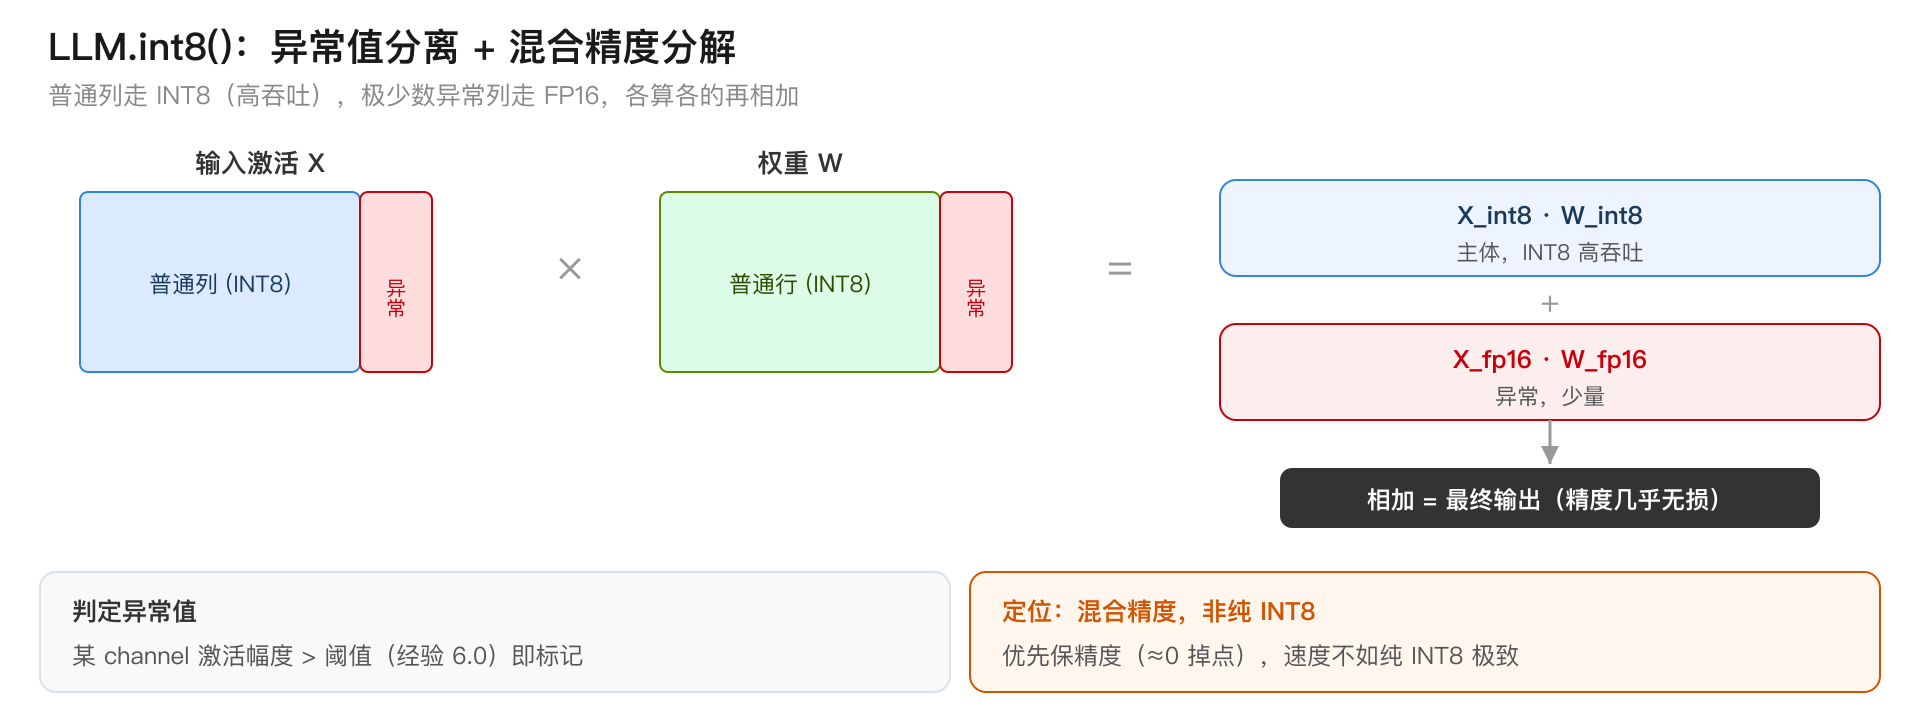
一句话:把矩阵乘拆成两部分——绝大多数「普通」列走 INT8,极少数「异常值」列保留 FP16,各算各的再相加。
既然异常值只集中在极少数 channel(通常 <0.1% 的维度),那就别让它们污染全局 scale——把它们单独拎出来用 FP16 算,剩下的老实走 INT8。
1.2 底层原理
- 判定异常值:某 channel 的激活幅度超过阈值(经验值 6.0)即标记为 outlier 维度。
- 主体部分用 向量级(per-vector) INT8 量化,异常列用 FP16 原样算。
- 由于异常维度极少(几十个 / 几千维),FP16 那部分开销很小,总体仍以 INT8 为主。
一个具体数字感受「分离」的价值:设某层激活 [hidden=4096],普通通道幅度约 ±1,但第 2048 维混进一个异常值 70。
- 不分离:per-tensor 量化全层,
scale = 70/127 ≈ 0.551,普通通道的±1只落在±1~2个格点上,信息几乎全丢 → 模型崩。 - 分离后:把第 2048 维拎出来走 FP16(原样精确),剩下 4095 维的幅度回到
±1,scale = 1/127 ≈ 0.0079,普通通道重新用满±127格点 → 精度几乎无损。代价仅是1/4096 ≈ 0.02%的维度多走一条 FP16 分支。
这就是「用 0.1% 的 FP16 换回 99.9% 的 INT8 精度」。
1.3 演进关系
定位:W+A 都「量化」,但本质是混合精度,不是纯 INT8。它优先保精度(几乎 0 掉点),速度收益不如纯 INT8 极致——异常值分支的 FP16 计算和两路合并有额外开销。和下文 SmoothQuant 对比:LLM.int8() 是「绕开」异常值(分离出来另算),SmoothQuant 是「化解」异常值(等价变换压平),这是两条根本不同的技术路线。
1.4 应用场景
精度红线高、对速度不极端苛刻的推理部署。transformers 里 load_in_8bit=True 开箱即用,是「我就想省一半显存且几乎不掉点」的最省心选择。
1.5 实例代码
# file: llm_int8_demo.py
# 运行: python llm_int8_demo.py   (需要 GPU)
# 依赖: pip install torch transformers accelerate bitsandbytes
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

model_id = "facebook/opt-1.3b"   # 换成你本地有的小模型即可
tok = AutoTokenizer.from_pretrained(model_id)

# FP16 基线
m_fp16 = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.float16, device_map="cuda")
mem_fp16 = m_fp16.get_memory_footprint() / 1e9
del m_fp16; torch.cuda.empty_cache()

# LLM.int8():一个开关
bnb = BitsAndBytesConfig(load_in_8bit=True)
m_int8 = AutoModelForCausalLM.from_pretrained(model_id, quantization_config=bnb, device_map="cuda")
mem_int8 = m_int8.get_memory_footprint() / 1e9

print(f"FP16 显存: {mem_fp16:.2f} GB")
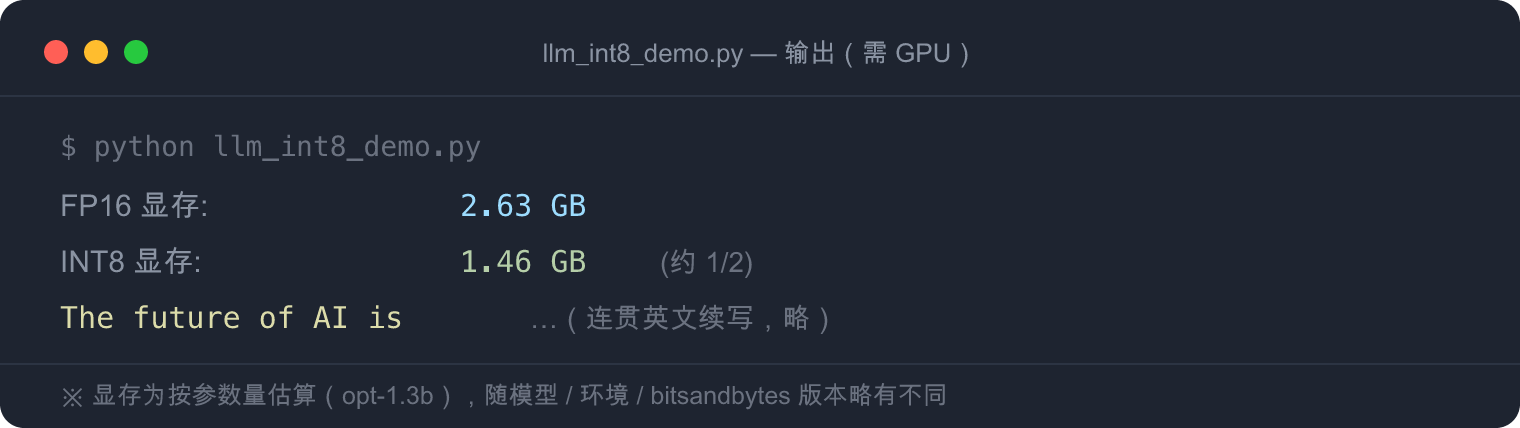
print(f"INT8 显存: {mem_int8:.2f} GB  (约 1/2)")

# 验证生成仍然正常
ids = tok("The future of AI is", return_tensors="pt").to("cuda")
out = m_int8.generate(**ids, max_new_tokens=20)
print(tok.decode(out[0], skip_special_tokens=True))
参考输出(显存为估算值,需 GPU 实跑):
2. GPTQ:基于 Hessian 的逐层权重量化
2.1 定义与语义
一句话:逐层地把权重量化到 INT4/INT3,每量化一个权重,就用二阶信息(Hessian)去补偿它给输出带来的误差,让整层输出尽量不变。
朴素量化是「每个权重独立 round 到最近格点」,误差会累积。GPTQ 聪明在:量化某个权重后,立刻微调同层剩下的未量化权重来抵消这次量化带来的输出偏差。
2.2 底层原理
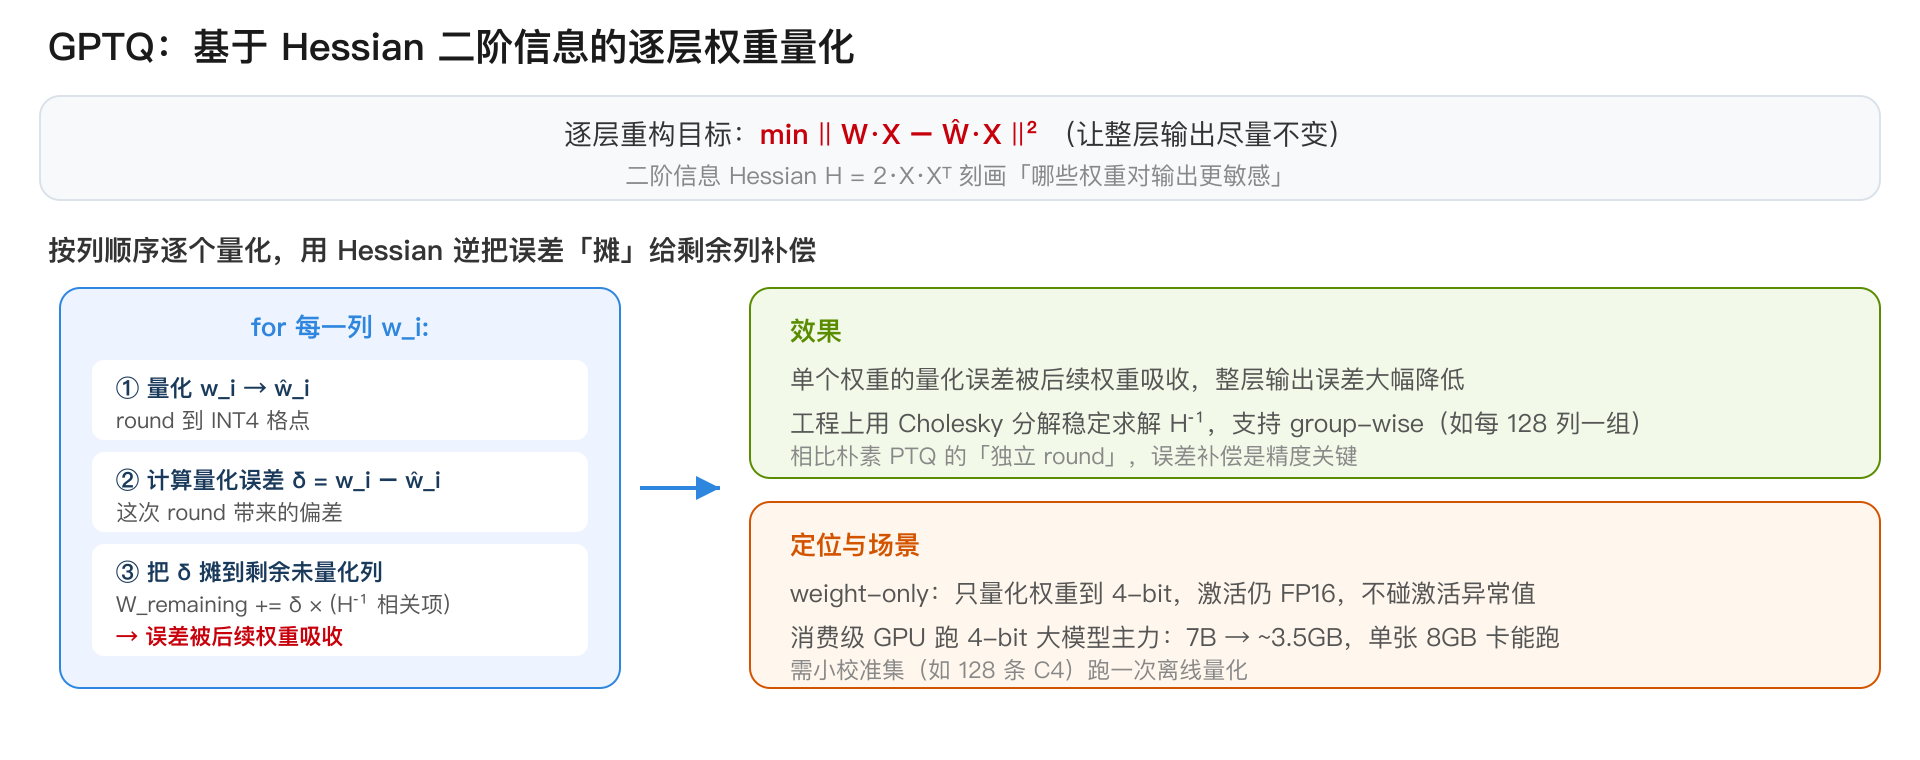
目标:对每一层,找量化权重 Ŵ,使整层输出误差最小——即在所有候选中取 argmin_Ŵ ‖WX − ŴX‖₂²(W 为原权重,X 为该层输入,‖·‖₂² 为误差的平方和)。
这是一个逐层重构问题。其二阶信息(Hessian)H = 2 X Xᵀ 刻画了「哪些权重对输出更敏感」。GPTQ 借鉴 OBQ(Optimal Brain Quantization)的思路:按列顺序逐个量化权重——量化 w_i → ŵ_i 后,算出量化误差 δ = w_i − ŵ_i,再用 Hessian 逆把 δ 摊到剩余未量化列上做补偿(W_remaining += δ × (H⁻¹ 相关项)),于是单个权重的量化误差被后续权重吸收,整层输出误差大幅降低(见上图)。
GPTQ 在工程上用 Cholesky 分解稳定求解 H⁻¹,并支持 group-wise(如每 128 列一组共享量化参数),精度/体积可调。
2.3 演进关系
GPTQ 属 weight-only:只量化权重到 4-bit,激活仍 FP16。因此它不碰激活异常值问题(那是 SmoothQuant 的活),专注把权重压到极限还几乎不掉点。相比朴素 PTQ 的「独立 round」,GPTQ 的误差补偿是精度关键。
2.4 应用场景
消费级 GPU 跑 4-bit 大模型的主力方案之一。7B 压到 ~3.5GB,单张 8GB 卡能跑。需要一个小校准集(如 128 条 C4 样本)跑一次离线量化,产出 INT4 权重。
2.5 实例代码
# file: gptq_demo.py
# 运行: python gptq_demo.py   (需要 GPU)
# 依赖: pip install torch transformers optimum auto-gptq
#   或直接加载社区已量化好的 GPTQ 模型(更快验证)
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, GPTQConfig

model_id = "facebook/opt-125m"
tok = AutoTokenizer.from_pretrained(model_id)

# 离线 4-bit GPTQ 量化:用 c4 作为校准集
gptq_cfg = GPTQConfig(bits=4, dataset="c4", group_size=128, tokenizer=tok)
model = AutoModelForCausalLM.from_pretrained(
    model_id, quantization_config=gptq_cfg, device_map="cuda"
)
print("GPTQ 4-bit 显存:", round(model.get_memory_footprint() / 1e9, 3), "GB")

ids = tok("Quantization makes LLMs", return_tensors="pt").to("cuda")
out = model.generate(**ids, max_new_tokens=20)
print(tok.decode(out[0], skip_special_tokens=True))

# 也可保存后复用:
# model.save_pretrained("opt-125m-gptq"); tok.save_pretrained("opt-125m-gptq")
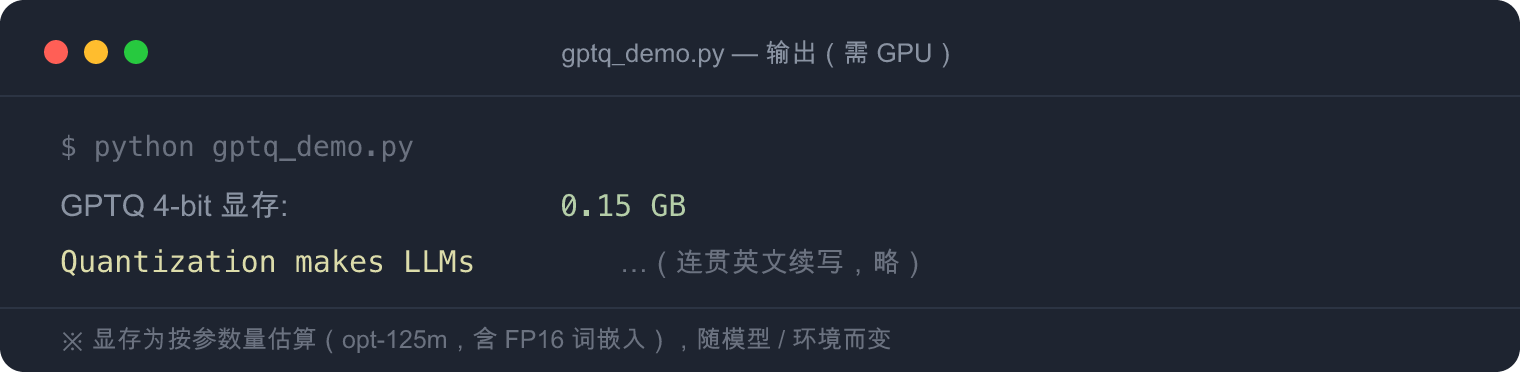
参考输出(显存为估算值,需 GPU 实跑):
若没有 GPU 或嫌量化慢,可直接
AutoModelForCausalLM.from_pretrained("TheBloke/...-GPTQ")加载社区量化好的权重验证推理。
3. AWQ:激活感知的权重量化
3.1 定义与语义
一句话:不是所有权重同等重要——按『激活幅度』挑出约 1% 的显著权重通道,在量化时重点保护它们,整体权重仍压到 INT4。
AWQ 的洞察:权重是否重要,不看权重本身的大小,而看它对应的激活幅度。激活大的那几个输入通道,对应的权重列更关键,量化时要少失真。
3.2 底层原理
AWQ 不做混合精度(那样硬件不友好),而是用**逐通道缩放(per-channel scaling)**来等价保护:
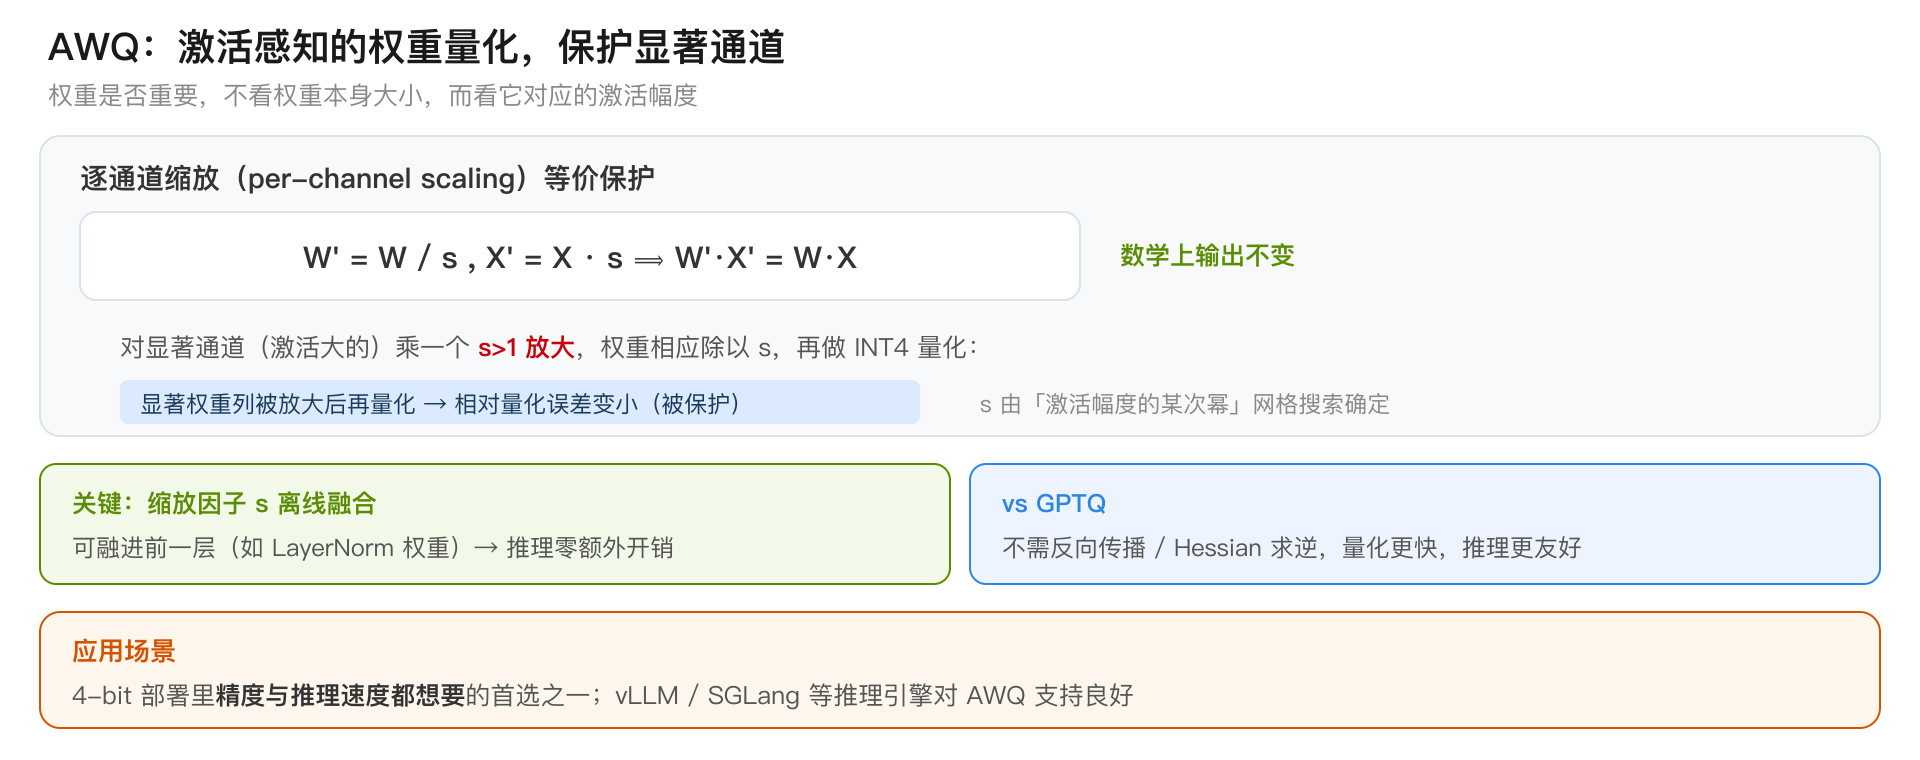
对显著通道(激活大的)乘一个 s>1 放大、权重相应除以 s,由于 W' = W/s、X' = X·s,数学上 W'·X' = W·X 输出不变;但显著权重列被放大后再做 INT4 量化,相对量化误差变小(被保护)。缩放因子 s 由「激活幅度的某次幂」网格搜索确定,使整层输出误差最小。
关键:缩放因子 s 可以离线融合进前一层(如 LayerNorm 的权重),推理时零额外开销。
3.3 演进关系
- 和 GPTQ 同属 weight-only INT4,但思路不同:GPTQ 用 Hessian 做误差补偿,AWQ 用激活幅度做通道保护+等价缩放。
- AWQ 不需要反向传播 / Hessian 求逆,量化更快,且因为缩放可融合,推理速度通常比 GPTQ 更友好,精度相当或更好。
3.4 应用场景
4-bit 部署里精度与推理速度都想要的首选之一,vLLM / SGLang 等推理引擎都对 AWQ 有良好支持。
3.5 实例代码
# file: awq_demo.py
# 运行: python awq_demo.py   (需要 GPU)
# 依赖: pip install torch transformers autoawq
#   或直接加载社区 AWQ 模型验证推理
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

# 方式一:加载社区已量化好的 AWQ 模型(最快验证)
model_id = "TheBloke/Llama-2-7B-AWQ"   # 换成你能访问的 AWQ 模型
tok = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, device_map="cuda")
print("AWQ 4-bit 显存:", round(model.get_memory_footprint() / 1e9, 3), "GB")

ids = tok("The key idea of AWQ is", return_tensors="pt").to("cuda")
out = model.generate(**ids, max_new_tokens=20)
print(tok.decode(out[0], skip_special_tokens=True))

# 方式二:用 autoawq 自己量化(节选)
# from awq import AutoAWQForCausalLM
# m = AutoAWQForCausalLM.from_pretrained("facebook/opt-125m")
# m.quantize(tok, quant_config={"w_bit": 4, "q_group_size": 128,
#                               "zero_point": True, "version": "GEMM"})
# m.save_quantized("opt-125m-awq")
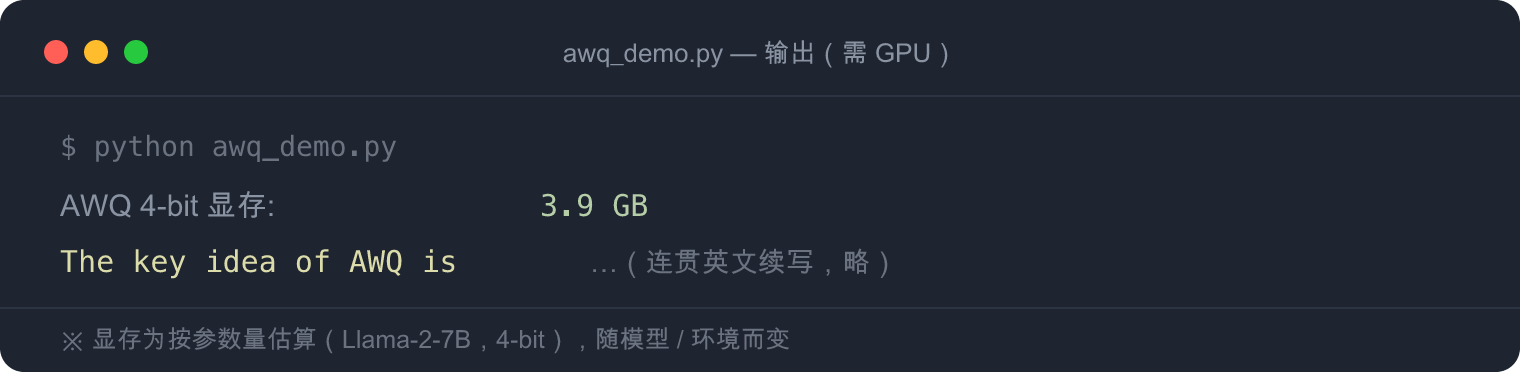
参考输出(显存为估算值,需 GPU 实跑):
4. SmoothQuant:把激活难度「平滑」给权重
4.1 定义与语义
一句话:通过一个数学等价变换,把激活里难量化的异常值『难度』部分转移到权重上,让激活和权重都变得好量化,从而 W8A8 可行。
前面说过:激活有异常值、难量化;权重温和、好量化。SmoothQuant 的点子是——均摊一下难度:把激活的尖锐部分「挪」一些给权重承担。
4.2 底层原理
核心是一个逐通道的等价缩放。对矩阵乘 Y = X·W,插入对角缩放矩阵 diag(s):
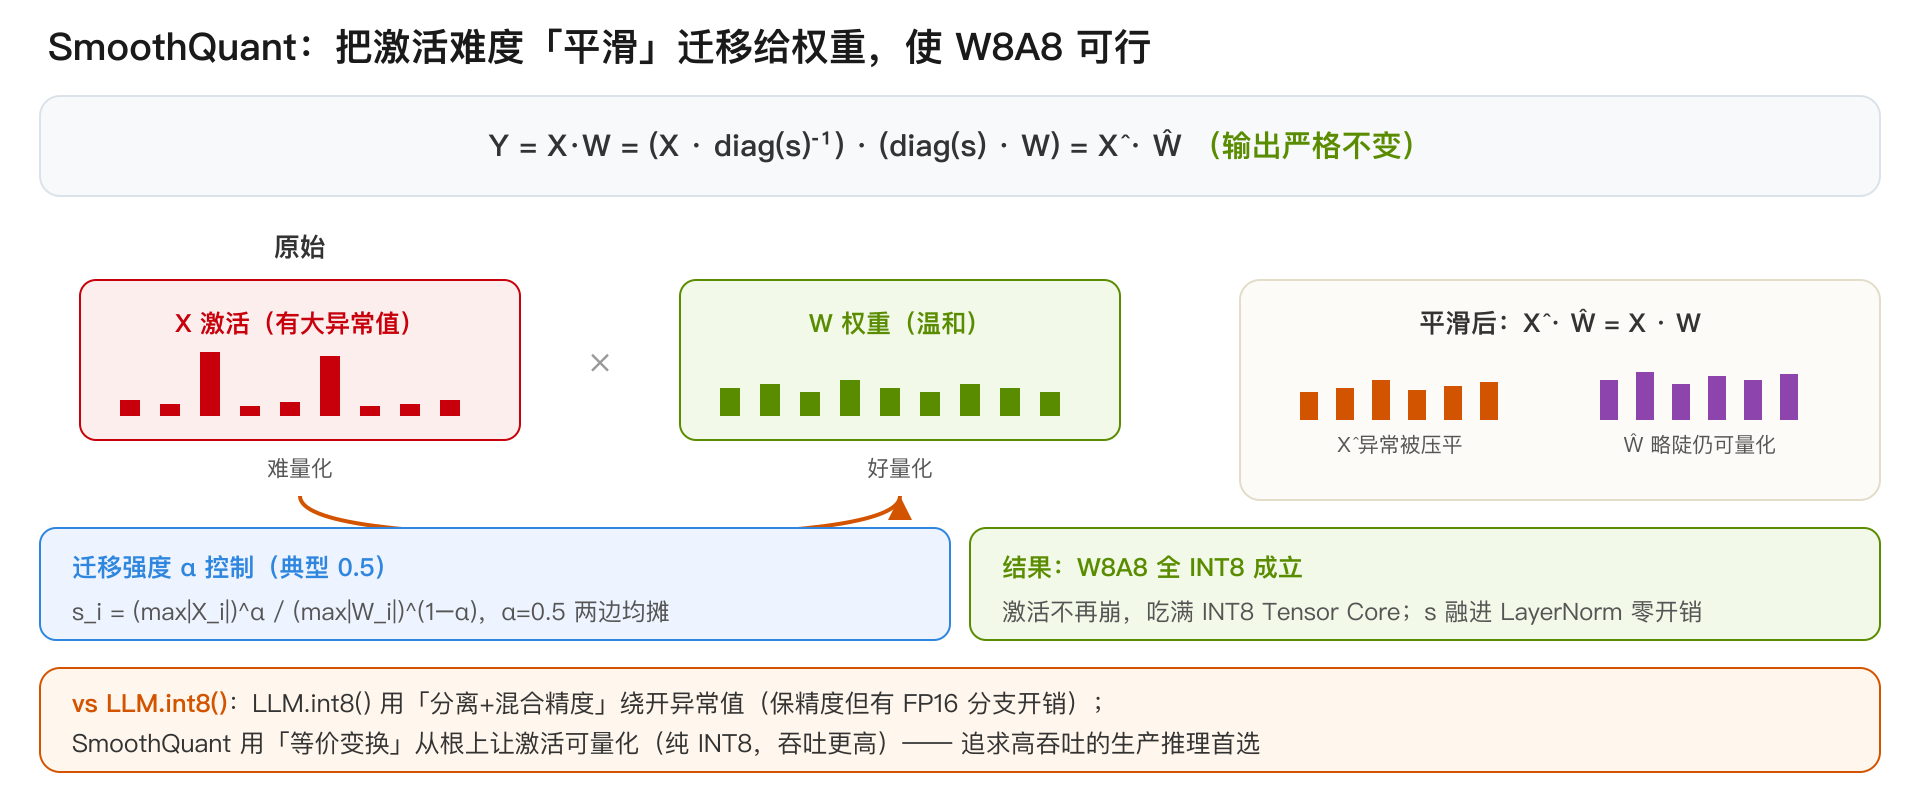
Y = X·W = (X·diag(s)⁻¹) · (diag(s)·W) = X̂·Ŵ
每个通道 i:激活除以 s_i、权重乘以 s_i,输出 X̂·Ŵ = X·W 严格不变。缩放因子由迁移强度 α(典型 0.5)控制:s_i = (max|X_i|)^α / (max|W_i|)^(1−α),α=0 完全不迁移、α=1 全迁给权重、α=0.5 两边均摊。
迁移之后,激活异常值被「压平」,per-tensor INT8 量化激活不再崩,于是 W8A8 全 INT8 成立,能吃满 INT8 Tensor Core。
4.3 演进关系
- SmoothQuant 是 W8A8(权重+激活都 INT8),和 GPTQ/AWQ 的 weight-only 定位完全不同:后者只为省显存,SmoothQuant 为的是激活也量化、拿满 INT8 吞吐。
- 和 LLM.int8() 对比:LLM.int8() 用「分离+混合精度」绕开异常值(保精度但有 FP16 分支开销);SmoothQuant 用「等价变换」从根上让激活可量化(纯 INT8,吞吐更高)。
4.4 应用场景
追求高吞吐的生产推理:batch 大、要吃满 INT8 算力的服务场景。缩放因子离线融合进 LayerNorm,推理零额外开销。
4.5 实例代码:从零演示「平滑」等价变换
下面这段不依赖专用库,手动演示 SmoothQuant 的核心——平滑前后输出不变,但激活变得好量化。
# file: smoothquant_core.py
# 运行: python smoothquant_core.py
# 依赖: pip install torch
import torch

def per_tensor_quant_dequant(x, qmax=127):
    s = x.abs().max() / qmax
    return (torch.round(x / s).clamp(-qmax, qmax) * s), s

torch.manual_seed(0)
C_in, C_out, T = 16, 8, 32
X = torch.randn(T, C_in)
X[:, 3] *= 60.0            # 第 3 个通道制造激活异常值(难量化)
W = torch.randn(C_in, C_out) * 0.1   # 权重温和

Y_ref = X @ W             # 浮点基准

# ---- 不做平滑:直接 per-tensor 量化激活 ----
Xq, _ = per_tensor_quant_dequant(X)
Wq, _ = per_tensor_quant_dequant(W)
err_raw = (Y_ref - Xq @ Wq).abs().mean().item()

# ---- SmoothQuant 平滑(alpha=0.5)----
alpha = 0.5
act_scale = X.abs().amax(dim=0)          # 每个输入通道的激活幅度
wt_scale = W.abs().amax(dim=1)           # 每个输入通道对应的权重幅度
s = (act_scale ** alpha) / (wt_scale ** (1 - alpha) + 1e-8)
X_hat = X / s                            # 激活除以 s(异常被压平)
W_hat = W * s.unsqueeze(1)               # 权重乘以 s(等价补偿)

print("等价性检查 |X̂Ŵ - XW|:", (X_hat @ W_hat - Y_ref).abs().max().item())  # ≈0

Xhq, _ = per_tensor_quant_dequant(X_hat)
Whq, _ = per_tensor_quant_dequant(W_hat)
err_smooth = (Y_ref - Xhq @ Whq).abs().mean().item()

print(f"平滑前 W8A8 输出误差: {err_raw:.5f}")
print(f"平滑后 W8A8 输出误差: {err_smooth:.5f}  (下降约 2×)")
参考输出(已固定 torch.manual_seed(0)):
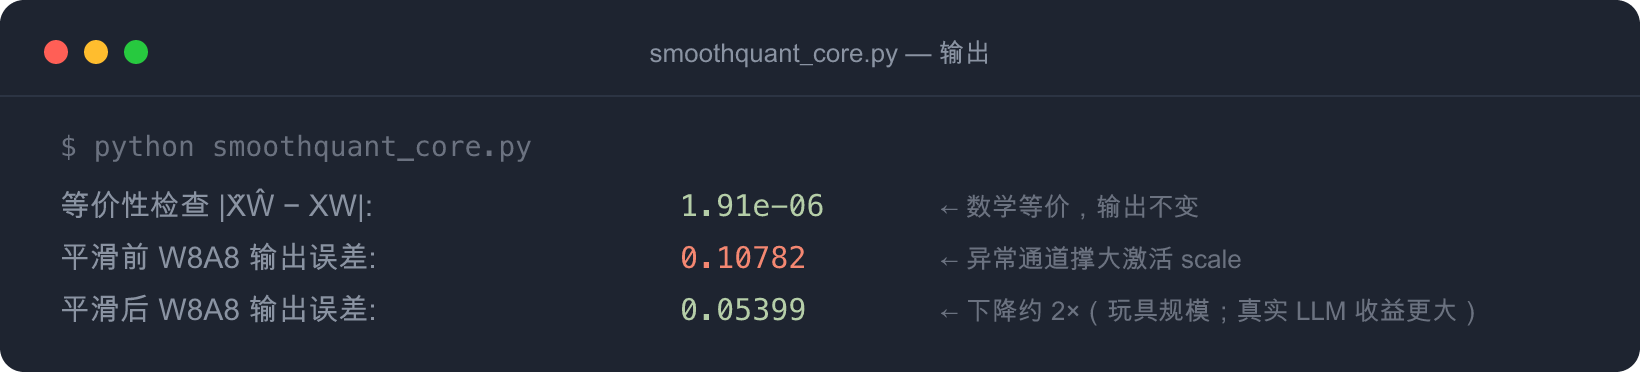
等价性误差 ~1e-6 证明「激活除以 s、权重乘以 s」是严格数学等价;平滑后 W8A8 输出误差从 0.108 降到 0.054。注意这是 16 通道、单个异常值的玩具规模,下降约 2×;真实 LLM(数千维、多条异常通道、per-tensor 激活)上,SmoothQuant 的收益远比这显著——这也是它能让 W8A8 落地的原因。
5. NF4 + 双重量化:QLoRA 的 4-bit NormalFloat
5.1 定义与语义
一句话:用一套专为『正态分布』设计的非均匀 4-bit 格点(NormalFloat4)来量化权重,比均匀的 INT4 更贴合权重的真实分布;再对「量化参数本身」做二次量化(双重量化)进一步省显存。
5.2 底层原理
NF4(4-bit NormalFloat):INT4 的 16 个格点是均匀分布的,但神经网络权重近似服从正态分布 N(0, σ²)——中间密、两边疏。用均匀格点量化正态数据,中间密集区的格点不够用、两边稀疏区的格点浪费。
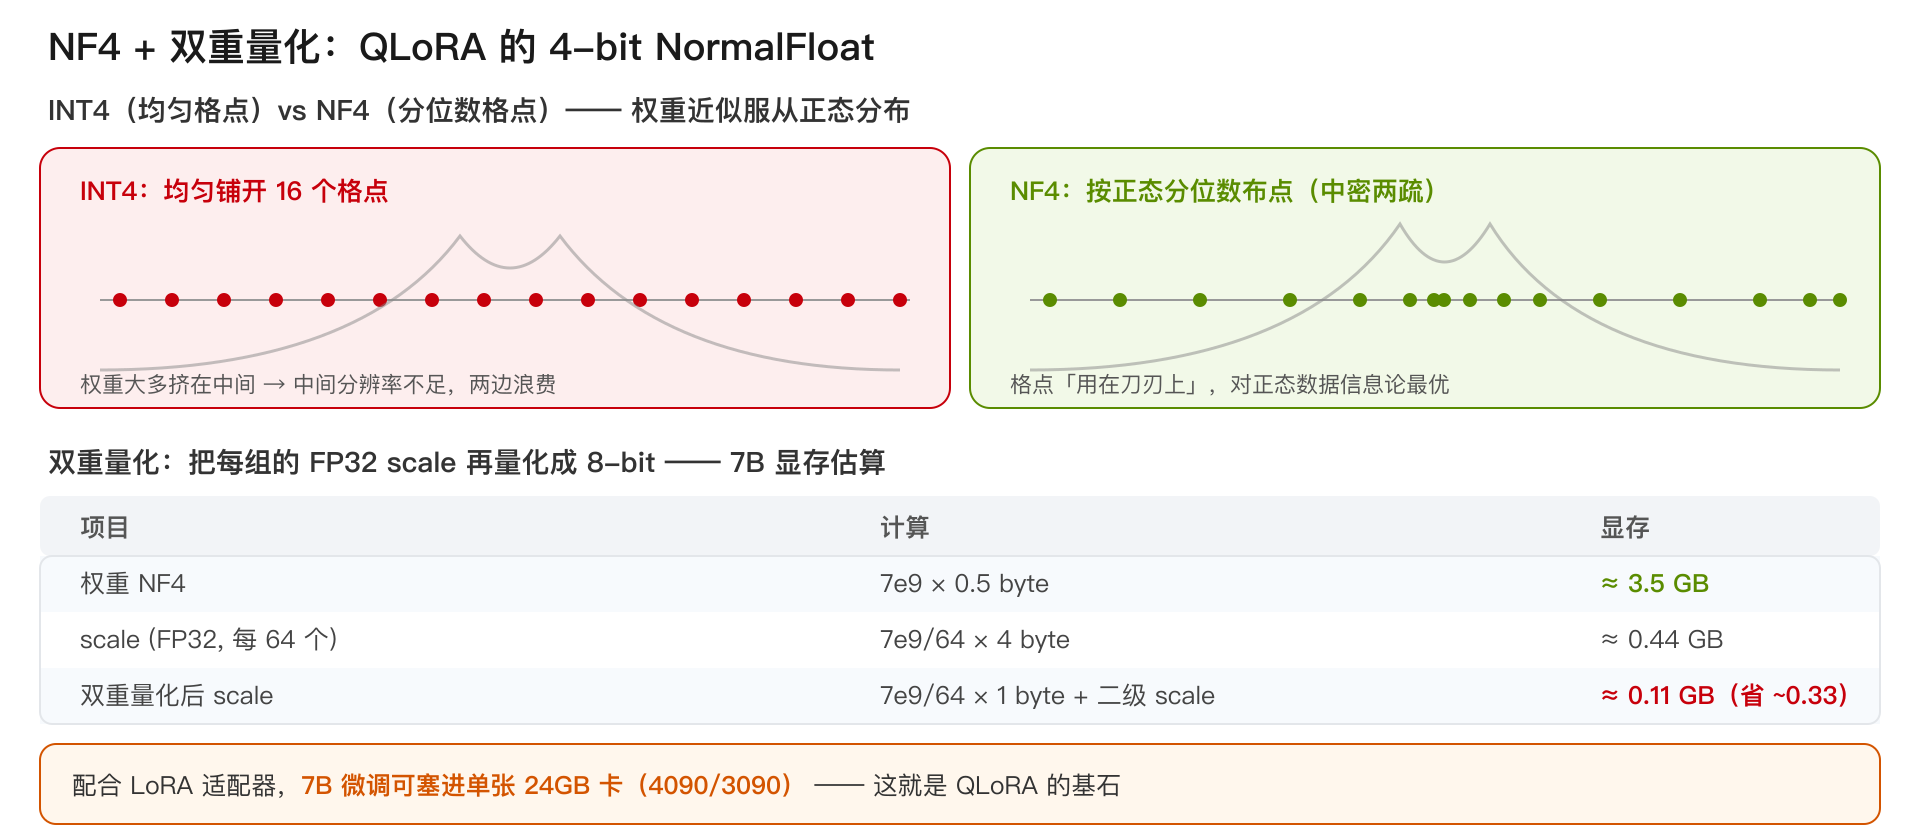
NF4 的 16 个格点取自标准正态分布的分位数(中间密、两边疏,格点「用在刀刃上」,信息论上对正态数据是最优的 4-bit 表示),并保证 0 被精确表示(对稀疏/padding 友好)。
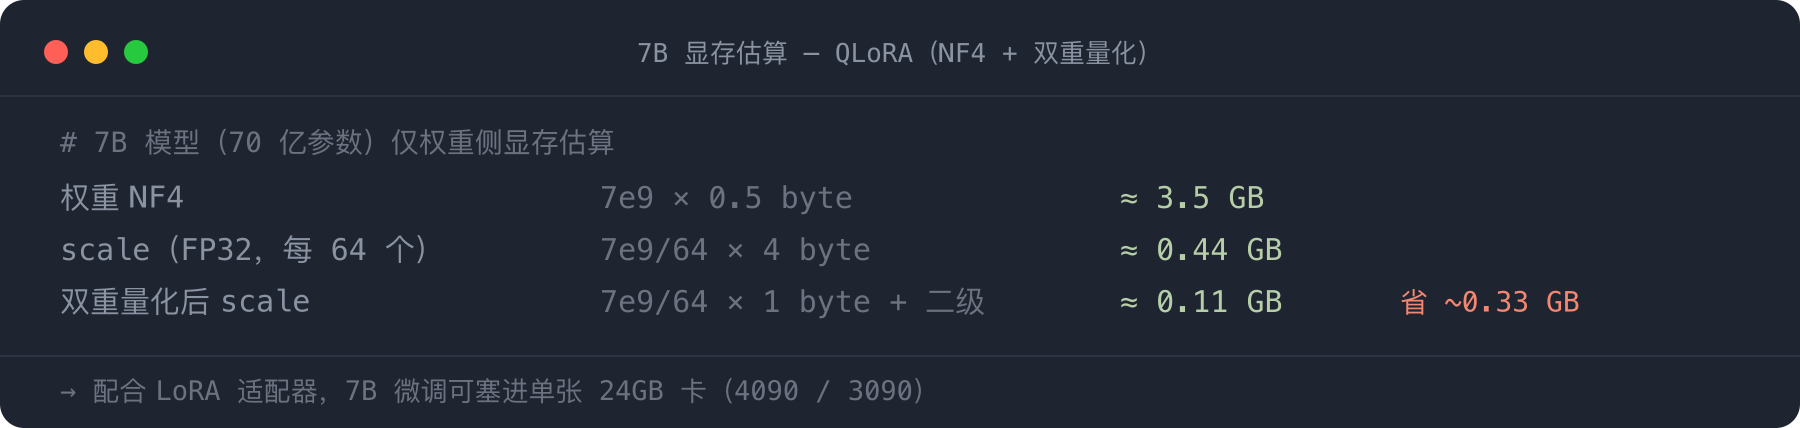
双重量化(Double Quantization):量化时每 64 个权重一组,各有一个 FP32 的 scale(也叫 absmax)。模型大了这些 scale 本身也占不少显存。双重量化把这些 FP32 scale 再量化成 8-bit,平均每个参数再省 ~0.4 bit。
7B 模型(QLoRA 配置)仅权重侧的显存估算:
5.3 演进关系
- NF4 也是 weight-only 4-bit,但格点非均匀(分位数),这是它和 INT4(均匀)的本质区别——对正态分布权重,NF4 的量化误差更小。
- 它是 QLoRA 的基石:base 模型用 NF4 冻结(省显存),只训练少量 LoRA 适配器(FP16/BF16),实现单卡微调大模型。
5.4 应用场景
低显存微调(QLoRA):想在一张消费卡上微调 7B/13B,首选 NF4。推理场景若只求省显存也可用,但纯推理吞吐一般不如 AWQ/GPTQ 的专用 kernel。
5.5 实例代码
# file: nf4_qlora_demo.py
# 运行: python nf4_qlora_demo.py   (需要 GPU)
# 依赖: pip install torch transformers accelerate bitsandbytes peft
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

model_id = "facebook/opt-1.3b"
tok = AutoTokenizer.from_pretrained(model_id)

# NF4 + 双重量化配置
nf4_cfg = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",            # 用 NF4 而非普通 fp4/int4
    bnb_4bit_use_double_quant=True,       # 开启双重量化
    bnb_4bit_compute_dtype=torch.bfloat16 # 计算时反量化到 bf16
)
model = AutoModelForCausalLM.from_pretrained(model_id, quantization_config=nf4_cfg, device_map="cuda")
print("NF4 4-bit 显存:", round(model.get_memory_footprint() / 1e9, 3), "GB")

# 接 LoRA 即为 QLoRA(节选)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
model = prepare_model_for_kbit_training(model)
lora = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"],
                  lora_dropout=0.05, bias="none", task_type="CAUSAL_LM")
model = get_peft_model(model, lora)
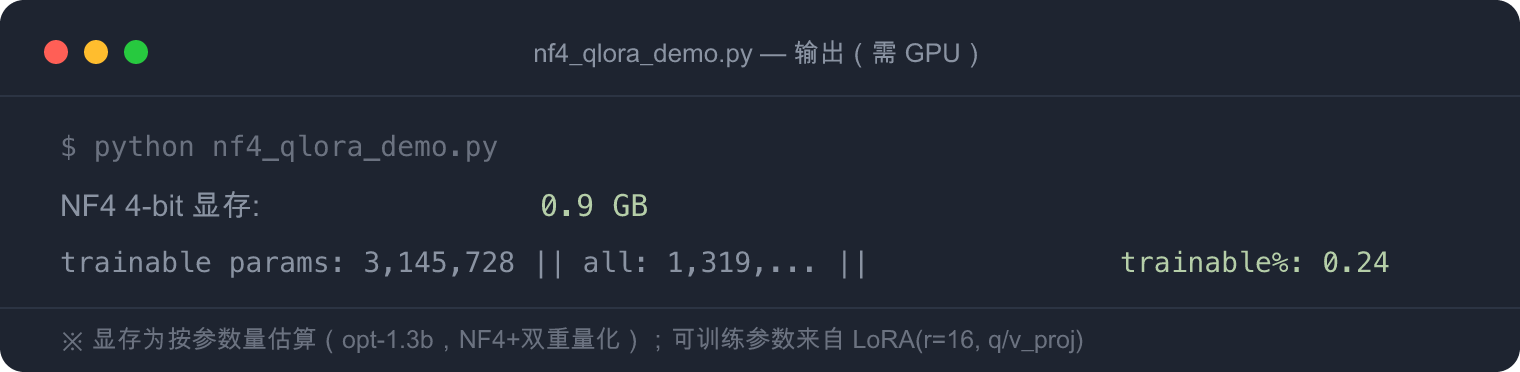
model.print_trainable_parameters()        # 可训练参数通常 <1%
参考输出(显存为估算值,需 GPU 实跑):
全系列总结:怎么选?
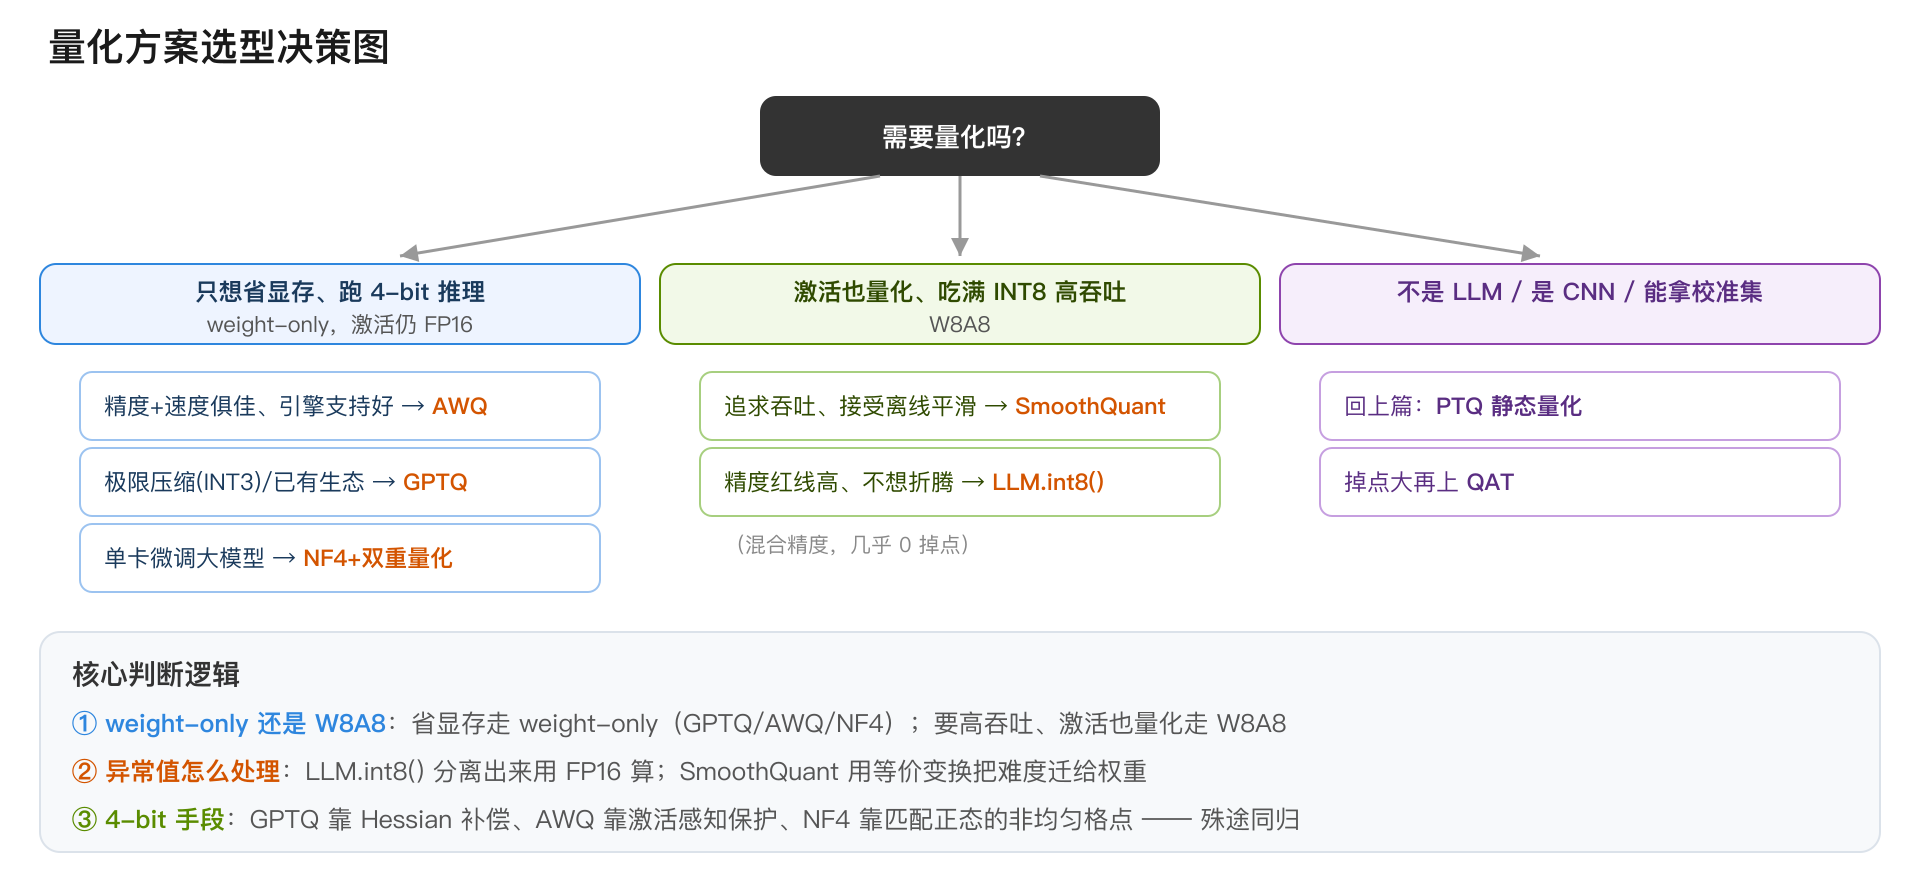
把上下两篇串起来,一张决策图收尾:
核心判断逻辑:
- weight-only 还是 W8A8:只想省显存走 weight-only(GPTQ/AWQ/NF4);要高吞吐、激活也量化走 W8A8(SmoothQuant/LLM.int8())。
- 异常值怎么处理:LLM.int8() 分离出来用 FP16 算;SmoothQuant 用等价变换把难度迁给权重。
- 4-bit 权重量化的手段:GPTQ 靠 Hessian 误差补偿,AWQ 靠激活感知保护显著通道,NF4 靠匹配正态分布的非均匀格点——三条不同的路,殊途同归都把 7B 压进了消费级显卡。
回到上篇的那句话:所有 LLM 量化方案,本质都是在跟『异常值』和『4-bit 精度损失』这两件事搏斗。理解了上篇的仿射映射、对称/非对称、per-channel 和校准,再看这些方案,就会发现它们不过是地基概念在 LLM 特性上的针对性演进而已。
附录:参考资料
本篇 5 个方案都来自各自的原始论文,想深入某个方法,顺着对应条目读原文即可。
- Dettmers et al., LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale, NeurIPS 2022 — 异常值特征维度的发现与「分离+混合精度分解」方案,
bitsandbytes的load_in_8bit即其实现(arXiv:2208.07339)。 - Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023 — 基于 Hessian 二阶信息的逐层 weight-only 量化,
auto-gptq的理论来源(arXiv:2210.17323)。 - Frantar & Alistarh, Optimal Brain Compression, NeurIPS 2022 — OBQ/OBC,GPTQ 误差补偿思路的前身(arXiv:2208.11580)。
- Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024 — 按激活幅度保护显著权重通道 + 等价缩放,
autoawq的理论来源(arXiv:2306.00978)。 - Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023 — 把激活量化难度等价迁移给权重,使 W8A8 可行(arXiv:2211.10438)。
- Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023 — NF4(4-bit NormalFloat)+ 双重量化 + 分页优化器,单卡微调大模型的基石(arXiv:2305.14314)。
- Hugging Face Transformers 量化文档 —
BitsAndBytesConfig/GPTQConfig的用法与各后端对比:https://huggingface.co/docs/transformers/main/quantization。