引言:先把 CPU 的角色说清楚
如果把一台计算机比作一家工厂,CPU 就是那个既管调度、又常常亲自上阵的总工头。它算得不一定最快(那是 GPU 的活儿),但几乎每件事都要先经过它的手。接下来四章分别回答四个问题:它从哪里来、如今有哪些型号可选、在 AI 的运行链路里究竟承担什么、以及当它成为瓶颈时该怎么办。
一、CPU 发展史:55 年,四次关键转身
CPU 的演进不是一条匀速的直线,而是几次被"物理极限"逼出来的转向。
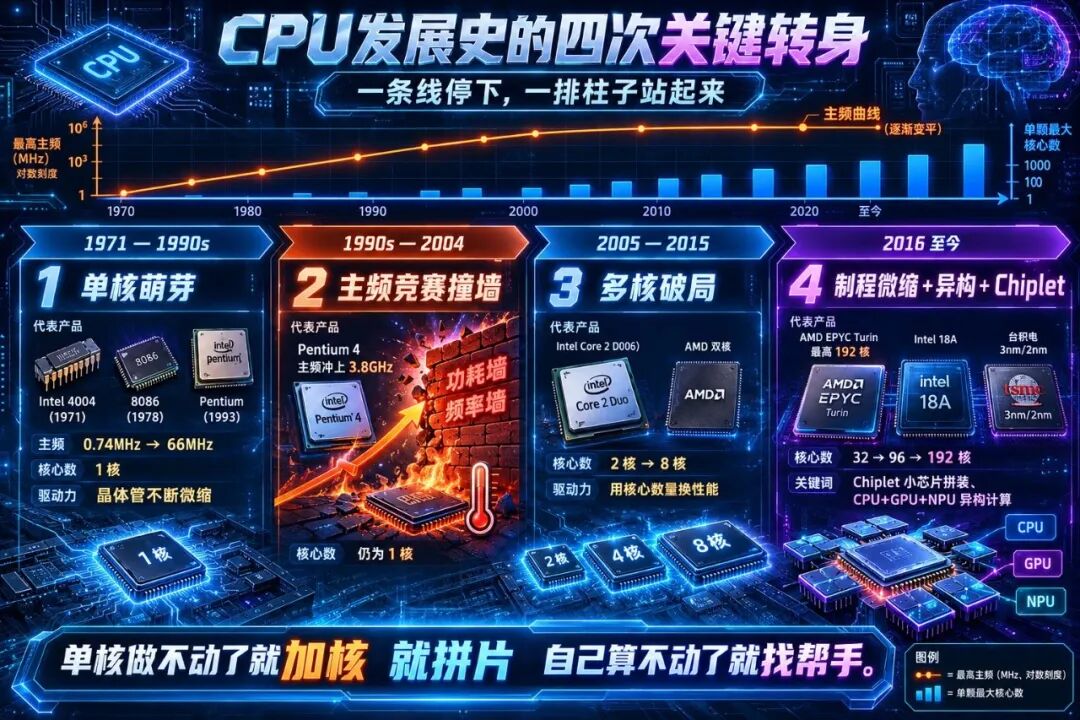
- 单核萌芽(1971—1990s) 1971 年 Intel 4004 问世,第一次把运算单元塞进一块指甲盖大小的芯片里。1978 年的 8086 奠定了延续至今的 x86 指令集,1993 年的奔腾(Pentium)把个人电脑带入主流。驱动力:晶体管越做越小,同样面积能塞下更多电路。
- 主频竞赛撞墙(1990s—2004) 这一阶段厂商比的是"谁的 GHz 更高",奔腾 4 一度冲向 3.8GHz。但频率越高,发热和漏电呈指数增长,撞上了业界所说的"功耗墙"与"频率墙"——再往上加频率,芯片先被自己烤化了。
- 多核破局(2005—2015) 既然单核跑不快,就让多个核心一起干活。2006 年 Intel Core 2 Duo、AMD 双核处理器普及,软件开始学习"并行思维"。驱动力:用核心数量换性能,绕开频率天花板。
一句话总结:CPU 的历史,就是一部"单核做不动了就加核、单片做不大了就拼片、自己算不动了就找帮手"的不断妥协与创新史。
二、当前主流 CPU 型号全景
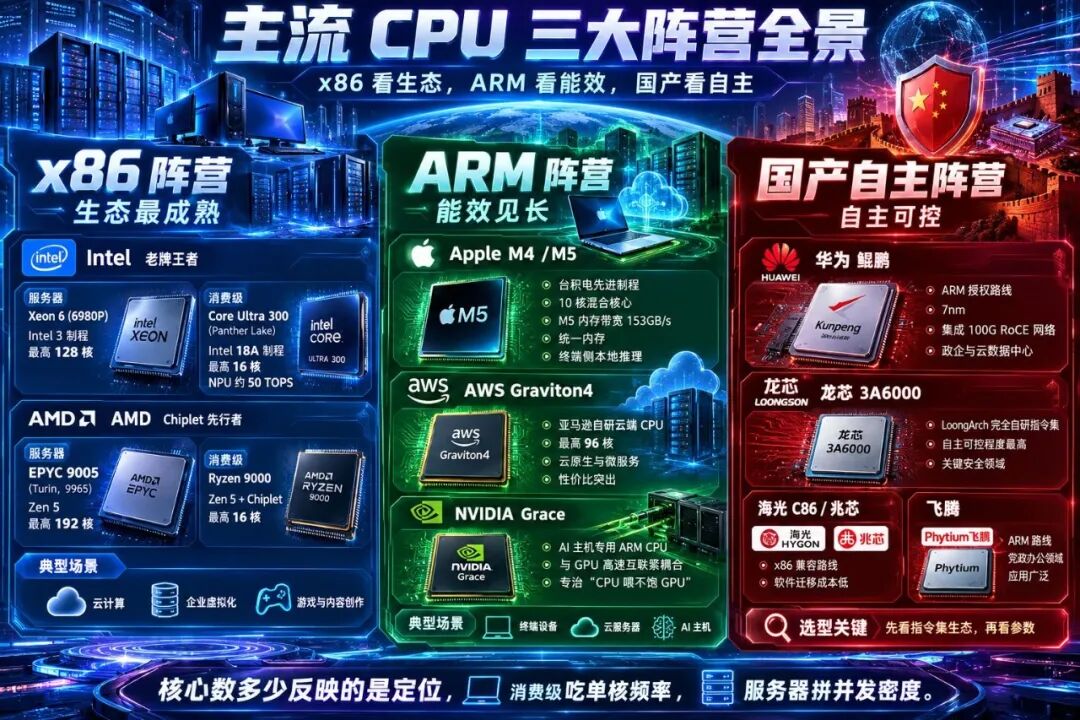
今天的市场大致分成三大阵营:以 Intel、AMD 为代表的 x86,以 Apple、AWS、华为为代表的 ARM,以及正在快速崛起的国产自主阵营。
x86 双雄:数据中心与 PC 的基本盘
Intel · 老牌王者
- 服务器:Xeon 6(6980P)—— Intel 3 制程,性能核版本最高 128 核,分性能核与能效核两条产品线,主攻云计算与企业级虚拟化。
- 消费级:Core Ultra 300(Panther Lake)—— 首款 Intel 18A 量产平台,最高 16 核三层混合核心设计,NPU 约 50 TOPS,面向 AI PC 与轻薄本。
AMD · Chiplet 先行者
- 服务器:EPYC 9005(Turin,如 9965)—— Zen 5 架构,最高 192 核,核心密度与能效领先,常被直接用来承载中小模型的 CPU 推理。
- 消费级:Ryzen 9000 —— 同为 Zen 5 + Chiplet,最高 16 核,游戏与内容创作的主力选择。
ARM 阵营:从一块手机芯片长成数据中心的另一极
- Apple M4 / M5 台积电先进制程,10 核 CPU(性能核 + 能效核混合)。M5 内存带宽升至 153GB/s,统一内存架构让终端侧本地推理体验突出。
- AWS Graviton4 亚马逊自研云端 CPU,最高 96 核,为云原生与微服务场景优化,性价比与能效是其核心卖点。
- NVIDIA Grace 专为 AI 主机设计的 ARM CPU,与 GPU 通过高速互联紧耦合,目标就是解决"CPU 喂不饱 GPU"的问题。
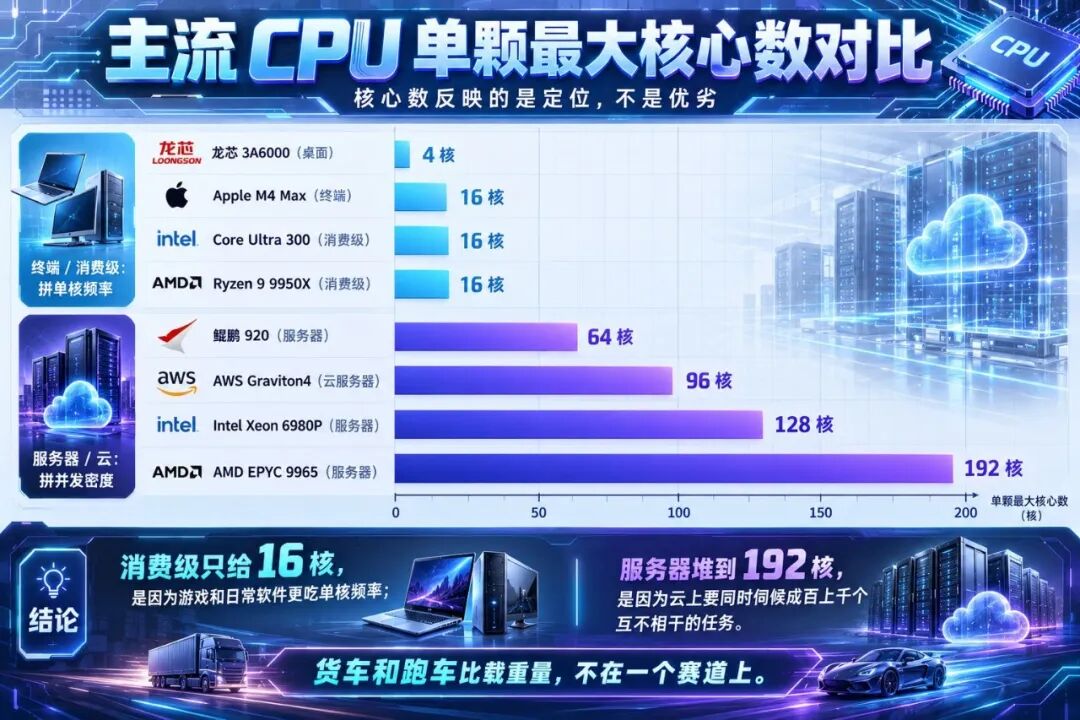
主流 CPU 单颗最大核心数对比:浅色为终端与消费级,深色为服务器与云
别只看核心数:核心多少反映的是定位,不是优劣。消费级 CPU 只给 16 核,是因为游戏和日常软件更吃单核频率;服务器堆到 192 核,是因为云上要同时伺候成百上千个互不相干的任务。这就像货车和跑车比载重量——不在一个赛道上。
国产阵营走的是三条不同的技术路线,选型时要先看"指令集生态":
- ARM 授权路线 —— 华为鲲鹏 920:7nm,最高 64 核,兼容 ARMv8,集成 100G RoCE 网络,服务器生态成熟,适合政企与云数据中心。
- 自主指令集路线 —— 龙芯 3A6000:采用完全自研的 LoongArch 指令集,自主可控程度最高,适合对安全自主要求极高的关键领域。
- x86 授权 / 兼容路线 —— 海光 C86、兆芯:兼容 x86 生态,软件迁移成本低,适合要延续现有 x86 应用的场景。此外飞腾(ARM 路线)在党政办公领域应用广泛。
三、CPU 对 AI 模型端到端性能的影响
很多人以为"AI 全靠 GPU,CPU 无所谓",这是最常见的误解。在一条完整的模型运行链路里,CPU 其实是那个发号施令的指挥官——GPU 再快,也得等 CPU 把活儿派下来。
CPU 在推理链路中到底在做什么
- 图片解码、文本分词、Tensor 组装大多在 CPU 上完成。DataLoader 线程不够快,GPU 就会"饿着"空转。
- 每一次 PyTorch 算子调用,都要由 CPU 把对应的 GPU kernel 发射(kernel launch)出去。模型里成千上万个小算子,就是成千上万次 CPU 提交。
- CPU 负责内存搬运(H2D/D2H)、多卡通信调度、服务请求的批处理(batching)。协同不好,加速卡就被拖累。
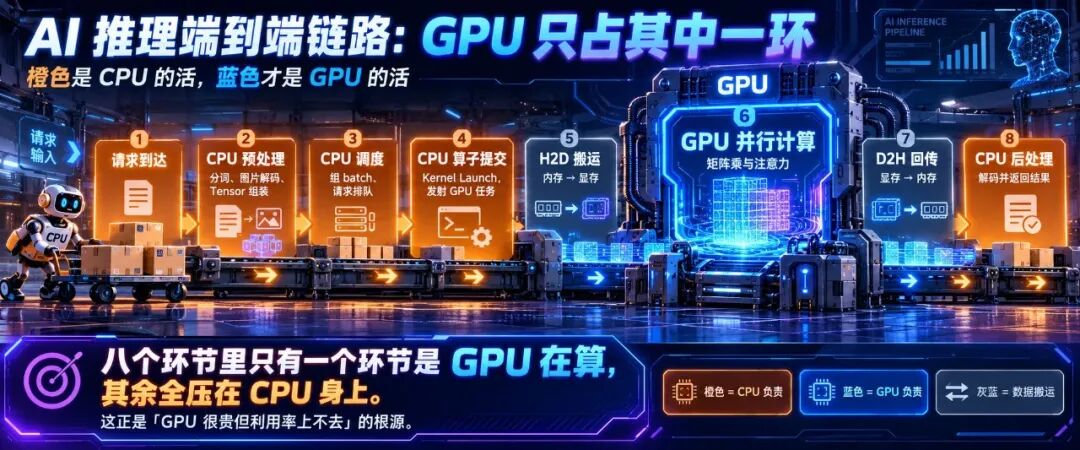
AI 推理端到端链路:橙色为 CPU 负责环节,蓝色为 GPU 计算,灰蓝为数据搬运
数一下就会发现:整条链路上只有一个环节是 GPU 在算,其余全都压在 CPU 身上。这正是"GPU 很贵但利用率上不去"的根源所在。
为什么 CPU 会成为瓶颈
用一个类比:GPU 是流水线上一台超高速的冲压机,CPU 是给它递料的工人。如果工人递料(kernel launch、算子提交)的速度跟不上冲压机的节奏,再贵的冲压机也只能停在那里等料。这种现象就是典型的"CPU-bound(CPU 受限)":
- Kernel Launch 开销:小算子多、单算子计算量小的模型(如很多小 batch 的在线推理),CPU 发射指令的固定开销占比被放大,GPU 利用率反而上不去。
- Python 与算子库开销:PyTorch 的 ATen 算子库、Python 解释器的调度都跑在 CPU 上,GIL(全局解释器锁)还会限制多线程并发。
- 内存带宽与缓存:数据从内存喂给 CPU 再送往 GPU,内存带宽不足、缓存命中率低,都会直接拉高端到端延迟。
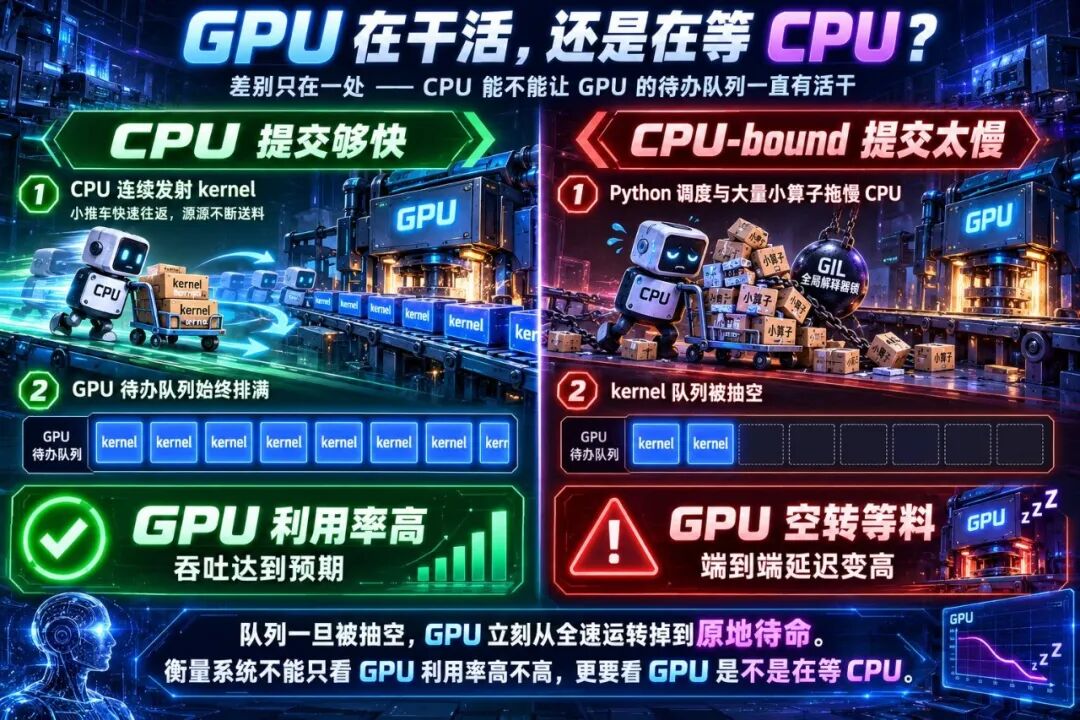
健康状态与 CPU-bound 状态对比:差别只在 GPU 的待办队列有没有被抽空
两条路径的差别只在一处:CPU 能不能让 GPU 的待办队列一直有活干。队列一旦被抽空,GPU 立刻从"全速运转"掉到"原地待命"。
这不是理论推演:一次有据可查的实测
2023 年底,PyTorch 官方团队发表了博客 Accelerating Generative AI with PyTorch II: GPT, Fast,并开源了配套仓库 pytorch-labs/gpt-fast。他们想回答一个问题:只用不到一千行纯原生 PyTorch 代码,Transformer 推理能跑到多快。测试条件写得很清楚——Llama-7B,fp16,batch size = 1,单张 A100-80GB,功耗限制在 330W。
第一版实现写得极简,跑出来却很慢。团队抓了一份 trace,给出的诊断直截了当:
“it’s heavily CPU overhead bound! What this means is that our CPU is not able to tell the GPU what to do fast enough for the GPU to be fully utilized.”
(性能严重受 CPU 开销限制。也就是说,我们的 CPU 没法足够快地告诉 GPU 该干什么,GPU 因此无法被充分利用。)
接着原文用了一个类比,和本文前面那台"冲压机与小推车"几乎是同一个意思:
“Imagine the GPU as this super massive factory with a ridiculous amount of compute available. Then, imagine the CPU as some messenger shuttling instructions back and forth to the GPU.”
(把 GPU 想象成一座算力多到荒谬的超大工厂,而 CPU 是那个来回传递指令的信使。)
原文还补了一句值得留意的判断:在大规模深度学习系统里,GPU 承担 100% 的实际计算,CPU 唯一的职责就是告诉 GPU 该做什么。可即便分工如此悬殊,“信使跟不上工厂"依然常见得出乎意料。
解法不是把 CPU 换快,而是让它少跑几趟:给 torch.compile 开 mode="reduce-overhead" 和 fullgraph=True,把成片的小 kernel 捕获进一个编译区域,底层自动套上 CUDAGraphs。为了让这招生效,团队还要先把动态增长的 kv-cache 改成静态预分配,并把 prefill 与 decode 两个阶段分开编译。
收效用原文的话说是 “performance improves by more than 4x”,最终落在 107 tokens/s。换算成模型带宽利用率(MBU)是 72%,已经逼近"把权重从显存搬进寄存器"的物理上限,连单纯的内存拷贝都很难超过 85%。
这组数字里有一处需要如实说明:107 tokens/s 和"4 倍以上提升"是官方博客的明确表述,但优化前的起点只出现在博客图表中,正文并未写成数字,国内转载普遍把它记作 25.5 tok/s。对外引用时,建议只用官方口径的"4 倍以上"与 107 tokens/s。
社区侧还有一个更小、更干净的对照实验,来自知乎文章 《从 torch.compile 到 CUDA Graph:PyTorch 为什么能加速》:把 F.relu(F.linear(x, w, b)) 堆 8 层,eager 模式耗时 7.51ms,编译后 2.02ms,差 3.7 倍。前后的数学运算量完全一致。作者的结论是:“不是数学算不动,而是指挥系统在空转。”
省掉的到底是什么?另一篇 《torch.compile 技术剖析:PyTorch 2.x 编译系统详解》把每次算子调用的固定成本拆成了四步:Python 到 C++ 的函数调用、参数解析与类型检查、分发到正确的 kernel 实现、提交到 CUDA stream。这两篇属于个人技术博客,8 层网络的耗时是作者自测,没有公开的复现脚本,引用时宜标注为社区实测。
怎么解读这些数字:真正的浪费往往不在计算,而在协调。单个 4096×4096 的大矩阵乘,launch 开销可以忽略不计;但神经网络里是成千上万个小算子,每个都要完整走一遍上面那四步,开销就被成倍放大。所以优化方向很明确——不是让 CPU 跑得更快,而是让它少跑几趟。
两个工程案例:CPU 侧的优化到底能换回多少
上面那组实测是在实验室条件下跑出来的(batch size = 1、单卡、一个 7B 模型)。放到真实的生产系统里,CPU 侧的调度与提交同样是性能的主战场。下面两个案例一个针对"少跑几趟”,一个针对"别让 GPU 等人",正好对应本文最后给出的两条优化建议。
案例一:一个人、1.2 万行代码,让 Kimi K3 在同一批卡上快了 1.68 倍
Kimi K3 是月之暗面的 2.8 万亿参数 MoE 模型,架构上有 896 个专家,每处理一个 token 只激活其中 16 个。这种极端稀疏的设计在训练端是"用更少激活参数撬动更大容量"的利器,到了推理端却是工程噩梦:据 SemiAnalysis 分析,它一次前向计算的 HBM 带宽需求约 1.5TB,每次前向会触发超过 120 次 All-to-All 通信。解码阶段因此成为典型的内存带宽受限场景,计算单元大部分时间都在等数据搬运。
问题出在传统推理引擎的解码路径上——注意力一个内核、MoE 路由一个内核、专家计算一个内核、通信再一个内核。每个内核启动都要付一次开销,每次内核间的数据交换都得绕一趟显存。
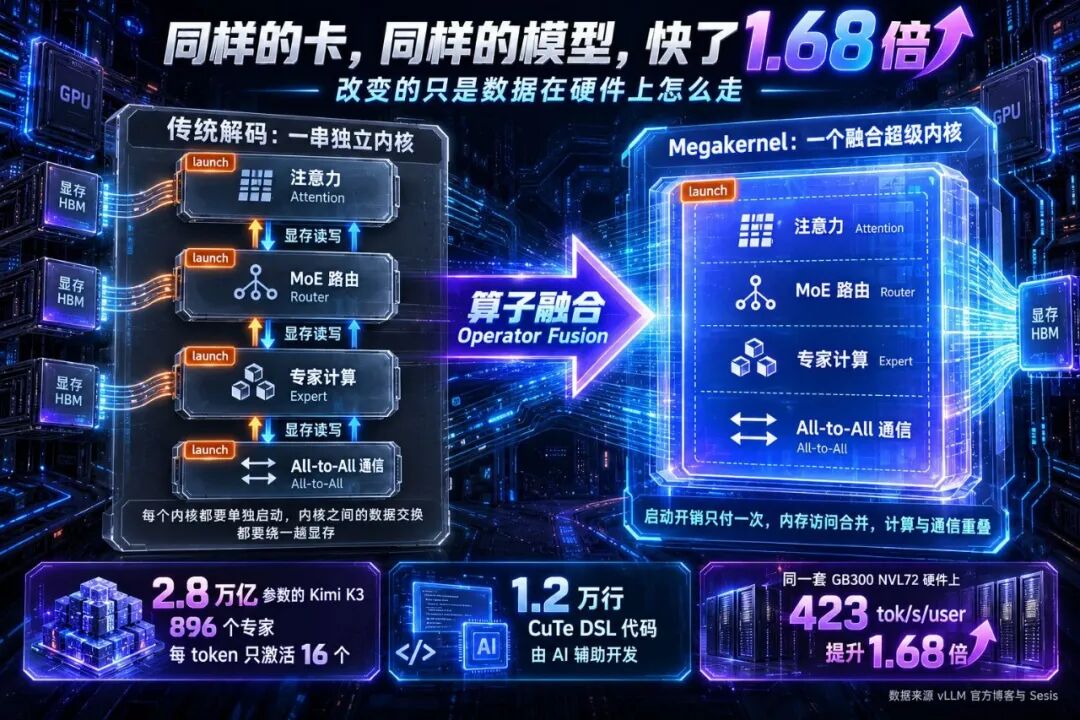
Megakernel 融合:把一串独立内核合并成一个超级内核,启动开销只付一次
英伟达 CentML 的工程师 Benjamin Chislett 的做法是大规模 Megakernel 融合:用英伟达的 CuTe DSL 写了约 1.2 万行代码,把这些分散的解码内核合并成一个高度融合的超级内核,减少启动开销、合并内存访问,并让计算与通信尽可能重叠。
结果是在同一套 GB300 NVL72 硬件上,SemiAnalysis 测得 423 tok/s/user,相比此前提升 1.68 倍;vLLM 官方博客报告的口径是 batch 1 下超过 840 tokens/s,多个测试配置下解码吞吐提升 1.5—2 倍。
“硬件没变,模型没变,改变的是数据在硬件上的流动方式。”
这句话几乎就是本文第四章的注脚。值得一提的还有 vLLM 博客里的另一句自白——“Agent-optimized inference code is outpacing our review and maintenance workflow."(智能体优化出的推理代码,正在超过我们团队的审查与维护速度。)这 1.2 万行内核正是在 AI 辅助下写成的。
数字口径提示:423 tok/s/user 与 vLLM 官方的 840 tokens/s 来自不同测试条件,不宜直接比较或相减;1.68 倍这个倍数才是可引用的结论。相关信息来自 vLLM 官方博客《Hyper Optimizing Kimi K3 in vLLM: Moving Fast and Responsibly》与 SemiAnalysis 的测算。
案例二:vLLM 的连续批处理,把 GPU 的空档填上
第二个案例的瓶颈不在"提交得够不够快”,而在"CPU 怎么排队"。
早期推理框架用的是静态批处理:凑齐一批请求一起送进 GPU,必须等这批里最慢的那条请求生成完,整批才能退出。问题是不同请求的输出长度天差地别——有的回答三个字,有的要写一千字。短请求早就算完了,却只能占着槽位干等,GPU 的算力就这么空耗掉。
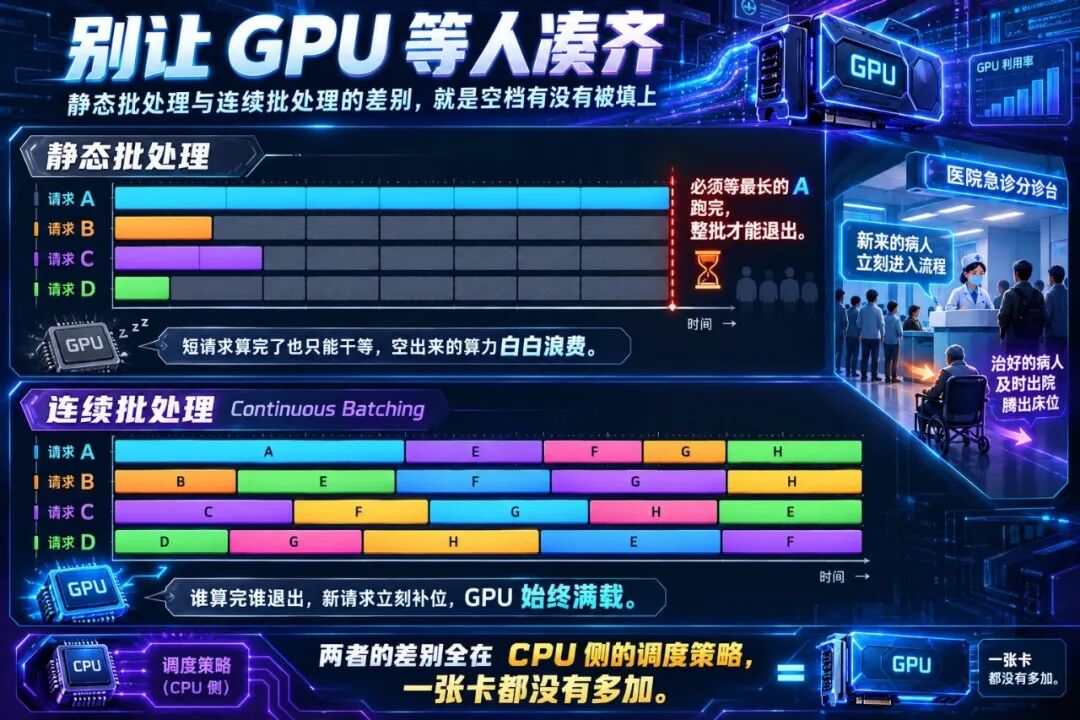
静态批处理与连续批处理:差别全在 CPU 侧的调度策略,一张卡都没有多加
vLLM 的**连续批处理(Continuous Batching)**把调度粒度从"一批"细化到"一个 token":谁生成完谁立刻退出,腾出的槽位马上让新请求补上。有一个流传很广的类比把这件事说得很清楚:
“其核心原理可以类比为医院的急诊分诊系统:新来的患者(请求)会立即进入处理流程,而完成治疗的病人(已生成足够 token 的请求)会及时出院释放资源。”
连续批处理配合 PagedAttention 的显存管理,是 vLLM 吞吐量相比早期方案提升一个量级的主要来源。公开资料普遍提到 Continuous Batching 可把 GPU 利用率推到 80% 以上。注意这里没有增加任何硬件,变的只是 CPU 侧的排队策略。
两个案例的共同点:都没有换卡、没有换模型、没有等下一代制程。案例一是让 CPU 少跑几趟(算子融合),案例二是让 CPU 把队排好(连续批处理)。这正好印证了前面的判断——CPU 很少是算力瓶颈,但经常是调度瓶颈,而调度瓶颈是可以用软件手段解开的。
四、选型与优化建议
硬件选型
- 训练 / 大模型推理:GPU 是主角,CPU 选主频高、单核强的型号做"主控",保证 kernel launch 快,无需堆太多核。
- CPU 推理 / 小中模型:选高核心数、支持 AVX-512 的服务器 CPU(如 EPYC 9005、Xeon 6),很多推理无需加速卡即可跑。
- 关注内存带宽:多通道 DDR5、大缓存对喂数据和降低延迟至关重要。
软件优化
- 减少 launch 次数:用 CUDA Graph、算子融合(operator fusion)把大量小 kernel 合并,降低 CPU 提交开销。英伟达优化 Kimi K3 的 Megakernel 就是这条路走到极致的例子,同硬件提速 1.68 倍。
- 喂饱 GPU:增大 DataLoader 的 worker 数、开启预取(prefetch)和 pin memory,避免 GPU 空等数据。
- 提高并行度:合理设置 batch size、用异步执行与多流(stream)重叠计算和传输。在线服务场景优先选用支持连续批处理(Continuous Batching)的推理框架,如 vLLM,避免短请求占着槽位干等。
延伸案例一:英伟达为什么要自己做一颗 CPU
上面"CPU 选主频高、单核强的型号做主控"这条,听起来像是经验之谈。但如果把它推到极致,会得出一个更激进的结论——与其挑一颗合适的 CPU,不如重新设计 CPU 与 GPU 之间的连接方式。这正是英伟达做 Grace 的动因。
传统做法是 x86 CPU 通过 PCIe 挂上 GPU。问题在于,CPU 的系统内存和 GPU 的显存是两个独立的地址空间,数据往来必须显式拷贝,而 PCIe 5.0 x16 双向带宽约 128GB/s——对于动辄要搬几百 GB 参数和激活值的大模型,这根管子细得很明显。
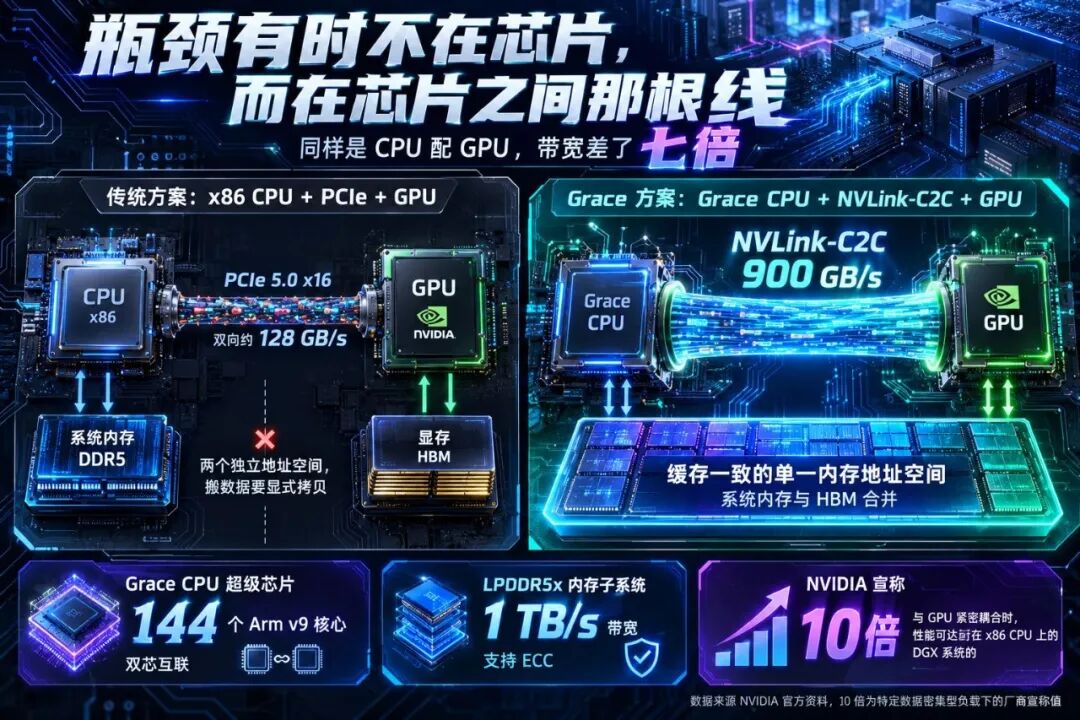
PCIe 与 NVLink-C2C:同样是 CPU 配 GPU,芯片之间那根线差了七倍
Grace 的解法是把这根线换掉。Grace CPU 超级芯片采用双 CPU 互连设计,集成 144 个 Arm v9 核心,通过 NVLink-C2C 实现 900GB/s 的 CPU-GPU 互联带宽,是 PCIe 5.0 的七倍左右。更关键的是架构层面的改变:它提供单一内存地址空间的缓存一致性,把系统内存和 GPU 的 HBM 合并在一起——原先需要显式拷贝的动作,变成了直接访问。内存子系统用 LPDDR5x,带宽 1TB/s,是 DDR4 的两倍,能效是其十倍。
“当与 NVIDIA GPU 紧密耦合时,基于 Grace 的系统性能可比当前最先进的 NVIDIA DGX 系统(在 x86 CPU 上运行)高出 10 倍。”
这个 10 倍要谨慎看待:它是厂商在特定数据密集型负载(如训练万亿参数级 NLP 模型)下的宣称值,不是通用场景的普适结论。可以确定的是带宽这个硬指标——900GB/s vs 128GB/s,以及"统一地址空间省掉显式拷贝"这个架构事实。顺带一提,Grace 在 SPECrate2017_int_base 上的评分是 740,作为通用 CPU 它也不弱。
这个案例对选型的启示是:当你发现 CPU 侧的优化已经做到头、瓶颈仍在"CPU 与 GPU 之间"时,要考虑的就不是换一颗更快的 CPU,而是换一种耦合方式。2026 年 2 月,Meta 宣布将部署数百万颗英伟达芯片,这是首次对纯 Grace 平台的大规模部署——说明这条路在超大规模场景下已经被验证。
延伸案例二:“喂饱 GPU"这件事,英伟达专门做了个库
再看"增大 DataLoader 的 worker 数、开启预取和 pin memory"这条。这些是调参手段,治的是症状。英伟达对病根的描述更直白——问题在于整条预处理流水线都跑在 CPU 上。
训练图像模型要先对图片做归一化,而图片为了省存储通常是压缩的,于是开发者搭出了多级流水线:加载、解码、裁剪、缩放,以及许多其他增强算子。NVIDIA DALI 官方页面对此的判断是:
“These pipelines, which are currently executed on the CPU, have become a bottleneck, limiting overall throughput.”
(这些目前在 CPU 上执行的流水线,已经成为瓶颈,限制了整体吞吐。)
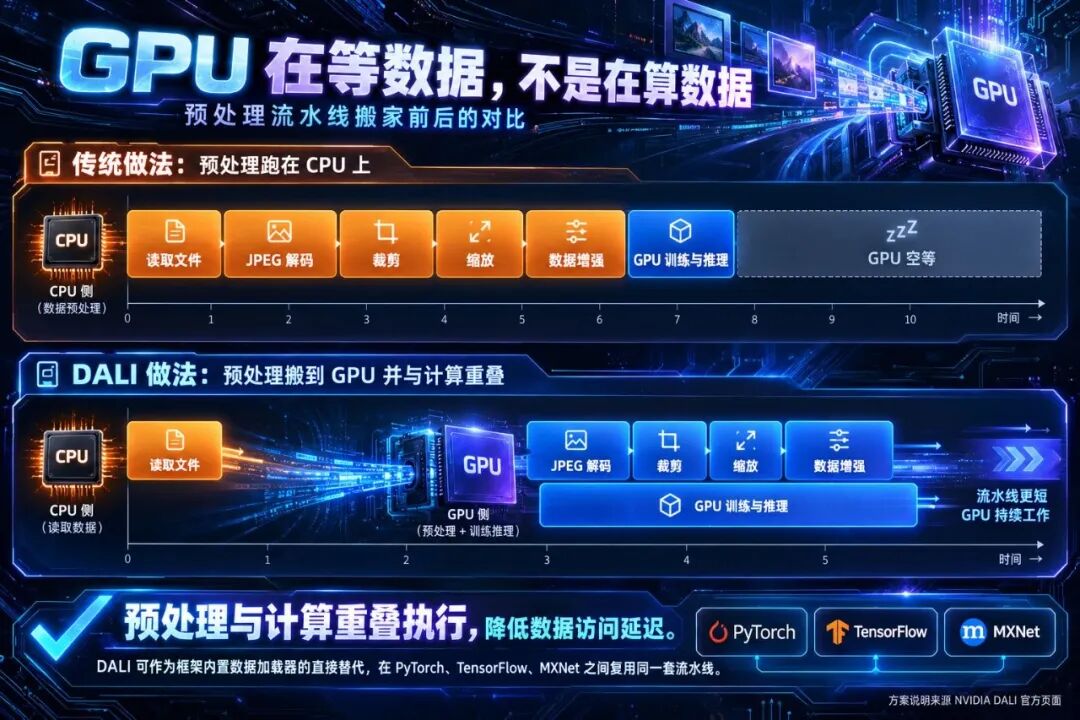
预处理流水线搬到 GPU 并与计算重叠后,GPU 的空等时间几乎消失
DALI(NVIDIA Data Loading Library)的做法是把解码和增强整体搬到 GPU 上执行,并让数据预处理与训练计算相互重叠——GPU 一边算当前这批,一边准备下一批,而不是算完一批再等 CPU 磨好下一批。它支持 JPEG、PNG、TIFF、JPEG2k、wav、flac、H.264、HEVC 等格式,可以直接替换框架内置的 DataLoader,同一套流水线在 PyTorch、TensorFlow、MXNet 之间可复用。
四个案例,三条路径
把全文引用的案例放在一起看,CPU 影响端到端性能的路径其实只有三条。
- 路径一|提交太慢 → 让 CPU 少跑几趟
gpt-fast 用 torch.compile 提速 4 倍以上,英伟达用 Megakernel 让 Kimi K3 在同一批卡上快了 1.68 倍。
手段:算子融合、CUDA Graph。
- 路径二|队排不好 → 让 CPU 把队排好
vLLM 的连续批处理把调度粒度从「一批」细化到「一个 token」,GPU 利用率可推到 80% 以上。
手段:调度策略,一张卡都不用加。
- 路径三|线太细、活太多 → 换耦合方式,或把活挪走
Grace 用 NVLink-C2C 把 CPU-GPU 互联带宽做到 900GB/s,并统一内存地址空间;DALI 把整条预处理流水线搬到 GPU,与计算重叠执行。
一句话收束:CPU 从算力主角退居调度指挥官,但指挥官失职,整条流水线都会停摆。先判断瓶颈落在哪条路径上,再用对工具让它少跑几趟,才能把每一分算力都花在刀刃上。
附录:CPU 术语速查
下面这张速查卡把全文出现的 12 个专业名词归纳在一页里,按"造芯片 / 派活 / 数据流动"三类排布,可单独保存备查。需要细读的,往下看逐条详解。
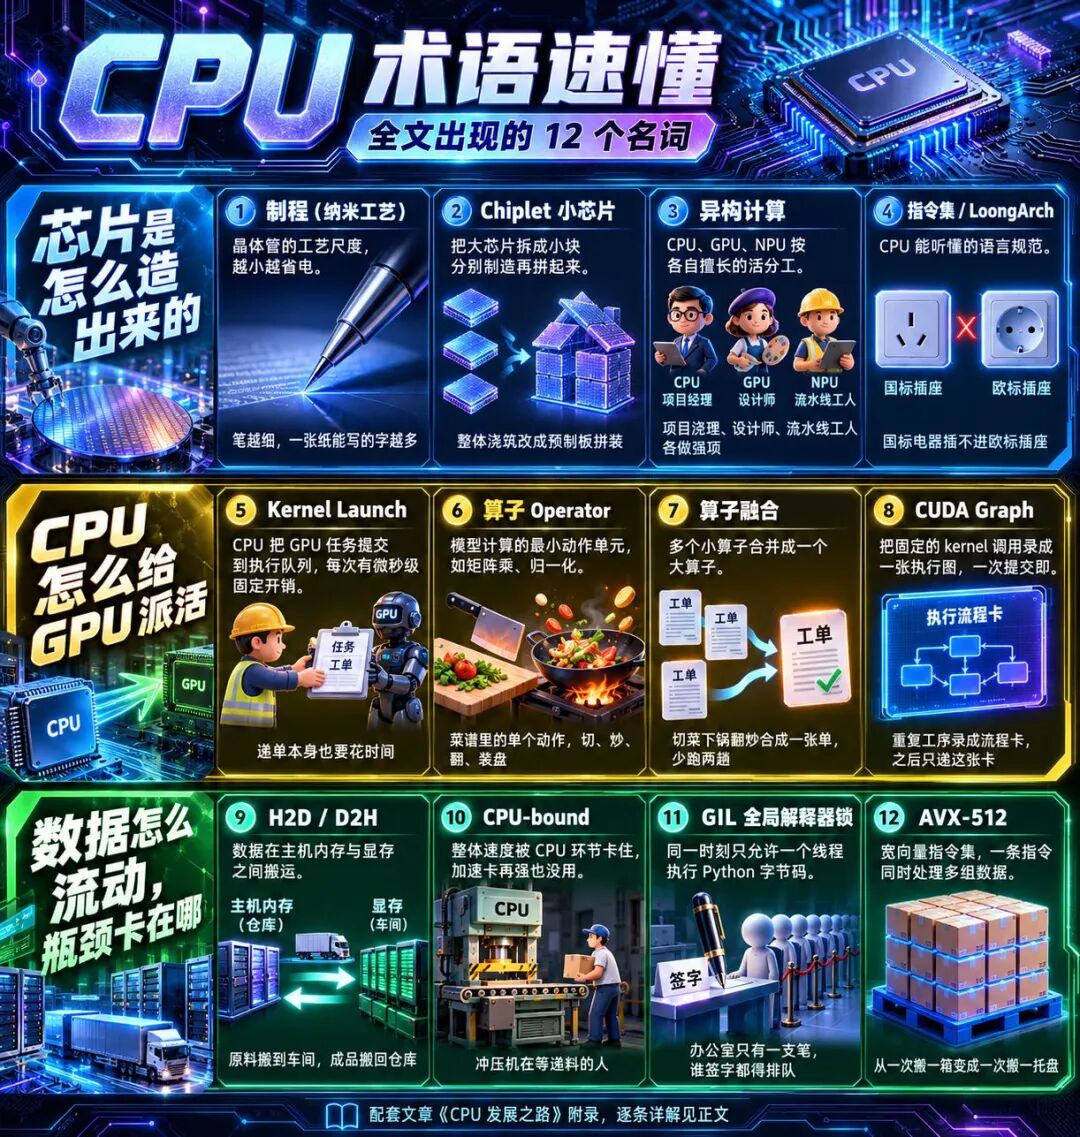
CPU 术语速查卡:12 个名词按三类归纳,每条配一句类比
一、芯片是怎么造出来的
制程(纳米工艺) 芯片上晶体管的工艺尺度,数字越小,同样面积能塞下更多晶体管,也更省电。打个比方:像笔尖的粗细,笔越细,同一张纸上能写的字越多。
Chiplet(小芯片) 把一颗大芯片拆成多个小芯片分别制造,再封装拼接成一颗完整 CPU,良率更高、成本更低。打个比方:盖房子从"整体浇筑"改成"预制板拼装”,一块出问题只换一块。
异构计算 让 CPU、GPU、NPU 等不同类型的计算单元,按各自擅长的活儿分工协作。打个比方:一个团队里有项目经理、设计师和流水线工人,各做各的强项。
指令集 / LoongArch CPU 能听懂的"语言规范"。x86、ARM、LoongArch 各不相同,决定了软件生态能否直接复用。打个比方:插座标准,国标电器插不进欧标插座,要么换设备,要么加转接头。
二、CPU 怎么给 GPU 派活
Kernel Launch CPU 把一段待执行的 GPU 计算任务提交到 GPU 执行队列的动作,每次都有固定开销,典型为微秒级。打个比方:工头给机器递一张工单,递单这个动作本身也要花时间。
算子(Operator) 模型计算的最小动作单元,如矩阵乘、加法、归一化。PyTorch 的算子库 ATen 负责把它们落到具体硬件上。打个比方:菜谱里的单个动作——切、炒、翻、装盘。
算子融合 把多个连续的小算子合并成一个大算子,减少提交次数和中间数据的反复读写。打个比方:把"切菜、下锅、翻炒"三张工单合成一张,少跑两趟。
CUDA Graph 把一整串固定的 kernel 调用录制成一张执行图,之后一次提交即可回放,省掉大量重复的 launch 开销。打个比方:把每天重复的工序录成一张标准流程卡,之后只递这张卡。
三、数据怎么流动,瓶颈卡在哪
H2D / D2H Host to Device / Device to Host,即数据在主机内存与显存之间的搬运。打个比方:把原料从仓库搬到车间,再把成品搬回仓库。
CPU-bound(CPU 受限) 系统整体速度被 CPU 环节卡住的状态,此时加速卡再强也提不上端到端性能。打个比方:高速冲压机停在那里,因为递料的工人跟不上。
GIL(全局解释器锁) CPython 的机制,同一时刻只允许一个线程执行 Python 字节码,限制了多线程并行提交任务的能力。打个比方:办公室只有一支签字笔,谁要签字都得排队等它。
AVX-512 x86 的宽向量指令集,一条指令可同时处理多组数据,对 CPU 侧推理有明显加速。打个比方:从一次搬一箱,变成一次搬一托盘。