写在前面
这篇不是官方博客的中文版。规格、参数、评测数字来自月之暗面的技术博客和 Hugging Face,但怎么看这些数字、哪些重要、哪些是话术。我读新模型有个习惯:先不看那个最显眼的数字,而是翻到 config.json。因为宣传页告诉你"它有多强",配置文件告诉你"它把钱花在了哪"。
这次翻完,我记住的不是 2.8T,也不是 1M 上下文,而是两个数:69 和 24。
一、先说结论:这是一次成本革命,不是架构革命
Kimi K3.1 Pro 的骨架,和上一代 Kimi K3 几乎一样:
- 93 层,896 个专家,每 token 激活 16 个,2 个共享专家;
- Latent MoE 维度 3584,专家隐层 3072;
- 词表 160K,激活函数 SiTU-GLU。
这些一个没动。真正动的只有两处:把 24 层全注意力的 Gated MLA 换成 Gated DSA,以及把后训练算力大幅放大。它更像一个 1.1 版本:解决的问题不是"能不能更强",而是"能不能更便宜地跑完 100 万 token"。回头看这半年的开源旗舰,走的都是同一条路 — 上个月我拆 DeepSeek-V4.1-Flash 时,那篇的核心词也是"成本曲线重写"。两家不约而同,说明能力竞赛的边际收益已经很低了。
当架构创新让位于成本工程,不是技术退步,是这个行业终于开始算账了。
二、2.8T / 104B:这个数字已经不值得惊讶
2.8T 总参数、104B 激活,稀疏比 27:1。放在 2024 年这是头条,放在今天只是"及格线"。因为 MoE 的配方已经公开了:细粒度专家 + 高激活数 + 共享专家兜底 + 潜空间压缩。896 选 16 与 DeepSeek-V3 的 256 选 8 是同一种思路的两种刻度,没有本质区别。
更直白一点:这套架构,谁都能抄。参数不是壁垒。
而且这次连"抄的门槛"都被主动拆掉了。Kimi 团队把 KDA 写成论文公开发表(Kimi Linear, arXiv:2510.26692),kernel 开源进 flash-linear-attention,vLLM 集成和 48B-A3B 的预训练/指令微调 checkpoint 一并放出。
一个连 kernel 都开源的架构,很难再被叫作护城河。
那壁垒是什么?把它的评分拆开看了一遍,发现凡是"需要连续几十步行动、且每步都有外部反馈"的任务,它都特别好;凡是"一次性给出高难度答案"的任务,它都一般。这个能力形状不是架构决定的 - 是训练过程决定的。
三、69:24 - 全文最贵的设计
93 层里,69 层是 KDA(Kimi Delta Attention,线性注意力),24 层是 Gated DSA(Gated DeepSeek Sparse Attention)。
看配置里那个数组更清楚:
dsa_layers = [4, 8, 12, 16, ..., 88, 92, 93]
每 4 层插一层稀疏注意力,最后一层也是。 剩下 69 层全是线性的。
这个比例不是随便定的。它对应一个很具体的成本结构:
- 全注意力在 1M 上下文下是平方级的,KV cache 直接把显存吃穿;
- 线性注意力成本线性,但"精确回忆某个具体位置"的能力天生弱;
- 稀疏注意力只对少数 token 做真注意力,精确但要靠索引器挑得准。
月之暗面的答案是:大部分层做便宜的"理解全局",少数层做昂贵的"精确定位"。
这套配方的出处,是一年前的 Kimi Linear:用 1.4T token 做等条件预训练,把 KDA 与全注意力按 3:1 均匀交替,结果是 KV cache 最高降 75%、1M 上下文下解码吞吐最高提升 6 倍(TPOT 从 11.48ms 降到 1.84ms)。K3.1 Pro 只是把这套配方里的"全注意力"从 MLA 换成了 Gated DSA。
所以我的解读是 - 这不叫能力设计,这叫成本设计。
论文标题里 “outperforms full attention” 容易被读成"能力更强",但真正的信息在配套指标里:省 75% 的 KV、快 6 倍的解码。能力只是进场资格,省下来的钱才是成果。
如果目标只是 128K 上下文,根本不需要搞这么复杂的混合;只有在 1M 这个量级上,3:1 的账才算得过来。
这个设计的代价 — 我原先的判断,被论文打了一半的脸
我本来想说:混合注意力 = 两套 kernel = 两条推理路径,vLLM、SGLang 都得跟着改,成本是从 GPU 转嫁给了工程团队。
查完 Kimi Linear 的仓库,这个说法得改一半。作者显然知道这个坑,而且做得很克制:KDA kernel 开源进 flash-linear-attention,vLLM 集成同步放出,论文里还明确写了 “drop-in compatible with existing full-attention pipelines, requiring no modification to caching or scheduling interfaces"。
这不是把债甩给社区,而是先把还款方案备好再发模型。
但另一半我保留意见:K3.1 Pro 的 24 层不是普通 MLA,而是 Gated DSA — 它自己还要跑一个稀疏索引器。也就是说,同一个 forward 里同时存在 KDA 的循环状态、MLA 的 KV 潜空间、DSA 的索引结构,三种状态要一起做显存规划。论文那句"无需改调度接口"是针对 KDA:MLA 说的,能不能原样迁移到 KDA:DSA,得看引擎侧的实际适配。
准确的说法是:成本确实往工程侧挪了,但这次是主动摊薄过的。
四、top-k 2048:1M 上下文的真相
DSA 的索引器参数很朴素:32 个头、每头 128 维、top-k 2048。
意思是:面对 1M token 的上下文,每次只挑出最相关的 2048 个做真正的注意力计算。
2048 / 1,048,576 ≈ 0.2%。
很多人把这条读成"效率优化”。
模型自己认为,绝大多数 token 是背景噪音。
这句话对做应用的人很重要。标称上下文和有效上下文,从来是两回事。 做长文的人都有体感:塞进去 50 万字,模型真正用上的可能只有开头和结尾那几段。
这不是体感,学界已经把这件事量化了(下一节说)。所以我不会把"1M"当成"可以偷懒不做检索"的理由。它的真正价值在另一处:
它把一次外部 RAG 链路,内化成了模型内部的一次检索。
不用切块、不用建向量库、不用 rerank、不用把召回结果拼进 prompt — 这中间省掉的工程复杂度和失败模式,往往比省下的 token 更值钱。
但"内化 = 更好"这个推论值得推敲,MBZUAI 团队做了一组很实在的实验(《When Context Overwhelms》):用同一个 1M 上下文模型(K2-Think-v2),在 120 组配置、7160+ 次评测里对比三种给知识的方式 — 长上下文(LC)、RAG、混合(Hybrid):
- NarrativeQA(叙事理解):Hybrid 0.0497 ≈ LC 0.0481,RAG 只有 0.0351。切块检索破坏了全局连贯性;
- HotpotQA(多跳问答):RAG 的幻觉率反而更低(10.3% vs LC 的 12.3%),但准确率没有提高;
- MultiDoc2Dial(多文档对话):三种架构幻觉率都在 20–33%,且与噪音比例没有单调关系。
结论:策略好坏是任务相关的,不存在"长上下文全面替代 RAG"。 1M 的价值不是"干掉检索",而是让你能按任务挑策略。叙事型任务直接塞进去;多跳问答保留检索链路反而更稳。
建议评测口径
现在评估长上下文,主流还是 needle-in-a-haystack(大海捞针)。我一直觉得这个指标没什么用 — 它考的是"能不能找到那根针",而不是"能不能用 100 根针做推理"。
NeurIPS 2026 那篇 《Context Windows Are Not Context Capacity》 直接把矛盾量化了:
- 把"能接受 1M token"和"能可靠使用 1M token"分开,用留存曲线(retention profile)取代单一窗口数字;
- 在 RULER 的 33 个模型上,标称上下文长度与留存能力只有中等相关(ρ = 0.437);
- “several large-window models retain substantially less capability than shorter-window peers” — 窗口大的,实际留存反而不如窗口小的;
- 上下文容量强任务相关:同样 5 个模型、同样 4K–32K 区间,RULER 与 NoLiMa 测出的留存分差 0.187–0.496。
他们主张厂商公布的是"上下文留存"(曲线 + 基线 + 半衰期 + 最大局部跌落),而不是一个孤零零的 “1M”。
我完全同意,并且想再加一条自己的:报多跳命中率。这也是我判断这颗模型"1M 能不能用"的唯一标准。
(如果你也在做长上下文,可以先看我之前那两篇 KV Cache 拆解,缓存怎么涨、涨在哪,比模型更能解释成本。)
五、MXFP4:没有它,这颗模型发不出来
模型里最不起眼、但最关键的一行是量化:
MXFP4 权重 / MXFP8 激活,量化感知训练(QAT),分组大小 32。
每 32 个权重共享一个缩放系数,权重压到 4 bit。这不是事后拿 GPTQ 压出来的,是训练时就知道自己要跑 4bit。
为什么必须这样?算笔账:
| 精度 | 2.8T 权重的体积 |
|---|---|
| FP16 / BF16 | 约 5.6 TB |
| MXFP4(4 bit) | 约 1.56 TB(实测 96 个分片、1.56 TB) |
5.6TB 意味着什么?意味着几乎没有团队能自己部署,等于"发了个用不了的开源模型"。
1.56TB 依然不是小数目 — 一台 8×80GB 的机器只有 640GB 显存,塞不下;96 个分片每个约 16.3GB,注定是多机张量并行 + 专家并行的活。
但至少,它是"云厂商能经济地跑起来"的量级。这不是它一家的选择。OpenAI 的 gpt-oss 模型卡里写着几乎同样的话:
The models were post-trained with MXFP4 quantization of the MoE weights, making
gpt-oss-120brun on a single 80GB GPU… All evals were performed with the same MXFP4 quantization.
注意最后半句:评测是在量化后的模型上跑的,不是拿 BF16 跑完分、再顺手压个 4bit 发布。这个口径很重要 — 它决定了你部署出来的东西,和榜上那个分数是不是同一个东西。
所以我的判断是:QAT 4bit 已经不是优化项,而是千亿参数以上模型发布的前置条件。 以后拿不到 4bit 权重的"开源模型",基本可以不看了。
实战提醒:想微调的话,这里有个坑
4bit 权重对推理友好,对微调相当别扭。
- 走 QLoRA:要处理 MXFP4 的分组缩放,现有工具链支持还不完善;
- 反量化回 BF16 再训:体积立刻回到 5.6TB,普通团队直接出局。
所以**“能推理"和"能微调"是两件不同的事**。如果你是冲着"拿开源权重做领域微调"来的,先确认你的工具链吃不吃得下 MXFP4。
(量化这块我之前写过上下两篇,从这里开始,包括为什么 4bit 掉点、什么时候不该压。)
六、后训练:我最看重的一节
如果整篇只能留一段,我留这段。官方对 K3.1 Pro 的定义只有一句话值得圈:
K3.1 Pro is a post-trained version of Kimi K3, with substantially larger post-training compute.
架构基本没动,动的是后训练。
这句话背后是过去两年最重要的一次转移:base model 的能力曲线越来越平,真正拉开差距的是"怎么把一个基座调成会干活的 agent”。
他们做的是"工业流水线",不是"一次炼丹"
官方说,为了在数百个下游域上做联合 RL,他们重做了整条栈:RL 框架、长上下文推理、训练效率、沙箱基础设施、rollout 调度、环境质量检查平台。
我特别在意其中一句话:
让每一份 RL 算力都带来稳定、可预测的回报。
注意,不是"更高回报",是"可预测"。
这是工程语言,不是营销语言。它意味着他们给 RL 建了 SLO — 跑一万卡时的训练,收益方差是可接受范围内。
为什么要强调这个?因为同时跑几百个域的 RL,最大的敌人不是收敛慢,是互相踩踏:几个域涨、其余域崩,你连调参方向都没有。
最容易被忽略的一环:环境质量
六件事里,最后一条"环境质量检查平台"最不起眼,但我认为它最被低估。
RL 的上限由环境决定。任务有歧义、判分器有 bug,模型学到的就是怎么骗过判分器 — 这不是模型坏,是你在奖励错误的行为。
把这个检查做成共享平台,等于把"每个团队各自踩坑"变成"全公司统一治理"。
2026 年初那篇 《Endless Terminals》 开篇第一句就是:
Environments are the bottleneck for self-improving agents.
他们的做法很朴素:用全自动流水线造了 3255 个终端任务,然后只用最基础的 PPO + 二值奖励 — 没有检索、没有多智能体、没有专用工具。结果 Qwen2.5-7B 从 10.7% 涨到 53.3%,Qwen3-8B 从 42.6% 涨到 59.0%,迁移到 TerminalBench 2.0 也全是正收益,还打赢了用更复杂 agent scaffold 的方案。
那篇的结论就一句:simple RL succeeds when environments scale.
不过这里要再修正一层。微软的 WildAWM 给了个反证:环境是可以被合成出来的。他们用开源模型自动生成了 341 个长程环境任务(GPT-6-Astra 也只能解 60%),靠的是"执行式质量闸门" - 跨判分器一致性检查、对判分结果做反事实探测。
所以准确的说法是:环境本身不再稀缺,能合成;真正稀缺的是"把环境调到可验证、可判分、难度可控"的那套流程。
我的判断:未来一年,开源模型的差距会由这套流程决定,而不是由 GPU 数量决定。 这也解释了为什么 K3.1 Pro 要把"环境质量检查平台"单列进六件基础设施之一 - 它防的不是没数据,是判分器把模型带歪。
数据也支持这个判断。看内部对比:
| 内部评测 | K3 | K3.1 Pro | 变化 |
|---|---|---|---|
| 金融建模 | 50.4 | 57.6 | +7.2 |
| 金融研究 | 58.8 | 70.4 | +11.6 |
| 业务运营 | 8.9 | 37.8 | 约 4.2 倍 |
业务运营从 8.9 涨到 37.8,是这三行里最有信息量的。
业务运营考的是"在模拟商业环境里做长程决策",本质是 agent 的连续行动能力。这个维度过去是所有模型的洼地 - 因为难做评测、难造环境。它涨了 4 倍,说明环境造对了,能力就长出来了。
七、Benchmark:我只信三行
官方主图列了 14 项,表格里 30 多项。
我的读法是:主图看趋势,表尾看形状。
主图告诉你"它能打";表尾那些不好看的行,才告诉你"它是哪种选手"。
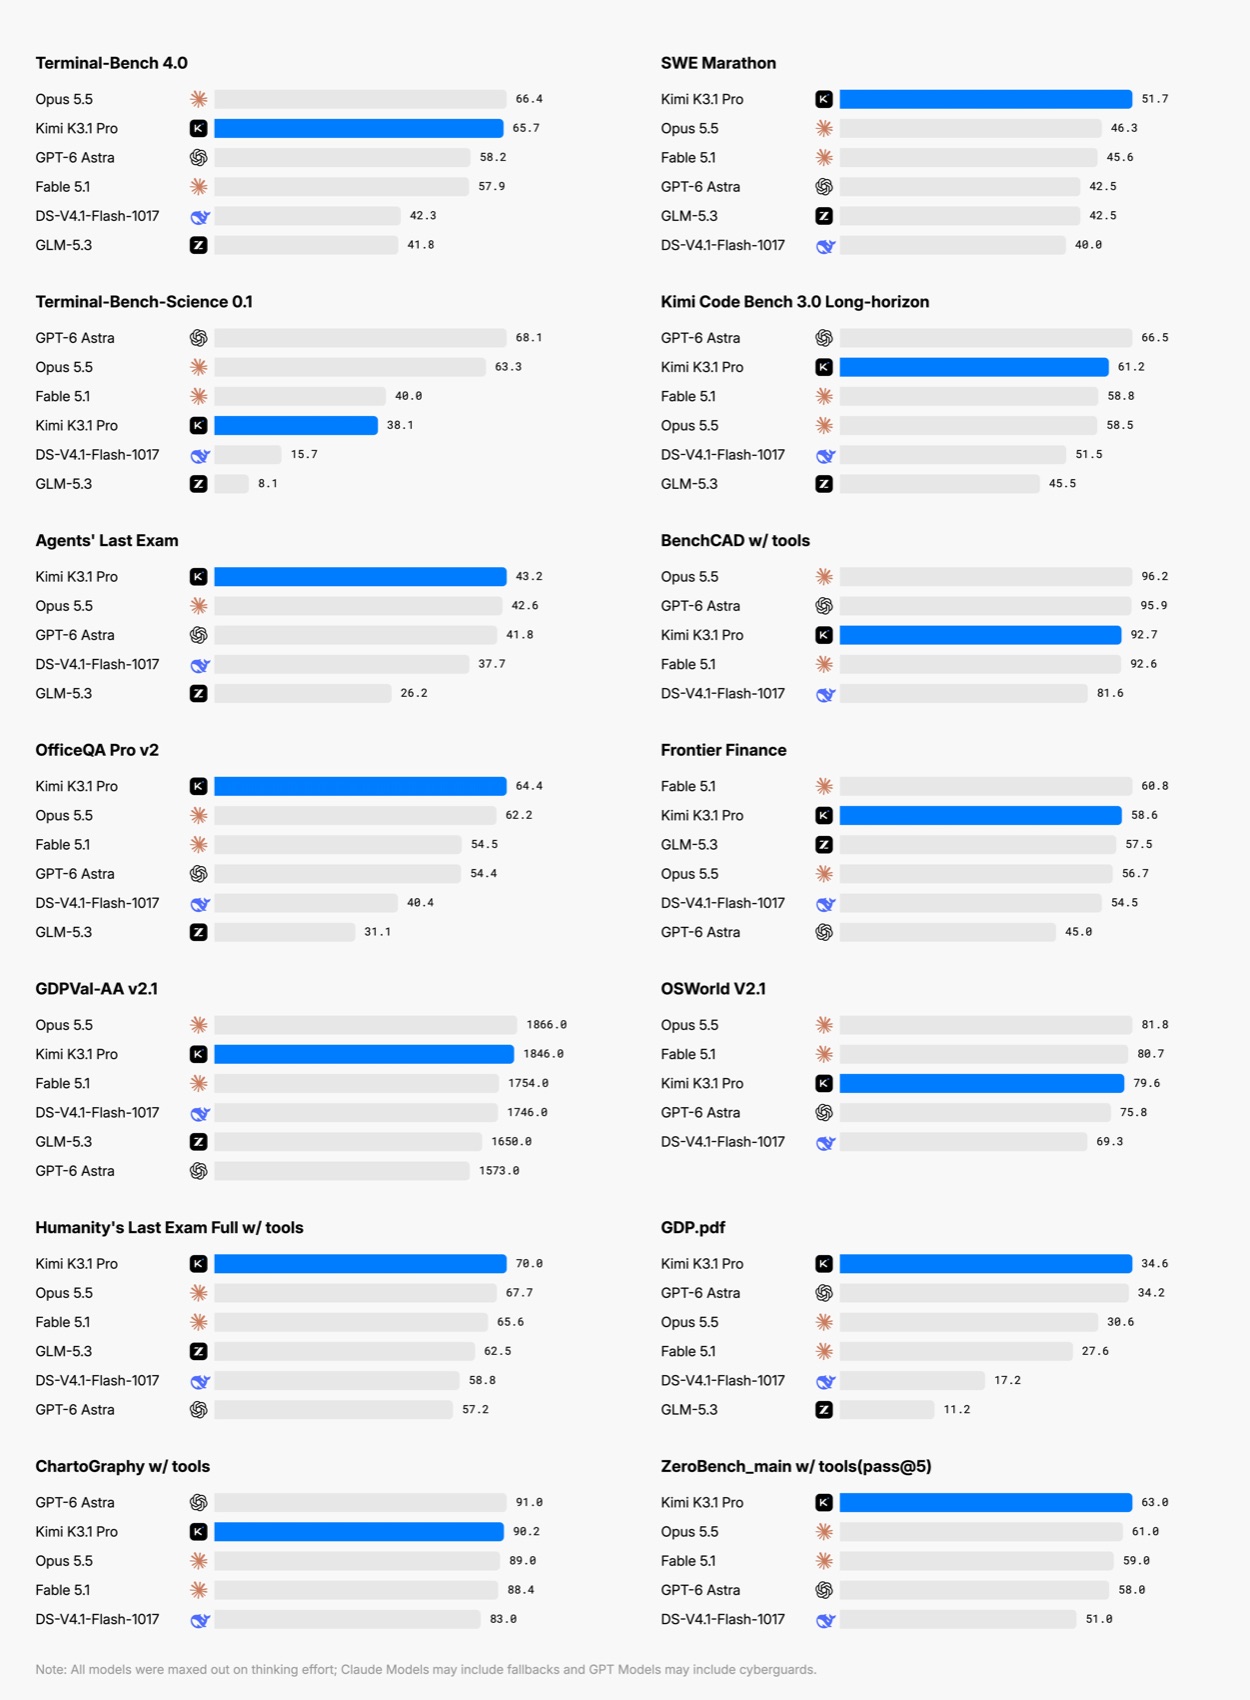
我只挑三行,因为它们分属三种完全不同的能力:
第一行:ProgramBench,31.5(Opus 5.5 是 65.0)。
这个 benchmark 要求从零生成可运行程序。它考的是一次成型能力。
差一倍,说明它不擅长凭空写出干净的第一版,擅长的是在已有代码上迭代 - 方向刚好相反。
第二行:Terminal-Bench-Science,38.1(GPT-6 Astra 68.1)。
差 30 分,是全表最大的鸿沟。它考的是复现实验、处理科学数据格式、按论文流程推进。
这行直接定义了它的身份:工程型选手,不是科研型选手。
第三行:HLE-Diamond,39.4(GPT-6 Astra 65.8)。
没有工具兜底、纯靠内部知识解超难问题。这一行的落差说明:它带工具能考 70.0(该项第一),不带工具就掉到 51.1 - 它的"聪明"有相当一部分是"会用工具",不是"知道得更多"。
我最喜欢的一组对照
不是哪个"第一",是这组:
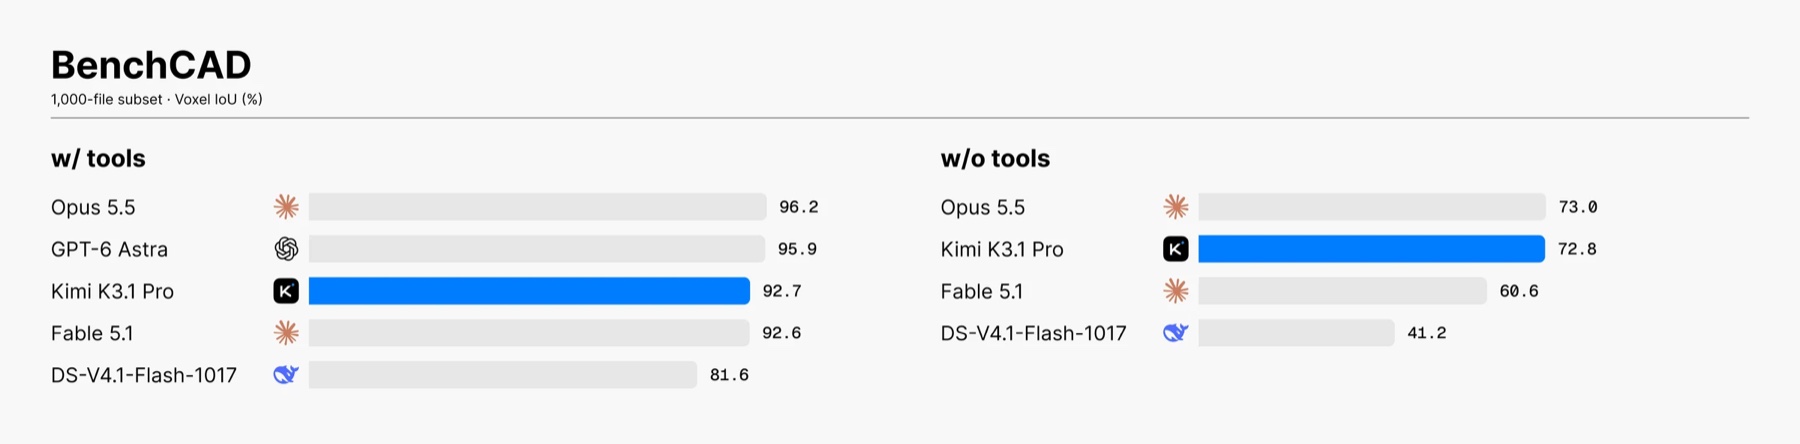
| 条件 | K3.1 Pro | Opus 5.5 | 差值 |
|---|---|---|---|
| 带工具 | 92.7 | 96.2 | -3.5 |
| 不带工具 | 72.8 | 73.0 | -0.2 |
不带工具时,它和 Opus 5.5 只差 0.2 分 - 基本打平。带工具却差 3.5 分。
这组数字把"模型能力"和"工具链能力"干净地分开了:脑子已经追平,差的是手。
对使用者的启发很直接:如果你做 3D 生成,它的"脑力"够用,你要自己补的是 CAD 工具链、脚本执行、渲染校验这一圈。这也意味着这里存在工程红利 - 同样的模型,谁的 harness 做得好,谁就能多拿那几个点。
顺便说一个我一直想吐槽的点
现在厂商发模型,主图基本都是"带工具、max effort、最好 harness"下的成绩。
我建议以后要求同时公布"去工具基线"。 否则我们看到的永远是 harness 竞赛,不是模型竞赛。
这次 K3.1 Pro 同时给了带/不带工具的数字,这一点值得表扬 - 它让上面那个 0.2 分的结论成为可能。
完整一点的能力形状
| 评测项 | K3.1 Pro | 最强对手 | 我的判断 |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4(Opus) | 贴身,就差半步 |
| SWE Marathon v1.1 | 51.7 | 46.3(Opus) | 长程工程的强项 |
| DeepSWE v1.1 | 75.5 | 77.0(DeepSeek) | 第一梯队并跑 |
| ProgramBench | 31.5 | 65.0(Opus) | 硬伤:从零生成弱 |
| BenchCAD w/o tools | 72.8 | 73.0(Opus) | 空间推理已追平 |
| OfficeQA Pro v2 | 64.4 | 62.2(Opus) | 金融文档第一 |
| BrowseComp | 92.1 | 91.5(GPT-6) | 搜索型 agent 第一 |
| HLE-Full w/ tools | 70.0 | 67.7(Opus) | 带工具解题第一 |
| Terminal-Bench-Science | 38.1 | 68.1(GPT-6) | 硬伤:科研深度弱 |
| HLE-Diamond | 39.4 | 65.8(GPT-6) | 硬伤:无工具难题弱 |
| GPQA-Diamond | 94.2 | 96.1(GPT-6) | 结构化知识不缺 |
三行硬伤指向同一件事:它的强,建立在"有工具、有反馈、能迭代"的前提上。 前提一旦撤掉,差距就出来了。
还有两个数字,比排名更值得看
第一个是幻觉率。
在自研的 Kimi Hallu Bench 的 Hard 档、带工具条件下,它的 claim 级幻觉率是 8.3%,上一代 K3 是 23.4%,Opus 5.5 是 15.0%,GPT-6 Astra 是 5.5%。
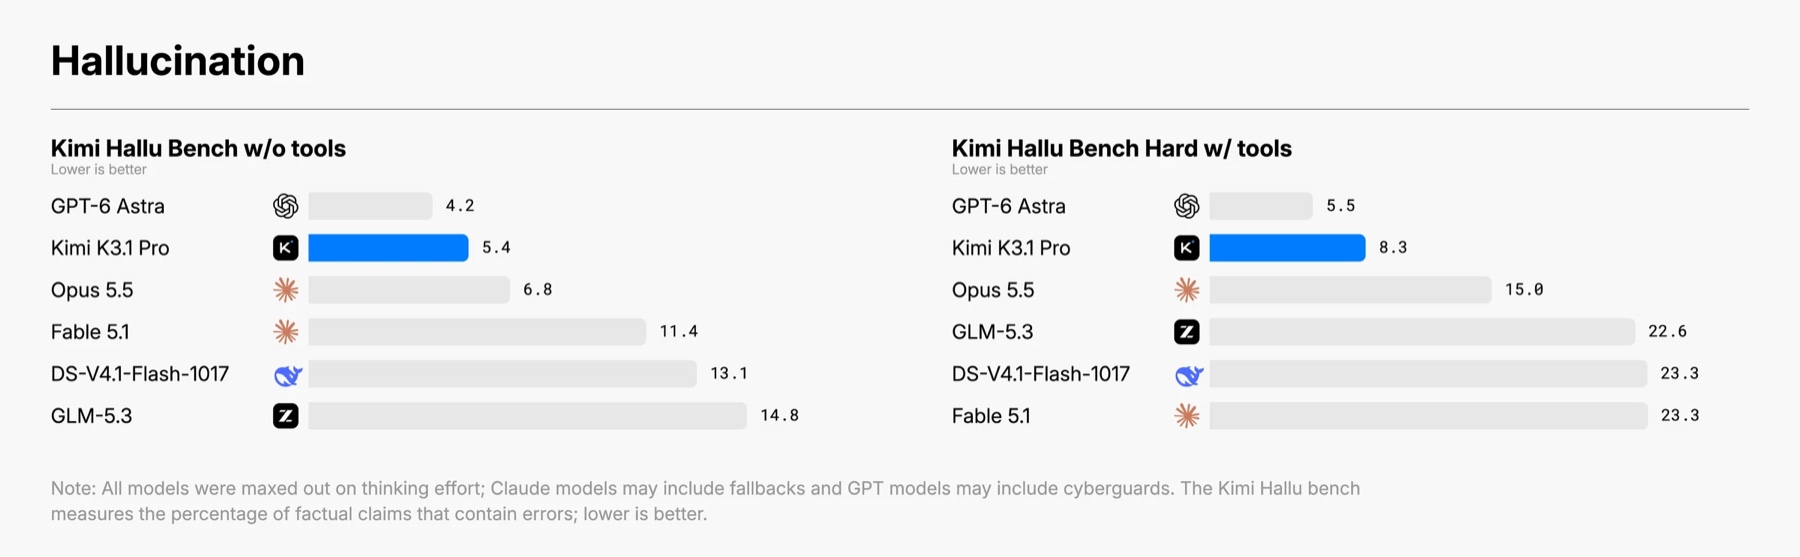
我的判断:对金融、法务、医疗这类场景,这一个数字比十个编码分数都重要。
但引用时请务必带上官方那句限定 - 这个 benchmark 是压力测试:样本是刻意挑的"模型容易犯错"的场景,8.3% 不代表日常错误率。这句话经常在传播中被裁掉。
第二个是金融文档。
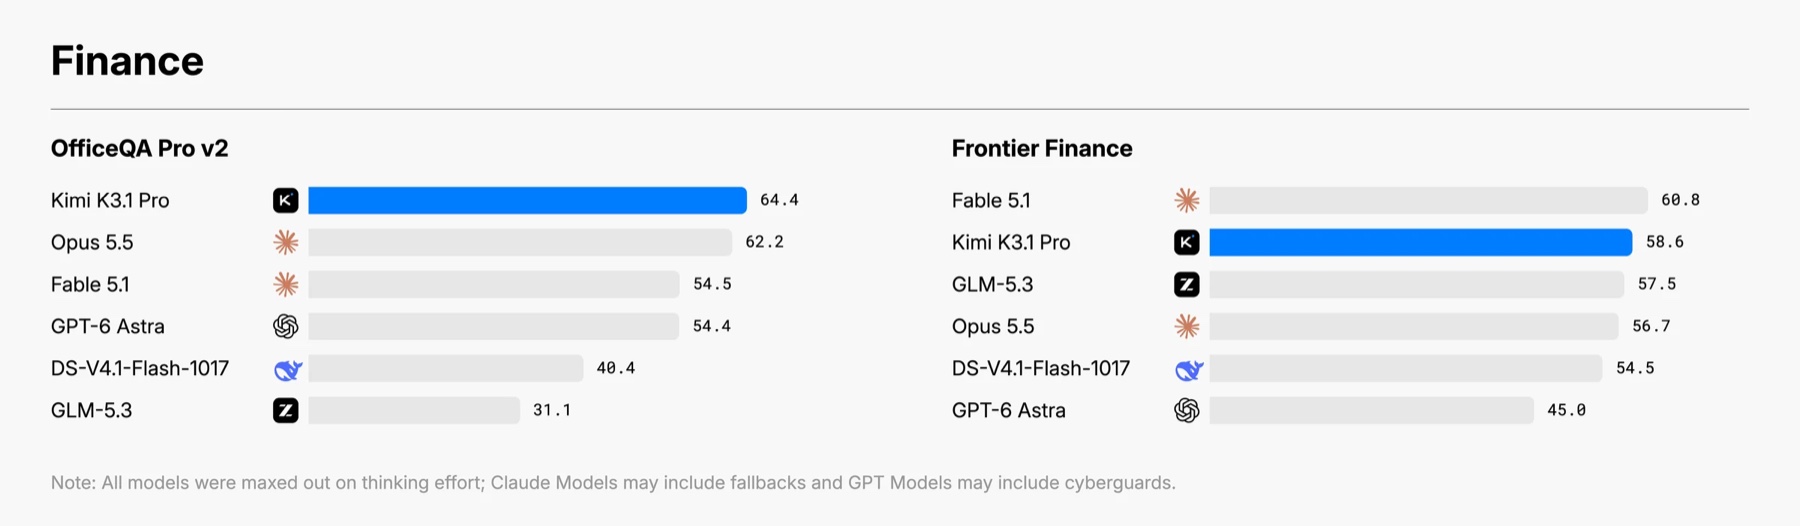
OfficeQA Pro v2 拿到 64.4,第一(Opus 5.5 62.2)。这个 benchmark 的题面很有意思:给一个完整的 PDF 语料库,全部渲染成图片、不提供任何机器可读文本,要求跨文档检索、核对、多步数值推理。
我一眼就懂了它为什么强 - 这根本不是"读文档",这是一个 agent 任务:先检索、再定位、再核对、再计算,每一步都有中间结果可以验证、可以回退。
同一个"长程 + 反馈"的强项,在这里又出现了一次。这也印证了前面的判断:它的能力形状是"过程型"的,不是"一次成型"的。
八、安全那节:想鼓掌,也想挑刺
开源模型卡里专门写一节网络安全治理,这在过去是没有的。我认真读了两遍。
先鼓掌
他们做了三件事,我认为都对:
- 承认问题:后训练规模上去后,漏洞研究能力在涨;
- 定位来源:预训练语料 + RL 环境,两处;
- 做了对照实验:不删数据是 90.5,删了是 81.0 - 主动放弃 9.5 分。
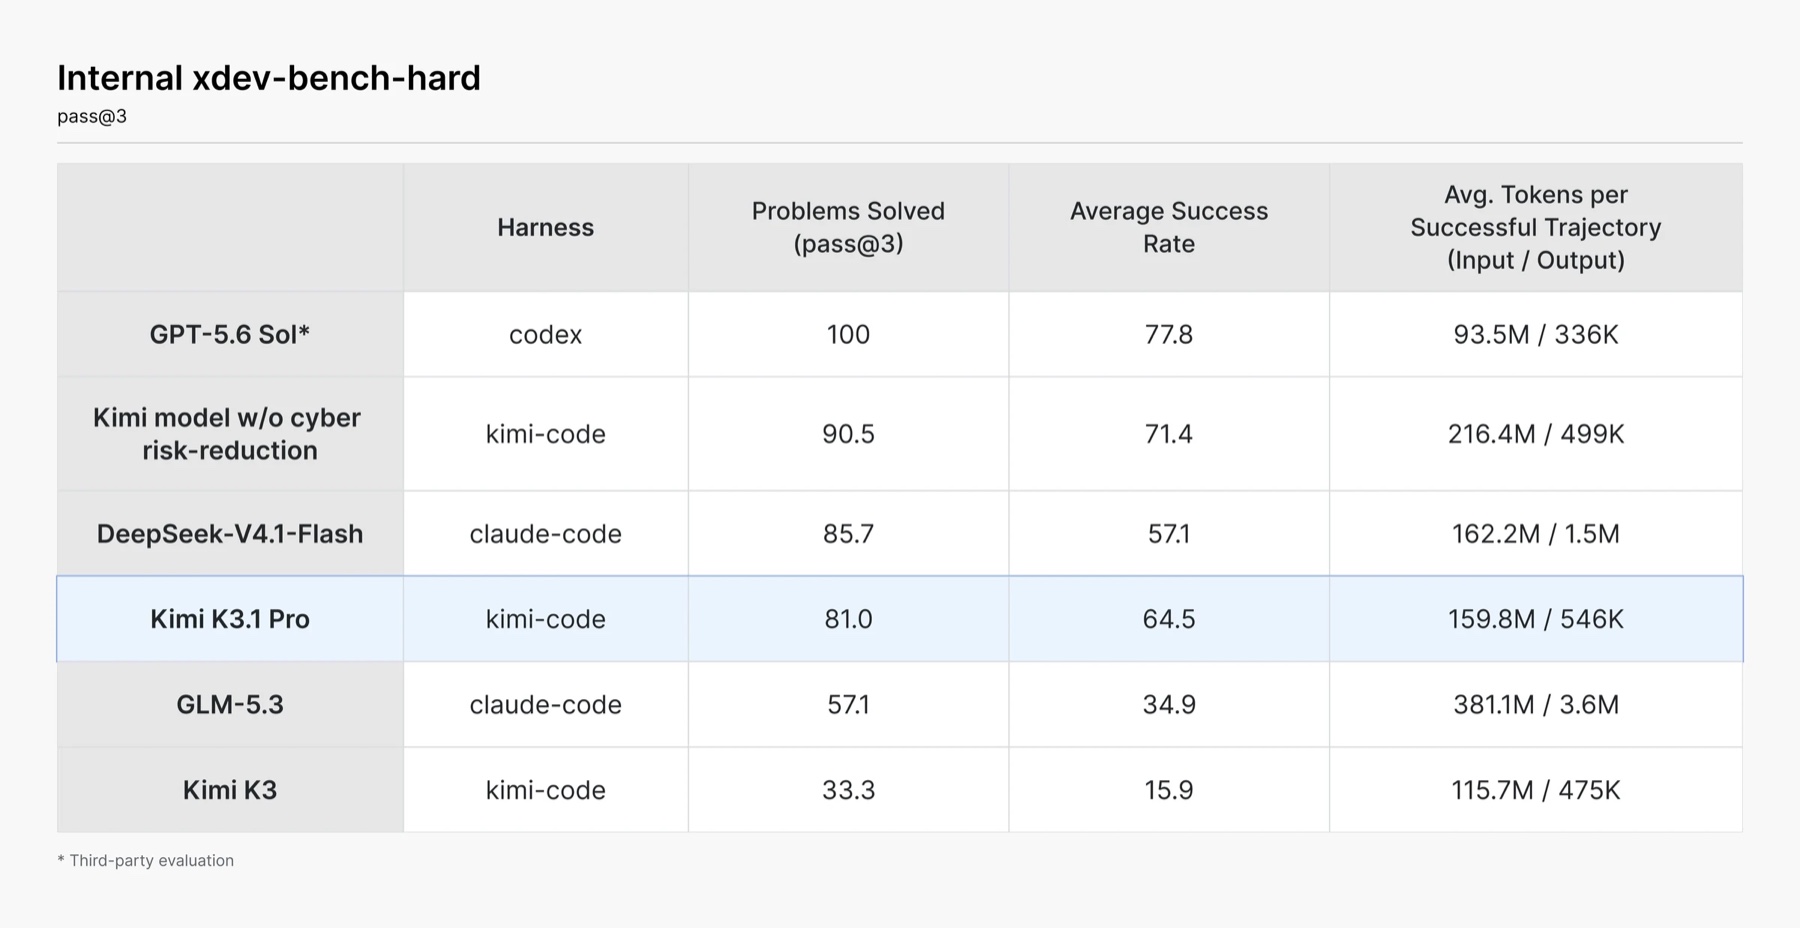
“主动降 9.5 分"这句话,比任何"负责任的 AI"声明都有分量。因为它可测量。
而且第二条读数很反直觉:即便删掉了网安数据,K3.1 Pro 仍有 81.0,是前代 K3(33.3)的 2.4 倍。
这说明强编码能力会自然溢出成攻击能力。你没法靠删数据把这条路堵死。
这条结论对所有做开源模型的团队都成立,不只是月之暗面。
然后挑刺
三个我不满意的地方:
第一,benchmark 是内部的,外部无法复现。
xdev-bench-hard 是他们自己的题集。这意味着"90.5 → 81.0"这个对比,只能由他们自己验证。作为外部读者,我们只能选择相信。
第二,“落后闭源三个月以上"这句话没有数据支撑。
这是很关键的一句定性,但没有给出任何可比数字。
第三,把"削减能力"当成结论,其实回避了一个问题:
如果 81.0 已经高于所有开源同行,那"不把开源推到前沿"这条原则,究竟是安全考量,还是商业节奏?这个问题应该被问出来。
我的立场:开源安全要变成"第三方可复现的评测"才有约束力。 自己出题、自己考试、自己判卷,方向上是对的,力度上还不够。
这个判断在学术界已经有名字了。ICML 2026 那篇 《Safety Washing》 造了个词,直接对标环保领域的 “greenwashing”:
用现有的评测基础设施,系统性地高估了 LLM 的安全水平。
他们列了五条机制、做了 Safety Washing Index 审计量表,并明确建议:引入第三方审计、强制模型披露、落地监管标准。
也就是说,“厂商自己报告能力被削减了多少"这件事,在方法论上已经被标记为不够。K3.1 Pro 迈出了第一步,但要走完,得有外部的人来复现。
不过话说回来,把方法论和失败数据一起写出来,已经是这轮发布里最超预期的一节。它把"开源是否安全"这个话题,变成了一个可以复现的实验 - 哪怕实验是他家实验室做的。
九、如果我要用它:三条实用建议
不谈"它能做什么”,谈"我会怎么用”。
1. 按能力形状分工,别按排名选
- 该用:长程 coding agent、3D/CAD 生成、金融文档分析、需要多步工具调用的自动化。这些都是"有反馈、能迭代"的场景,正好在它的强项区。
- 别用:从零生成完整程序(ProgramBench 31.5)、科研级复现(38.1)、无工具的硬核知识问答(HLE-Diamond 39.4)。
2. 部署前先算显存,别被"开源"两个字骗了
1.56TB 权重,8×80GB(640GB)装不下,必须多机。这不是"下载就能跑"的模型,是"云厂商级"的模型。
如果是交互场景,先看 Highspeed 版(2—3 倍速)。官方没公布它在评测上和标准版的差异,重活还是用标准版。
3. 三个必踩的坑,提前避开
坑一:reasoning_effort 默认是 max。
官方所有评测都在 max 下跑。这意味着你按默认调用,拿到的是"最强但最慢、最贵"那一档。做延迟敏感的产品,先降到 high 试。
坑二:多轮对话必须回传完整的 assistant 消息。
包括 reasoning_content 和 tool_calls,只传 content 会掉能力。这是 thinking 模型的通病,但很多 SDK 封装默认会把这俩字段丢掉。自己写一层 wrapper 兜住。
坑三:许可证有两条阈值。
主体接近 MIT(可商用、可改、可分发、可卖),但:
- 做"模型即服务"且连续 12 个月收入超 2000 万美元 → 需单独签约;
- 产品月活超 1 亿或月收入超 2000 万美元 → 界面必须显著标注 “Kimi K3.1-Pro”。
写在最后
如果只留一句话:
模型真正的信息量,不在它考了多少分,而在它把"1M 上下文"从一句营销话术,拆成了一笔可以算的账。
69 层便宜的、24 层昂贵的、896 个专家只开 16 个、权重压到 4bit - 每一个选择都在回答同一个问题:怎么让 100 万 token 的推理成本,落进云厂商的毛利里。
架构上它没什么惊喜,我也不觉得这是缺点。当一个领域开始认真算成本,说明它已经过了炫技阶段。
最后留两个我还没答案的问题,也许下一篇接着写:
- Kimi Linear 给出的 6.3× TPOT 收益,是在 48B-A3B 上测的。同样的 3:1 比例放大到 2.8T,收益还成不成立?
- 当"环境与判分器"成为主要变量,开源模型的评测会不会退化成"谁的判分器更狠"的军备竞赛?
附录:术语速查
| 术语 | 一句话解释 |
|---|---|
| KDA | Kimi Delta Attention,线性注意力,成本随长度线性增长,擅长全局摘要 |
| DSA | DeepSeek Sparse Attention,先用轻量索引器挑少量 token,再做精确注意力 |
| MLA | Multi-head Latent Attention,把 KV 压到低秩潜空间;K3.1 Pro 在 DSA 层里仍沿用它 |
| Latent MoE | 先把 token 表示压到 3584 维潜空间,再路由给专家,省显存也省通信 |
| 共享专家 | 不受路由影响、对每个 token 都生效的专家,用来兜底通用能力 |
| MXFP4 | 4 比特浮点、每 32 个权重共享一个缩放系数 |
| QAT | 量化感知训练,训练时就模拟低精度,比事后量化掉点更少 |
| harness | 套在模型外面的执行框架,负责调工具、跑代码、判分 |
数据来源与口径
- 架构参数:Hugging Face 模型卡
config.json、README.md(权重 96 分片、合计约 1.56TB,取自 Hub 元数据); - 评测数字:官方技术博客与模型卡,除特别注明外均为厂商自测;Claude 系列带 fallback、GPT 系列带 cyberguard,横向比较时请自行打折;
- 本文所有"我认为/我的判断"均为个人观点,不代表任何机构;但支撑这些判断的外部研究列在下面,欢迎按图索骥去核对;
- 图表版权归 Moonshot AI 所有。
参考资料
模型与架构
- Kimi K3.1 Pro Tech Blog、Hugging Face 模型卡
- Kimi Team, Kimi Linear: An Expressive, Efficient Attention Architecture, arXiv:2510.26692 - 3:1 混合比例、KDA、75% KV 降幅与 6.3× TPOT 均出自此文
- KDA kernel 开源实现(flash-linear-attention)
- OpenAI, gpt-oss-120b 模型卡 - MXFP4 后训练与"评测在量化模型上跑"的口径
长上下文
- Krishna Harish, Ishant Ghimiray, Context Windows Are Not Context Capacity: Retention Profiles for Long-Context Foundation Models, NeurIPS 2026 Long-Context Workshop - ρ=0.437、任务相关性与"上下文留存卡”
- When Context Overwhelms: A Study of Long-Context vs. Retrieval-Based QA Under Noise, Cambridge Open Engage - LC / RAG / Hybrid 的 120 组配置对照
训练环境
- K. Gandhi et al., Endless Terminals: Scaling RL Environments for Terminal Agents, arXiv:2601.16443 - “Environments are the bottleneck”
- Z. Wang et al., Agent World Model in the Wild: Computer-Use Agent Environment Synthesis, arXiv:2610.26828 - 合成环境与执行式质量闸门
评测与安全
- S. Goyal, Safety Washing: A Framework for Identifying Superficial Alignment in Large Language Models, ICML 2026 - 评测基础设施对安全水平的系统性高估