写在前面
大模型的能力边界由模型本身划定,但一个 token 卖多少钱,由推理系统决定。
DeepSeek V4.1 Flash 这次公开了两个很有分量的数字:单一集群服务吞吐 155 万亿 tokens/天,整体收入 每卡每小时 38 美金(按谷价)。前者是规模,后者是单位经济性。把这两个数字放在一起,才能看出这套系统真正在解的问题:
不是「模型能不能答」,而是「同样的卡,能不能以更低的成本服务更多请求」。
为此,V4.1 Flash 的推理系统立了三个目标:
- 兼容多种厂商芯片:NVIDIA 与昇腾都能跑,且尽量跑满;
- 按阶段组织硬件:常见的 8 卡机做 Prefill,64~128 卡超节点做 Decode;
- KVCache 保留 72 小时以上:用更长的复用窗口吃掉重复 Prefill。
这三个目标听起来像架构口号,但落到工程上,每一个都对应一条具体的降本主线。本文想做的,不是复述一遍官方 Blog,而是把系统拆开,回答三个问题:
- 每个设计在省什么?
- 它付出了什么代价?
- 如果自己要在集群里复刻,哪些数字可以拿来对标?
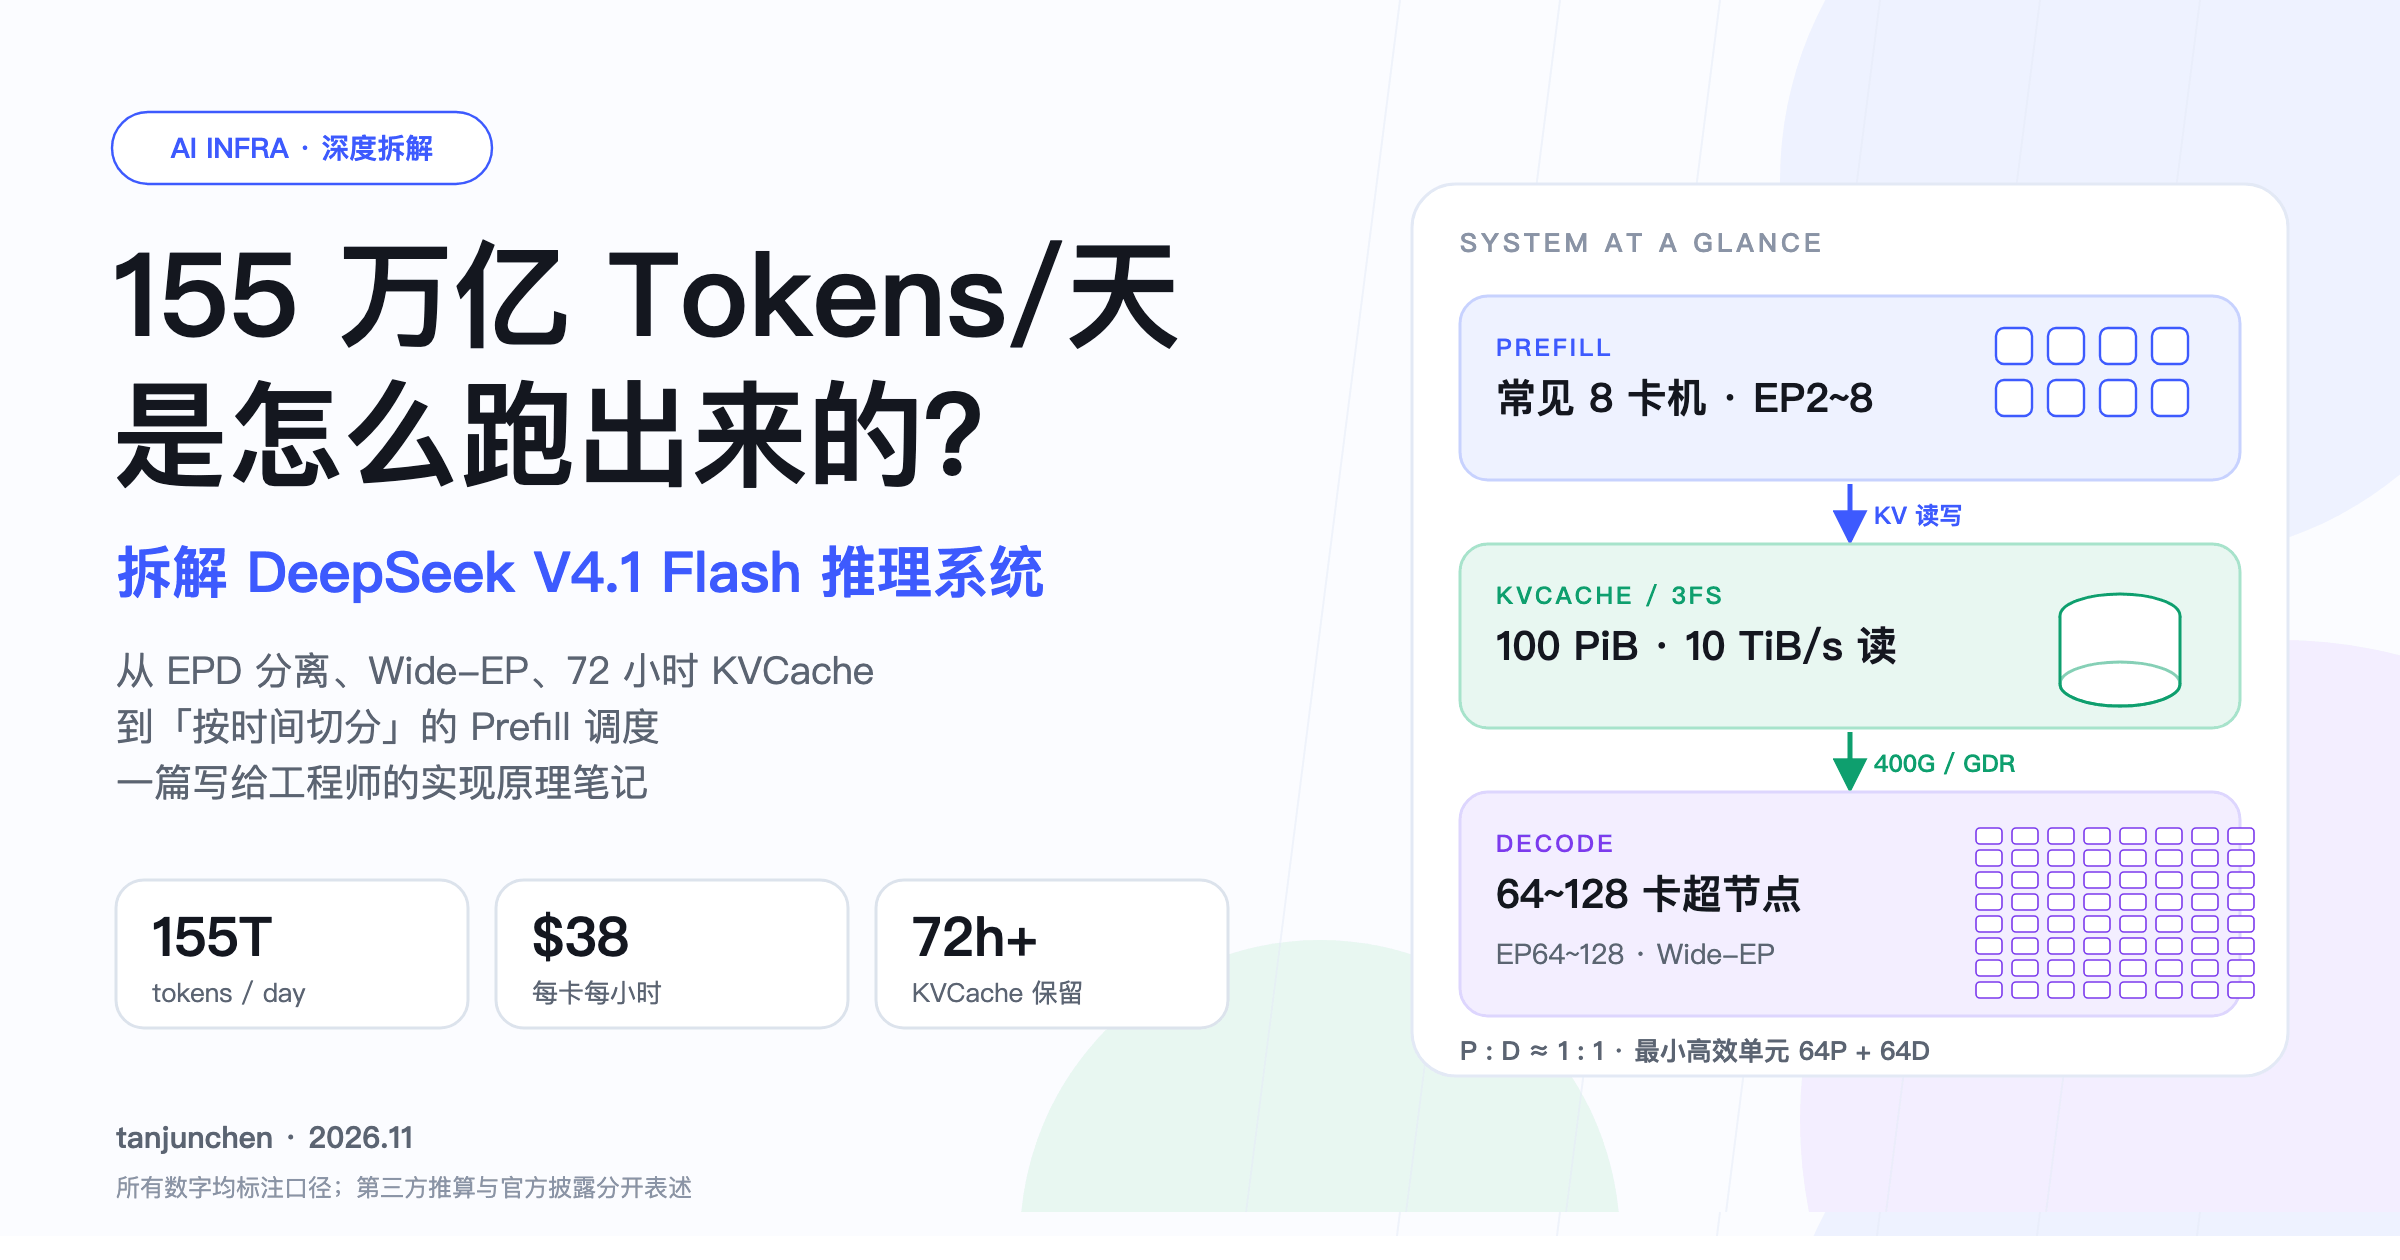
口径说明:本文技术细节主要来自 DeepSeek 官方 Blog 与配套 Q&A;
155 万亿 tokens/天、$38/卡·时、集群规模、成本与毛利等属于官方披露或第三方推算,文中会逐处标注。
先看结论:六句话
| 问题 | 一句话结论 |
|---|---|
| 系统形态 | E/P/D 分离 + 独立 3FS;VE 单卡、Prefill 用 8 卡机、Decode 用 64~128 卡超节点 |
| 并行策略 | Prefill 小 EP(2~8),Decode Wide-EP(64~128);暂不用 TP/CP |
| KVCache | HBM 放热数据,本机内存放 SWA 窗口,3FS 放 Block KV;Block ≈ 528 B/token,SWA ≈ 1.4 MB/seq |
| 重算 | SWA 不进 3FS;缺失时 Bounded Replay 只回放最后 128 token,精确重建则要 2560 |
| 调度 | Prefill 按时间预算反解 chunk;Decode 双维度均衡;EPLB 压 max 不压 mean |
| 经济性 | 155 万亿 tokens/天,$38/卡·时;约 85% 命中,在线效率 ≈ 离线 80% |
一、先算账:155 万亿和 38 美金能对上吗?
先做一个最朴素的除法。
155 万亿 tokens/天,折算到每秒:
155 × 10^12 ÷ 86,400 ≈ 1.79 × 10^9 tokens/s
也就是每秒约 17.9 亿个 token。如果按第三方反推的约 7300 卡来摊:
1.79 × 10^9 ÷ 7300 ≈ 245,700 tokens/s/卡
245,700 × 3600 ≈ 8.85 × 10^8 tokens/卡·小时
注意:这里的 8.85 亿是「服务吞吐」,不是「计算吞吐」。命中缓存的 token 不需要重新跑 Prefill,成本主要是读 KV 与注意力计算,所以不能拿它去对比单卡 15.7k tok/s 的 Decode 生成速度。
每卡每小时约 8.85 亿 token。再用 $38 去除:
$38 ÷ (8.85 × 10^8) ≈ $4.3 × 10^-8 / token
≈ $0.043 / 百万 token
也就是说,这套系统的混合单价大约是 $0.043/M token。而 V4.1 Flash 的谷价表是:
| 计费项 | 谷价 | 说明 |
|---|---|---|
| 输入(未命中缓存) | $0.15 / M | 需要真正跑 Prefill |
| 输入(命中缓存) | $0.003 / M | 只读 KVCache,几乎不重算 |
| 输出 | $0.60 / M | 逐 token 解码 |
把三类 token 按某个比例混起来,看看能不能凑出 $0.043/M:
| 命中缓存 | 未命中 | 输出 | 混合单价 | 折合每卡小时收入 |
|---|---|---|---|---|
| 85% | 10% | 5% | $0.0476/M | ≈ $42.1 |
| 85% | 11% | 4% | $0.0431/M | ≈ $38.1 |
| 86% | 10% | 4% | $0.0416/M | ≈ $36.8 |
85% 命中、11% 未命中、4% 输出这组比例,几乎正好落在 $38 上。
这不是官方公布的流量结构,而是一次一致性检查。它说明了一件很关键的事:
155 万亿里,绝大多数不是「生成」出来的 token,而是「命中缓存」的输入 token。
这也解释了为什么后文要把大量篇幅花在 KVCache 上。对这套系统来说,缓存命中率不是一项优化指标,而是收入结构本身。命中率每掉一个点,意味着一批本来按 $0.003/M 计价的 token,要改成按 $0.15/M 去重算——单价看似高了,但算力成本涨得更快,毛利会被直接吃掉。
集群规模是推算,不是官方数字:100 PiB 的 KVCache 按每卡 14.4 TB 的逻辑表大小折算,大约 7000~7800 卡;再结合 155 万亿/天的吞吐与 85% 左右的命中率,量级落在 7300 卡附近。本文取 7300 作为计算基准。
二、系统总览:E/P/D 分离 + 独立存储
这套系统对应的开源框架是 DeepInfer。下文不严格区分「线上系统」与「开源实现」,两者不一致的地方会单独标注。
V4.1 Flash 推理系统的整体形态,可以用一句话概括:
Vision Encoder、Prefill、Decode 三段分离,外加一个独立的 KVCache 存储集群。
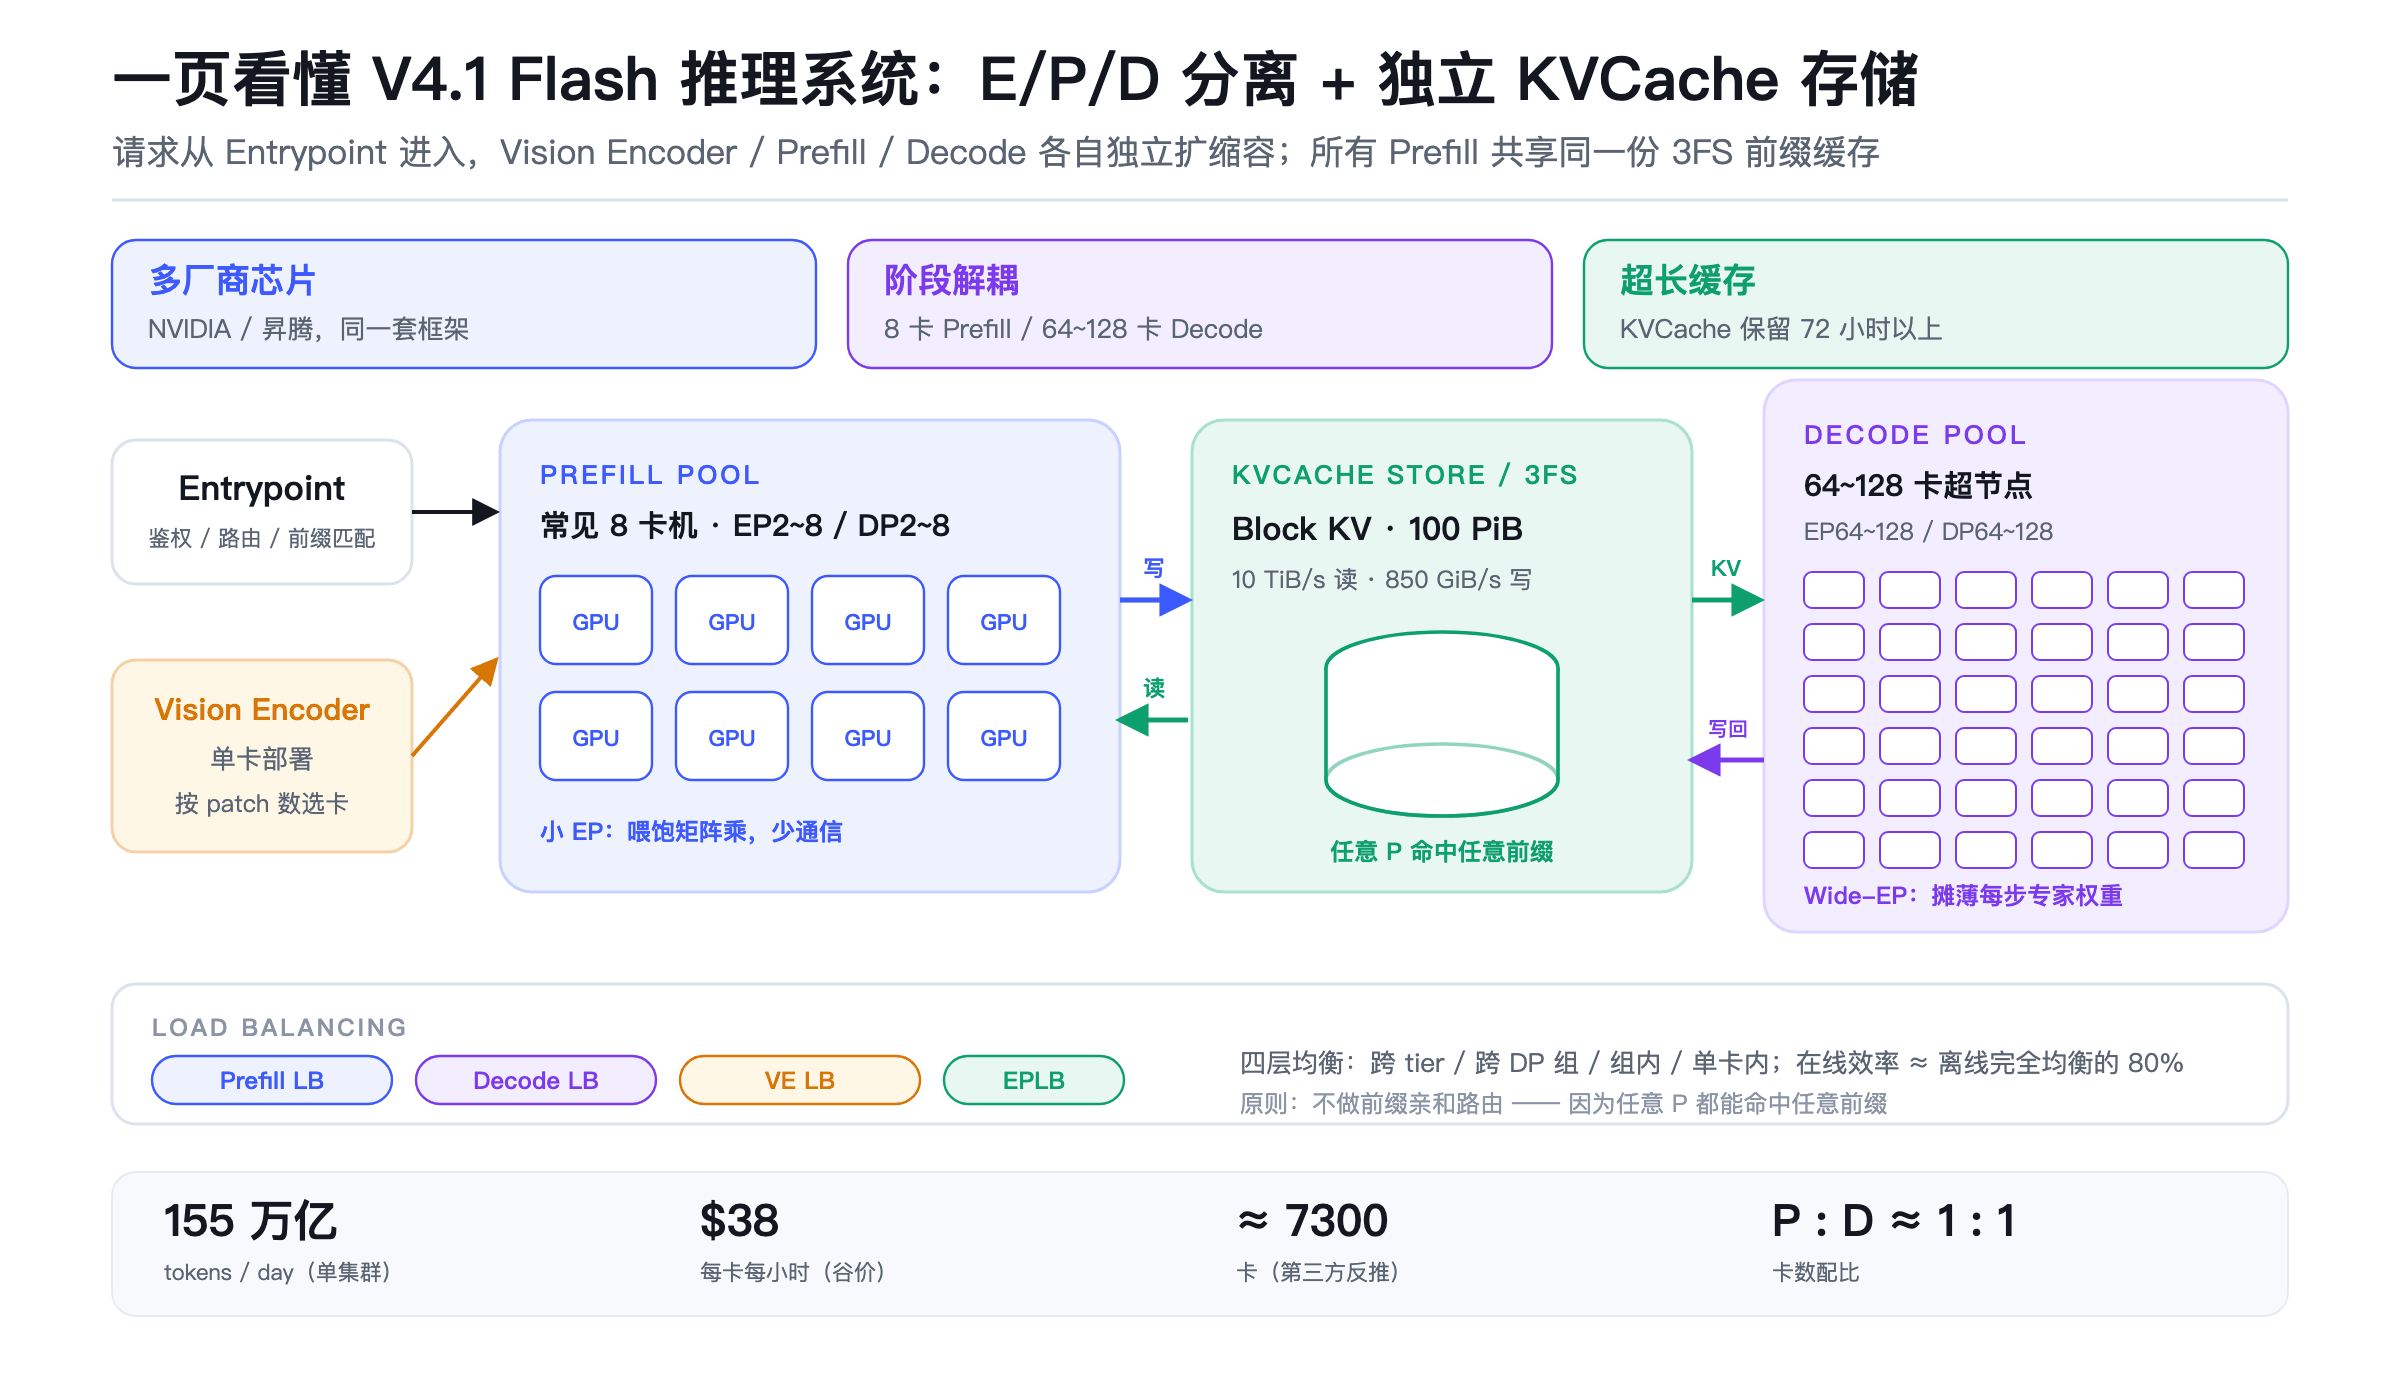
各部分的职责和配置:
| 模块 | 职责 | 典型配置 |
|---|---|---|
| Vision Encoder | 图片 patch 编码成 embedding | 单卡部署,建议用便宜的卡 |
| Prefill | 处理 prompt、算 KV、产出首 token | 常见 8 卡机,EP2~8 / DP2~8 |
| Decode | 逐 token 自回归生成 | 64~128 卡超节点,EP64~128 / DP64~128 |
| KVCache Store | 跨请求、跨机器复用前缀 | 独立 3FS 集群,约 100 PiB |
| Load Balancer | 四层均衡:Prefill / Decode / VE / EPLB | 与 Entrypoint 配合 |
几个容易被忽略的设计点:
第一,ATTN 部分用 DP,不用 TP。 系统继承 V3/R1 的思路,#DP = #EP,不同的 DP/EP 之间做负载均衡。官方明确说「暂未用 TP、CP」——在超节点规模下,TP 的 all-reduce 通信代价不划算,EP+DP 已经够用。
第二,Prefill 用尽可能小的 EP,Decode 用尽可能大的 EP。 Prefill 在显存够的前提下,EP 越小越好;Decode 在显卡够的前提下,EP 越大越好。这不是拍脑袋,下一节会用 roofline 解释。
第三,最小部署单元不是 1P+1D。 1P+1D 当然能跑,但 Decode 推荐 EP64 以上,所以效率高的最小单元是 64 卡 P + 64 卡 D。实践中 P 和 D 的卡数配比大约是 1:1。
第四,VE 是「单卡 + 便宜卡」。 图片编码的算力需求与文本 Prefill/Decode 完全不同,没必要占用宝贵的超节点卡。VE 的负载均衡也简单:按图片 patch 数 (width/patch_size) × (height/patch_size) 选当前最空的卡。
三、为什么 Prefill 要小 EP,Decode 要大 EP?
这是整套系统里最反直觉、也最值得讲清楚的一处。
3.1 一条 roofline,两个落点
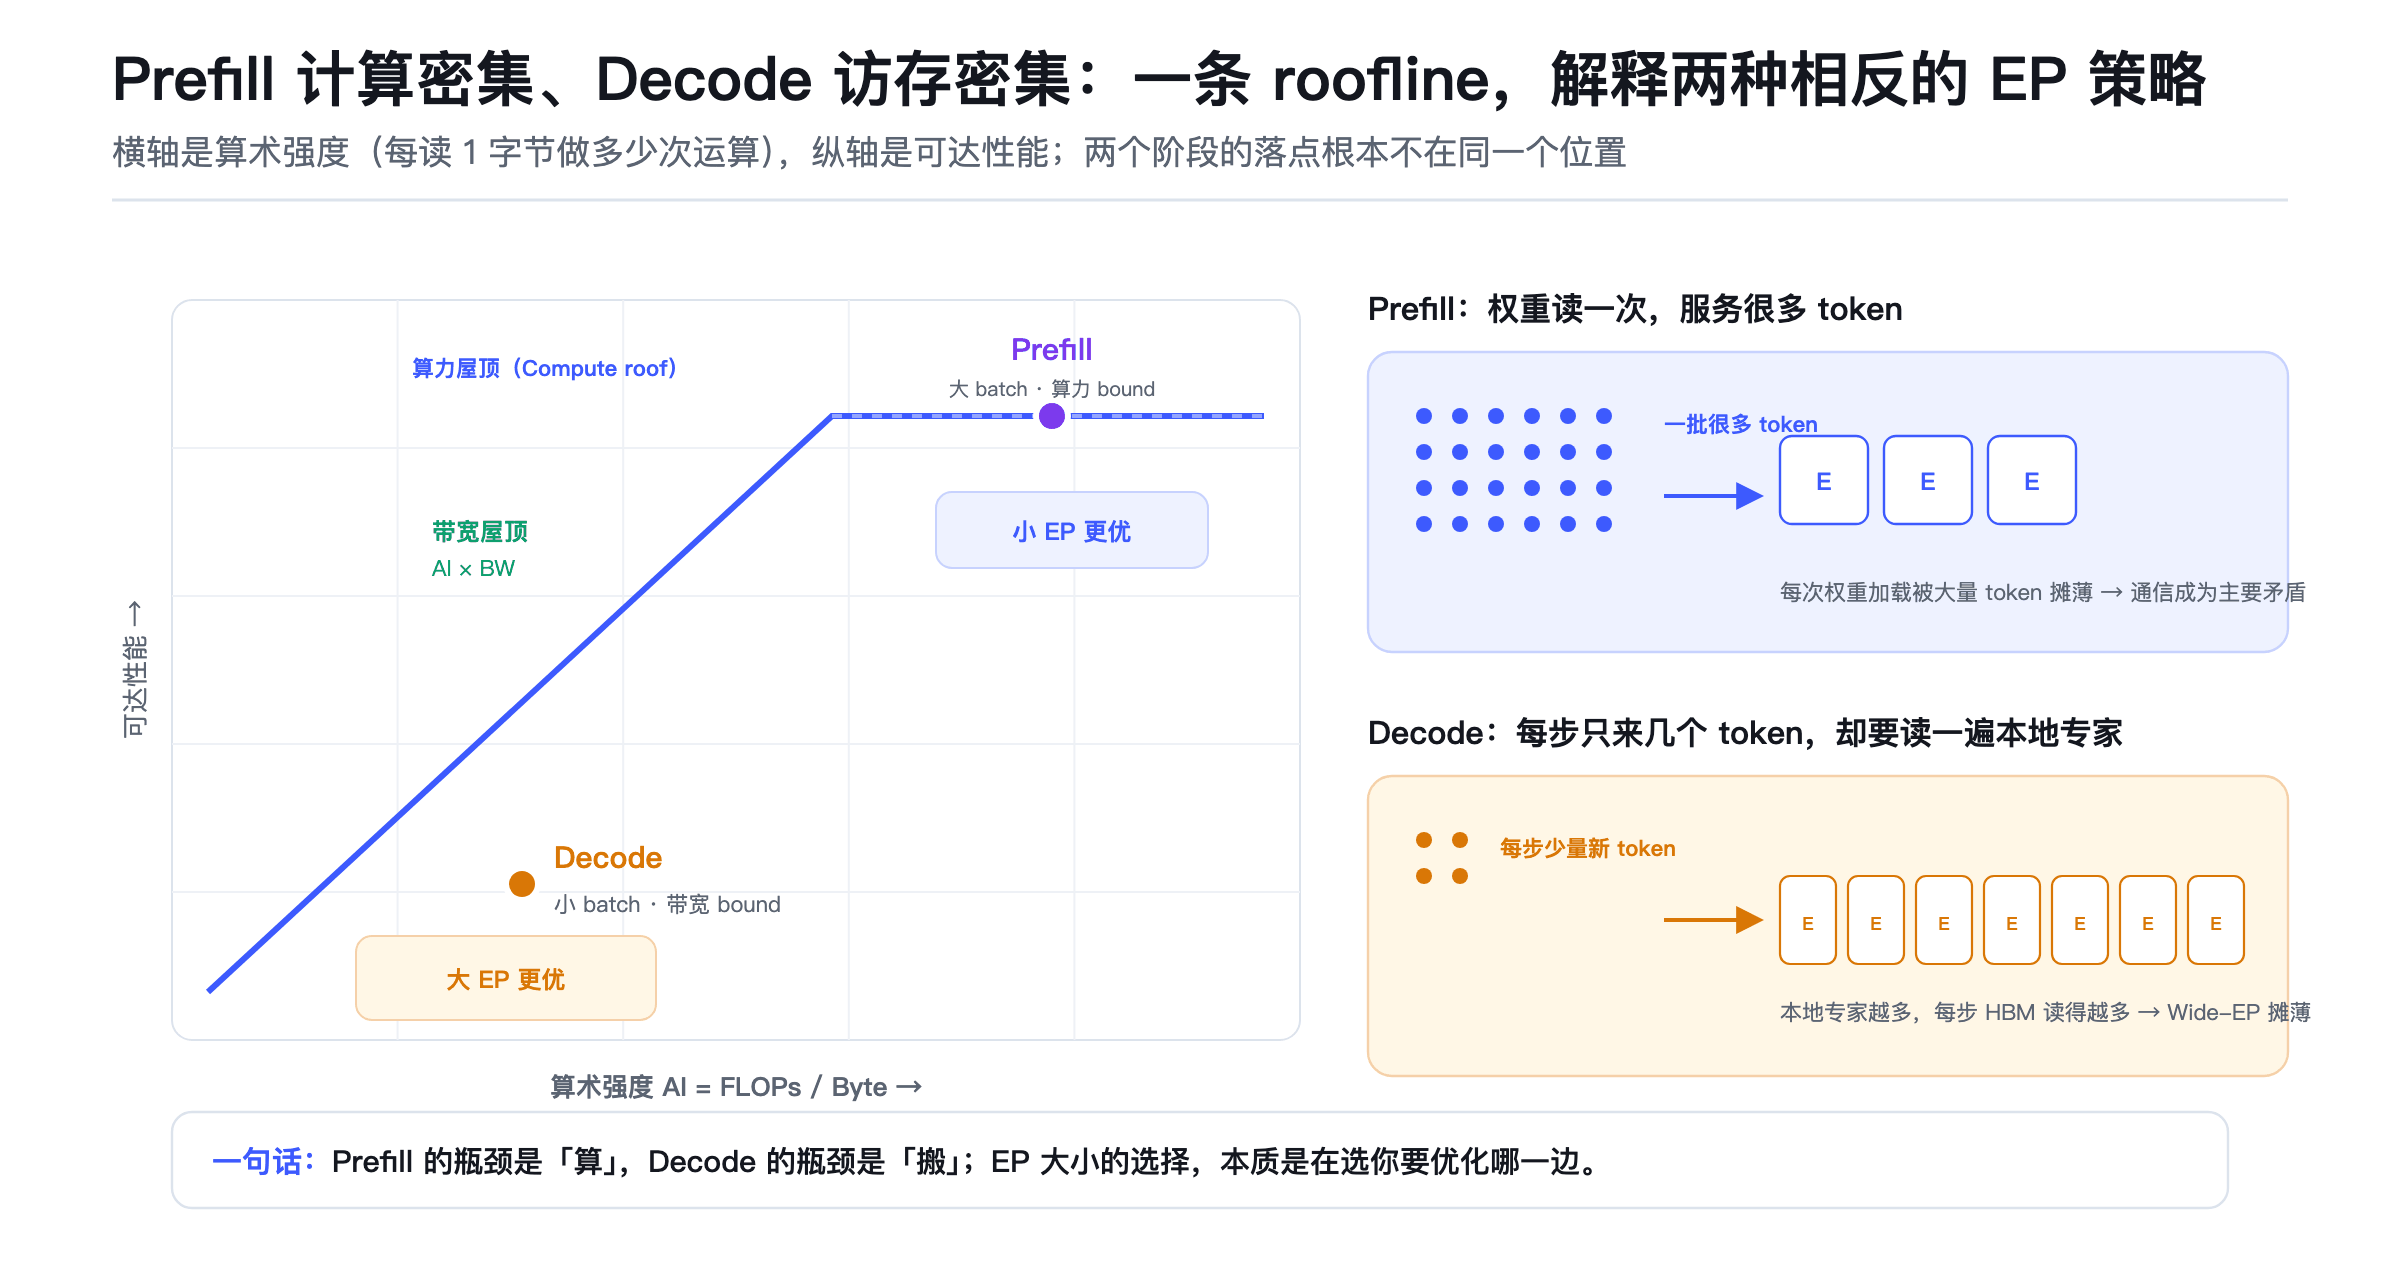
Roofline 模型把性能写成「算力屋顶」和「带宽屋顶」的较小值:
可达性能 = min(峰值算力, 算术强度 × 带宽)
算术强度 AI = FLOPs / Byte
- Prefill:一次处理几千个 token,矩阵乘的 batch 很大,每个权重被大量 token 复用,算术强度高,落在算力屋顶上,是 compute-bound。
- Decode:每步只来少量新 token,但每一步都要把模型权重(尤其是 MoE 专家权重)从 HBM 读一遍,算术强度低,落在带宽屋顶上,是 memory-bound。
这两个落点,直接决定了 EP 该大还是该小。
打个比方:Prefill 像一辆大卡车,一次装几千件货,每件货摊到的油费很低;Decode 像一辆小货车,一次只送几件,但每趟都要把仓库里所有货架巡一遍。要让小货车跑得快,就得把仓库拆小,让每辆车只巡自己那几排——这就是 Wide-EP。
3.2 把「每步要读多少专家权重」算出来
V4.1 Flash 有 384 个路由专家。EP 的本质,是把这些专家分散到多张卡上;每张卡负责一部分专家,同时多备几个冗余专家放热点副本。
于是,每卡每步需要从 HBM 读的专家权重,正比于本地专家数:
本地专家数 = 384 / EP + 冗余数
代入两组线上配置:
| 配置 | 本卡专家 | 冗余 | 本地专家数 |
|---|---|---|---|
| Prefill / EP8 | 384 / 8 = 48 | 4 | 52 |
| Decode / EP64 | 384 / 64 = 6 | 1 | 7 |
注:这里的专家数只算路由专家,不含共享专家;EPLB 的冗余副本另算。
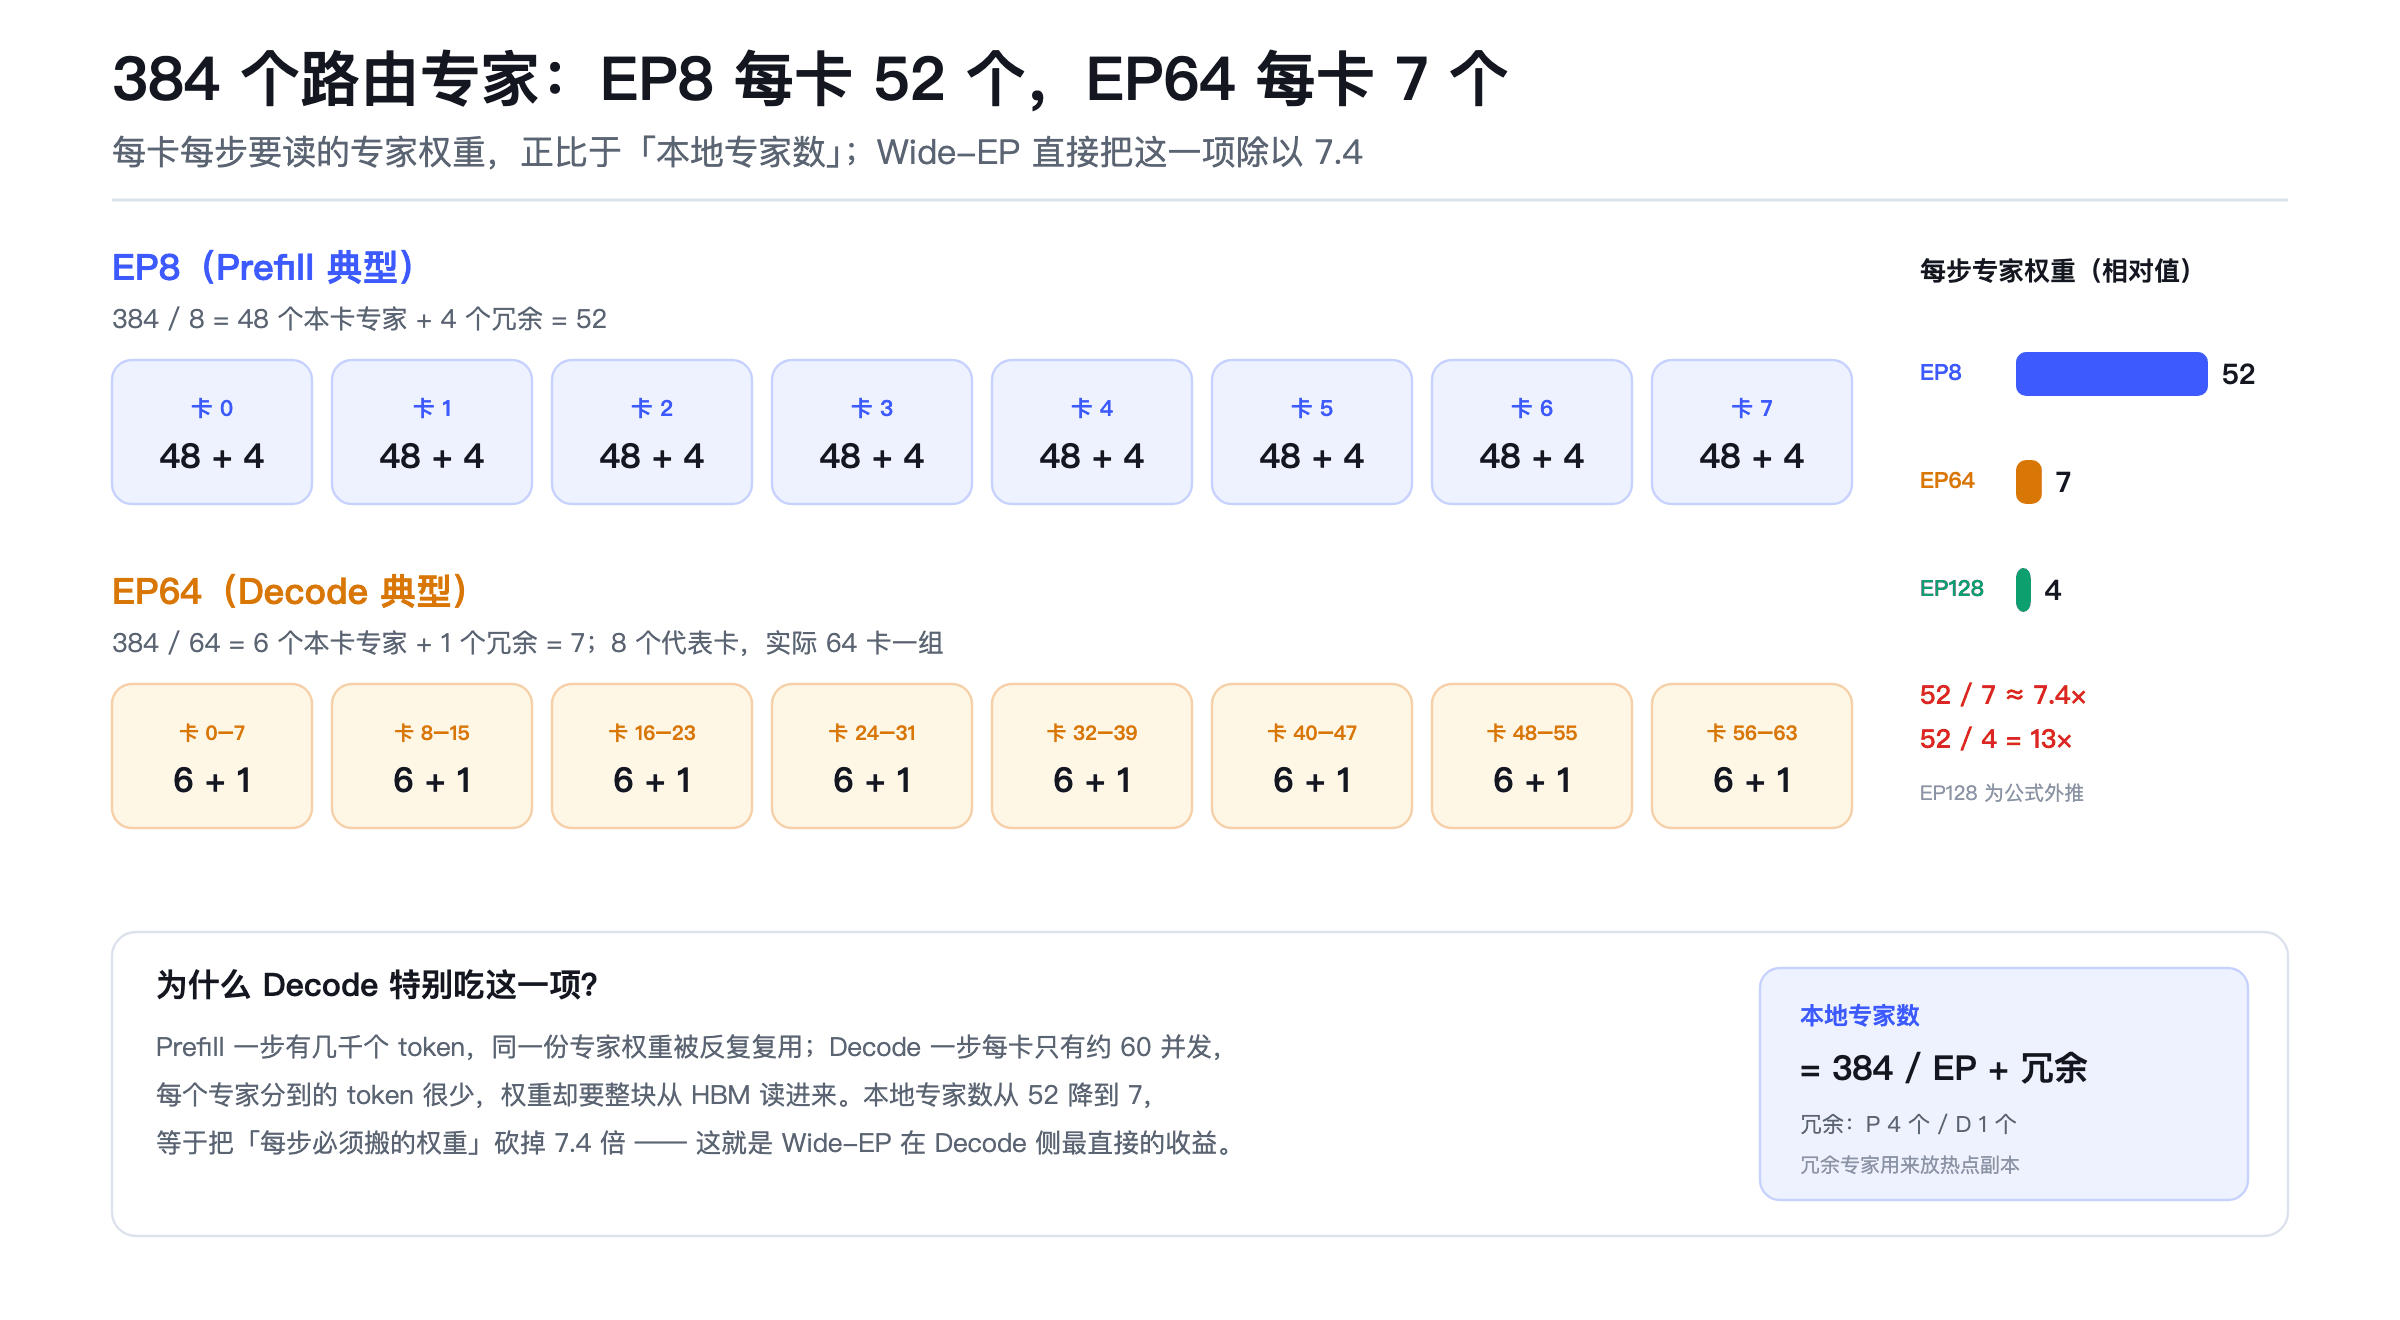
52 → 7,正好是 7.4 倍。 这就是 Wide-EP 在 Decode 侧最直接的收益:每步必须搬的专家权重,被摊到了 7.4 倍多的卡上。
为什么 Prefill 不这么做?因为 Prefill 一步有几千个 token,同一个专家权重被反复复用,权重加载被大量 token 摊薄;此时真正的矛盾是通信——EP 越大,all-to-all 越贵,反而拖累 TTFT。所以 Prefill 用小 EP,把通信压下去,让矩阵乘吃饱。
而 Decode 一步每卡只有约 60 并发,每个专家分到的 token 很少,权重却要整块读进来。此时通信可以靠 NVLink 和 overlap 藏起来,权重访存才是硬瓶颈。所以 Decode 用 Wide-EP,把 HBM 带宽压力摊到更多卡上。
还有一个配套的算子优化:NVLink 域内用 DeepGEMM 的融合 MegaMoE。官方说法是,无论 EP 大小、batch 大小,Mega MoE 都显著比非融合 MoE 快。它把专家分发的通信与计算融合在一起,进一步压低了 Wide-EP 的通信开销。
一句话总结:
Prefill 的瓶颈是「算」,Decode 的瓶颈是「搬」;EP 大小的选择,本质是在选你要优化哪一边。
3.3 代价是什么?
Wide-EP 不是免费的:
- 通信域更大:64~128 卡要在一个 NVLink scale-up 域里,对硬件形态有要求;
- EPLB 更难:专家越多、卡越多,热点越容易打偏,需要冗余专家和周期性重排;
- 故障域更大:一个实例的全部卡构成单一通信域,任意一张卡故障,整个实例不可用。
这三点,后文都会展开。先说结论:Wide-EP 是一笔用「通信与运维复杂度」换「HBM 带宽」的交易,只有在 Decode 这种 memory-bound 阶段才划算。
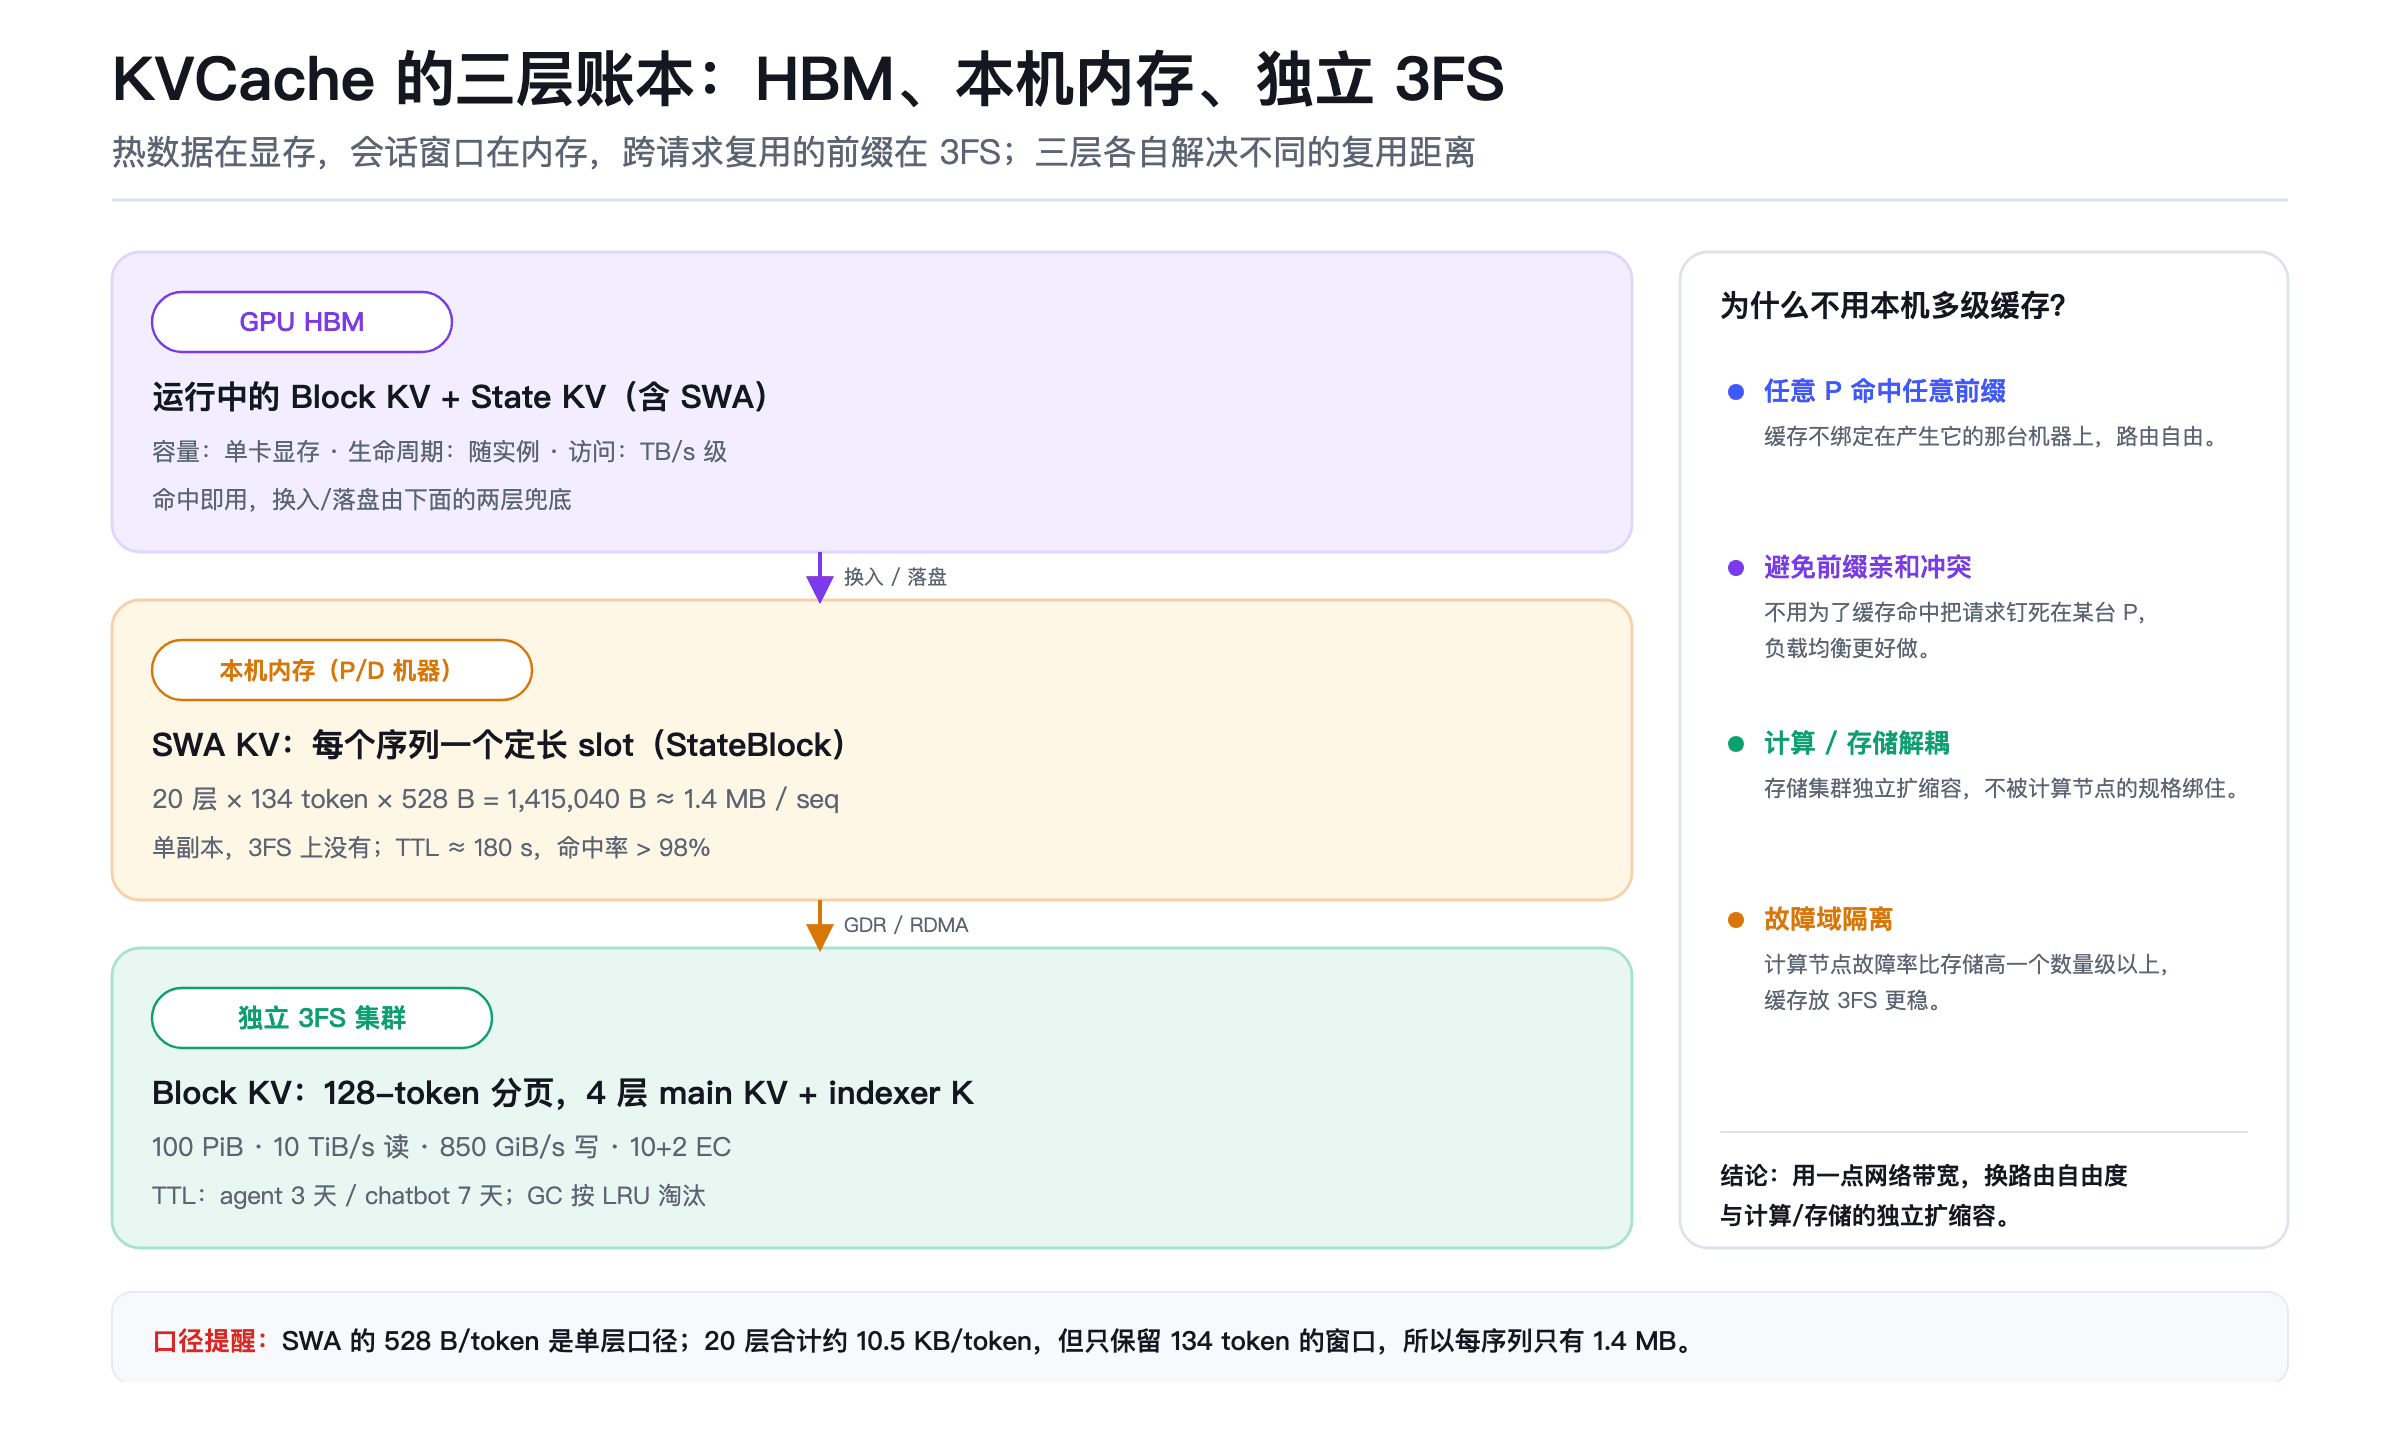
四、KVCache 的三层账本:HBM、本机内存、3FS
如果只记一句话:
热数据在显存,会话窗口在内存,跨请求复用的前缀在 3FS。
4.1 三层分别放什么
| 层级 | 内容 | 介质 | 副本 / 生命周期 | 关键数字 |
|---|---|---|---|---|
| HBM | 运行中的 Block KV + State KV(含 SWA) | 推理卡显存 | 随实例 | TB/s 级访问 |
| 本机内存 | SWA KV(每个序列一个定长 slot) | P/D 机器 DRAM | 单副本,3FS 上没有 | ≈ 1.4 MB/seq,TTL ≈ 180 s,命中 > 98% |
| 3FS | Block KV(128-token 分页) | 独立存储集群 | 应用层无副本,靠 3FS 冗余 | 100 PiB,10 TiB/s 读 / 850 GiB/s 写 |
几个细节值得展开。
Block KVCache 以 128 token 为一个 block 分页管理,存的是 4 层 main KV + indexer K。它不是把每一层的 KV 都存下来,而是利用模型结构里的跨层共享:只存少数几层的 main KV,再加上稀疏 Indexer 需要的 K。这是「总量能压到 528 B/token」的结构性原因。
SWA KVCache 不走分页,而是每个序列一个定长 slot(StateBlock)。前 20 层各一个 134 token 的 ring:窗口 128 + 投机回退 6。每序列在 state cache 里的大小是:
20 层 × 134 token × 528 B = 1,415,040 B ≈ 1.4 MB / seq
口径提醒:这里的
528 B/token是单层口径。20 层合计约 10.5 KB/token;但因为只保留 134 token 的窗口,每个序列仍然只有 1.4 MB。这个数字很小,正是 SWA 能放在本机内存、能跨机回拉、能跟着请求到处跑的根本原因。注意别和 Block KV 的
528 B/token混淆:Block KV 的 528 是 4 层 main KV + indexer K 的合计口径,SWA 的 528 是 单层口径,两者分母不同。
SWA 的目录逻辑上统一、实际按 key 分放在各台 Entrypoint 上;本机没有命中,就通过 400G VLAN 从别的机器回拉。因为每序列只有 1.4 MB,跨机回拉的代价远小于重算。
Decode 阶段没有开 KV offload,因为 Decode 不是 cache 容量 bound,也没用 Hi-Sparse。但 Decode 产生的 KV 仍然会落盘,目的是提升后续请求的命中率。
4.2 为什么不用本机多级缓存?
这是一个很关键的设计选择。直觉上,本机内存做 L2 缓存更快;但团队明确放弃了本机多级缓存,改用独立 3FS。原因有四条:
- 任意 Prefill 能命中任意前缀。缓存不绑定在产生它的那台机器上,路由就自由了。
- 避免前缀亲和与负载均衡冲突。不用为了缓存命中把请求钉死在某台 P,负载均衡可以按实际负载来。
- 计算/存储解耦。存储集群独立扩缩容,不被计算节点的规格绑住。
- 故障域隔离。计算节点故障率比存储高一个数量级以上,缓存放 3FS 更稳。
代价是网络开销。这笔账的算法是:用一点网络带宽,换路由自由度与独立扩缩容。对 155 万亿/天这种规模,路由自由度带来的吞吐收益,远大于多走一次网络的成本。
4.3 TTL 与容量:一组能对上的账
官方给出的 TTL 是差异化的:
- Agent 流量:3 天;
- Chatbot 流量:7 天。
为什么 chatbot 更长?因为 chatbot 的长尾命中更严重——少量 KVCache 会被极多次读取,一旦缺失,对整体命中率的损失更大。官方给了一个具体数字:3 天左右的 TTL,会造成 chatbot 流量的 KVCache 命中率下降 0.5%~1%。这就是多留 4 天缓存换来的收益。
再算一笔容量账。假设:
- Block KV 平均 528 B/token;
- 每天 155 万亿 token 中,约 20% 是新增缓存(15% 未命中 + 5% 输出);
- 那么 3 天的新增缓存约
155T × 20% × 3 = 93T token,折合93T × 528 B ≈ 49 PB ≈ 44 PiB; - 7 天则是
155T × 20% × 7 = 217T token,折合≈ 115 PB ≈ 102 PiB。
7 天的量,刚好落在 100 PiB 这个量级上。 这大概率不是巧合:100 PiB 的容量,就是按「7 天新增缓存」来配的;而 agent 流量用 3 天 TTL,留出容量给 chatbot 的长尾。这也从侧面解释了为什么 TTL 不是无限长——缓存容量不是无限的,TTL 是在命中率与容量之间找平衡。
以上 20% 新增比例、528 B/token 都是示意假设;结论只用于判断量级。
五、3FS 与 GDR:把「取缓存」变成一次不占 SM 的 DMA
KVCache 存在 3FS 上,接下来要解决的是怎么取。
5.1 10+2 EC:容忍两个节点同时故障
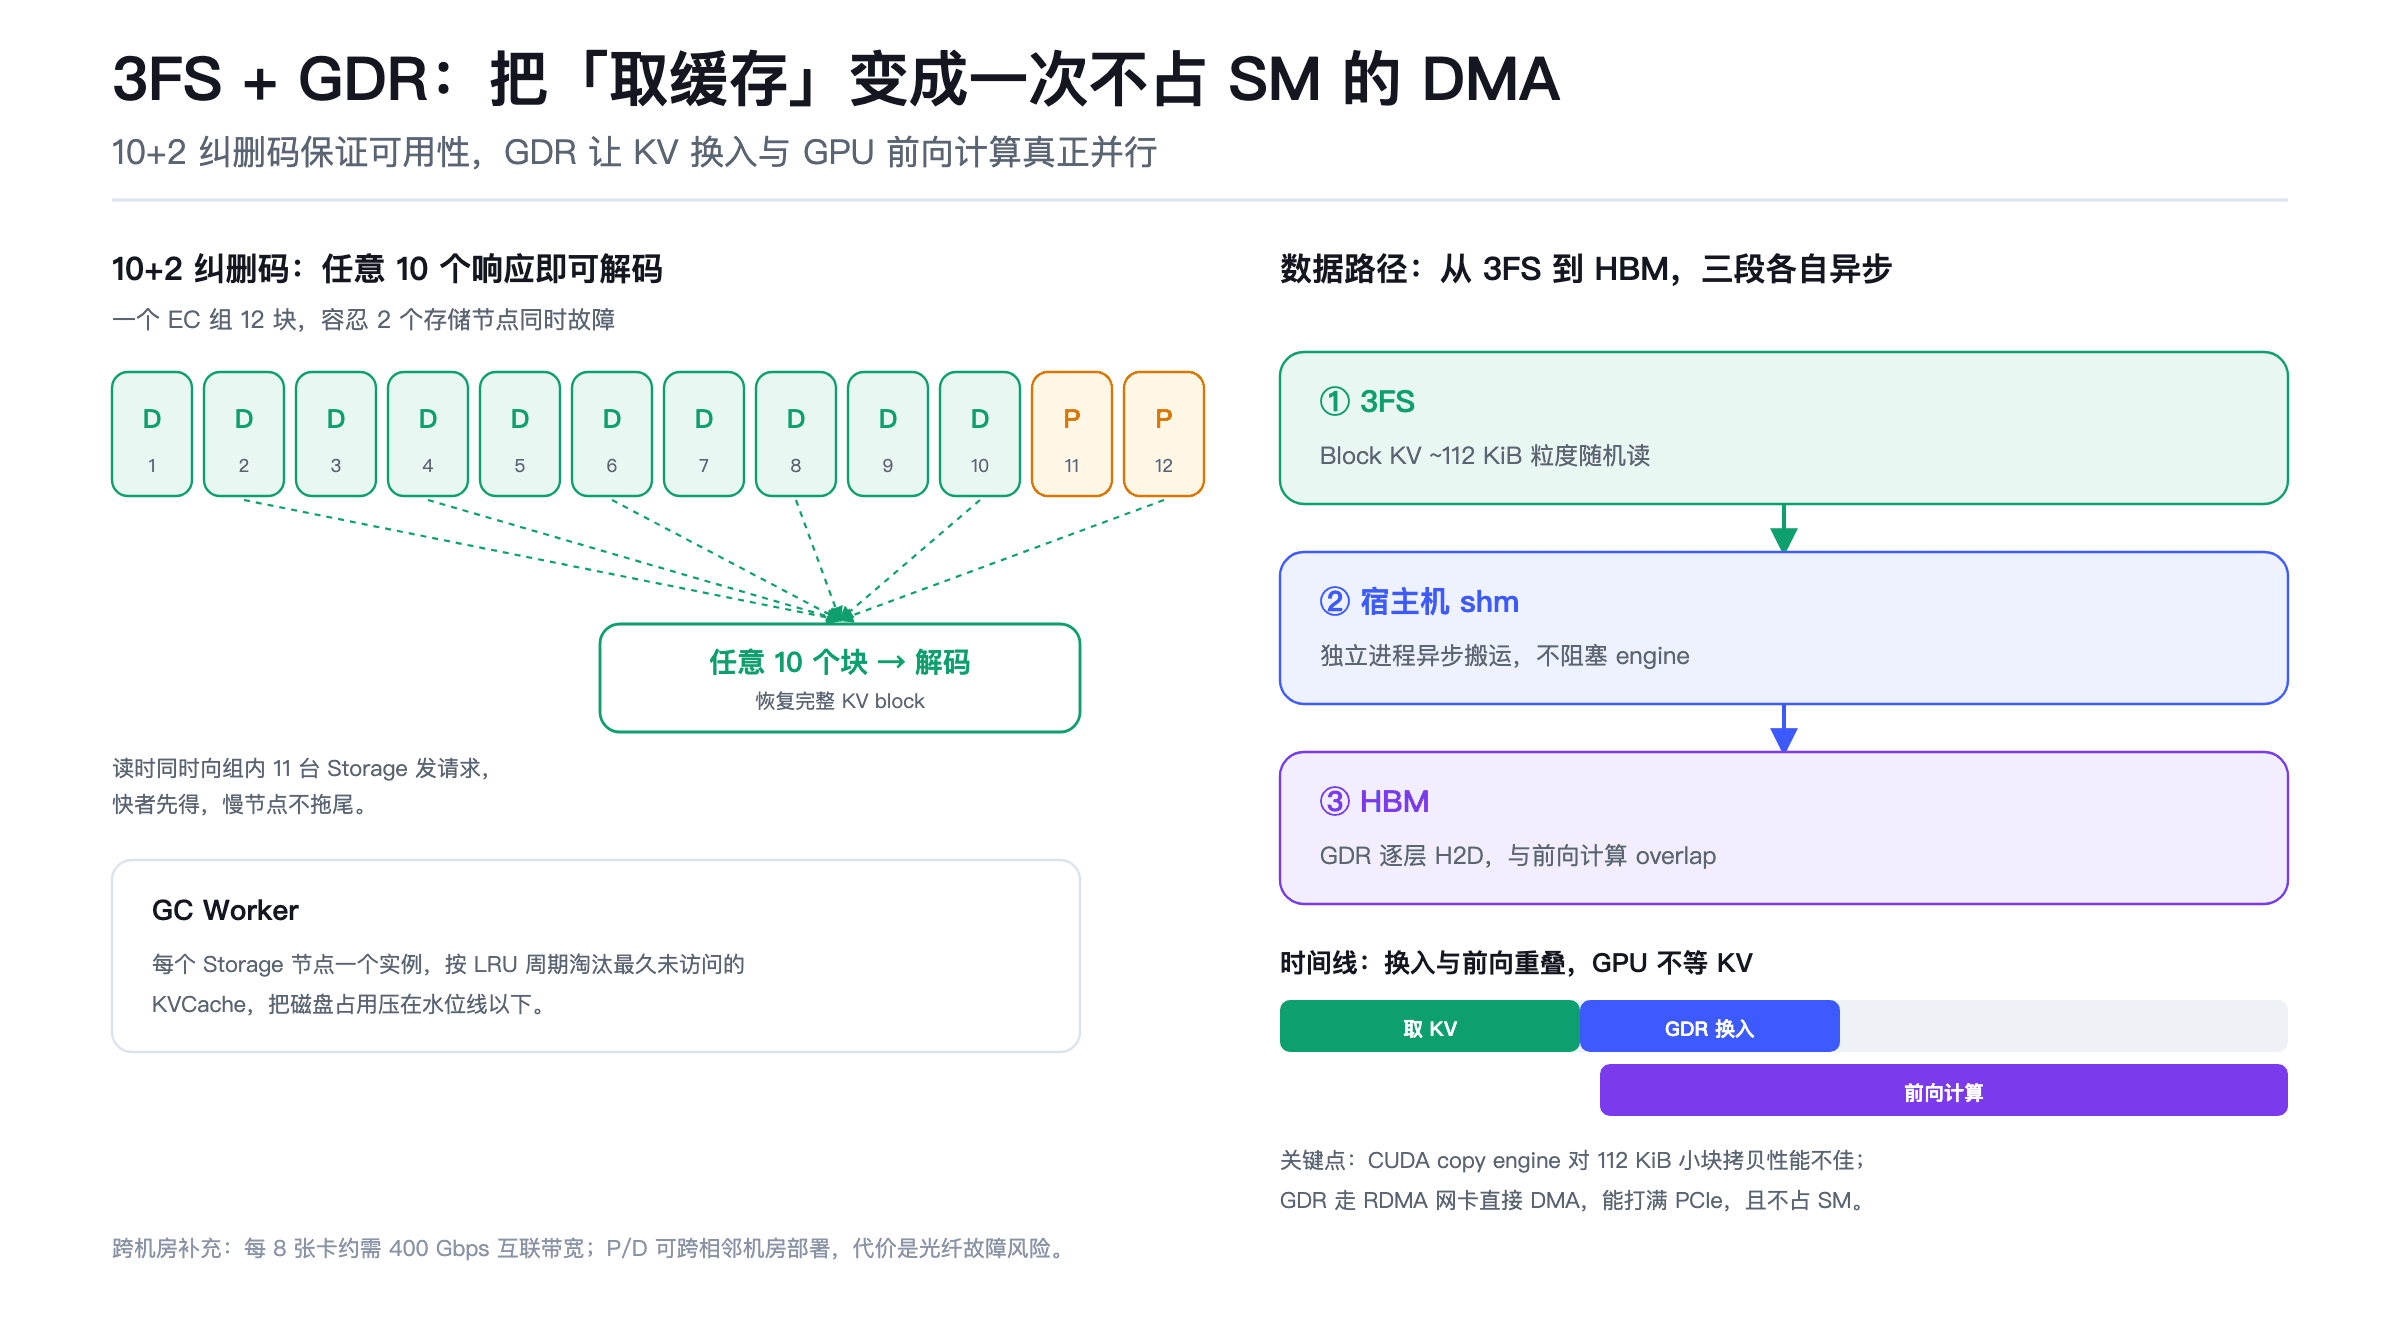
3FS 上的 KVCache 以 10+2 纠删码存放:一个 EC 组 12 块,10 个数据块 + 2 个校验块。读取时同时向组内 11 台 Storage 节点发起请求,任意 10 个响应即可解码。
这带来两个好处:
- 可用性:任意 2 个存储节点同时故障,数据仍然可读;
- 长尾:不用等最慢的那个节点,「快者先得」直接消掉慢节点带来的尾延迟。
GC 由 3FS 自己负责:每个 Storage 节点部署一个 GC Worker,按 LRU 周期淘汰最久未访问的 KVCache,把磁盘占用压在水位线以下。kvcache-store 侧没有过期逻辑,回收全在 3FS 的 GC 里。
存储服务端的推荐配置是 20 × 30.73 TB SSD,单服务端至少提供 40 GB/s 读、5 GB/s 写,总存储空间能保留 24 小时数据;然后按推理规模增加服务端个数。
5.2 数据路径:三段各自异步
一次 KV 命中,数据要走三段:
3FS(Block KV,约 112 KiB 粒度随机读)
  → 宿主机 shm(独立进程异步搬运)
  → HBM(GDR 逐层 H2D,与前向计算 overlap)
第一段,前缀匹配在 Entrypoint 完成。匹配由本机 kvcache-store 上的哈希链做,只查元数据。这里有一个很现实的约束:命中长度必须在路由前算出来,因为只有知道命中多长,才能决定这个请求去哪个 Prefill、要不要重算。所以这段开销无法被掩盖,是 TTFT 的固定成本。
第二段,取 KV 在独立进程里异步做,把 KVCache 从 3FS 搬进宿主机 shm,不阻塞 engine。
第三段,换入从 shm 到 HBM 在 engine 进程内的线程里做,目标是逐层 H2D 与前向计算重叠。
为什么不用 CUDA copy engine?因为 CUDA copy engine 对 KVCache Block 这种细粒度(约 112 KiB)的拷贝性能不佳。所以换入用 GDR 实现:走 RDMA 网卡直接 DMA,能打满 PCIe 带宽,而且不占 SM。这是一个很底层的硬件级优化——把「搬数据」从 SM 手里拿走,SM 才能专心算。
5.3 跨机房:400 Gbps / 8 卡
V4.1 Flash 大幅压缩了 KVCache,使得 P、D 跨机房部署在技术上可行。代价是可靠性:跨机房光纤容易被挖断。官方的实践是部署在不同但相邻的机房,每 8 张卡配约 400 Gbps 的互联带宽。
这也是「存算分离」的真实成本门槛:不是所有集群都能随便跨机房,网络带宽和光纤可靠性要先到位。
六、SWA Bounded Replay:为什么只重算 128 个 token 就够
如果说前面几节是系统骨架,这一节是整套设计的题眼。
6.1 问题:SWA 存得多,命中少
V4.1 Flash 有两类注意力层:
- 一类是纯滑动窗口(SWA),窗口 128;
- 另一类是压缩 KV + 稀疏 Indexer,用 top-k 选择。
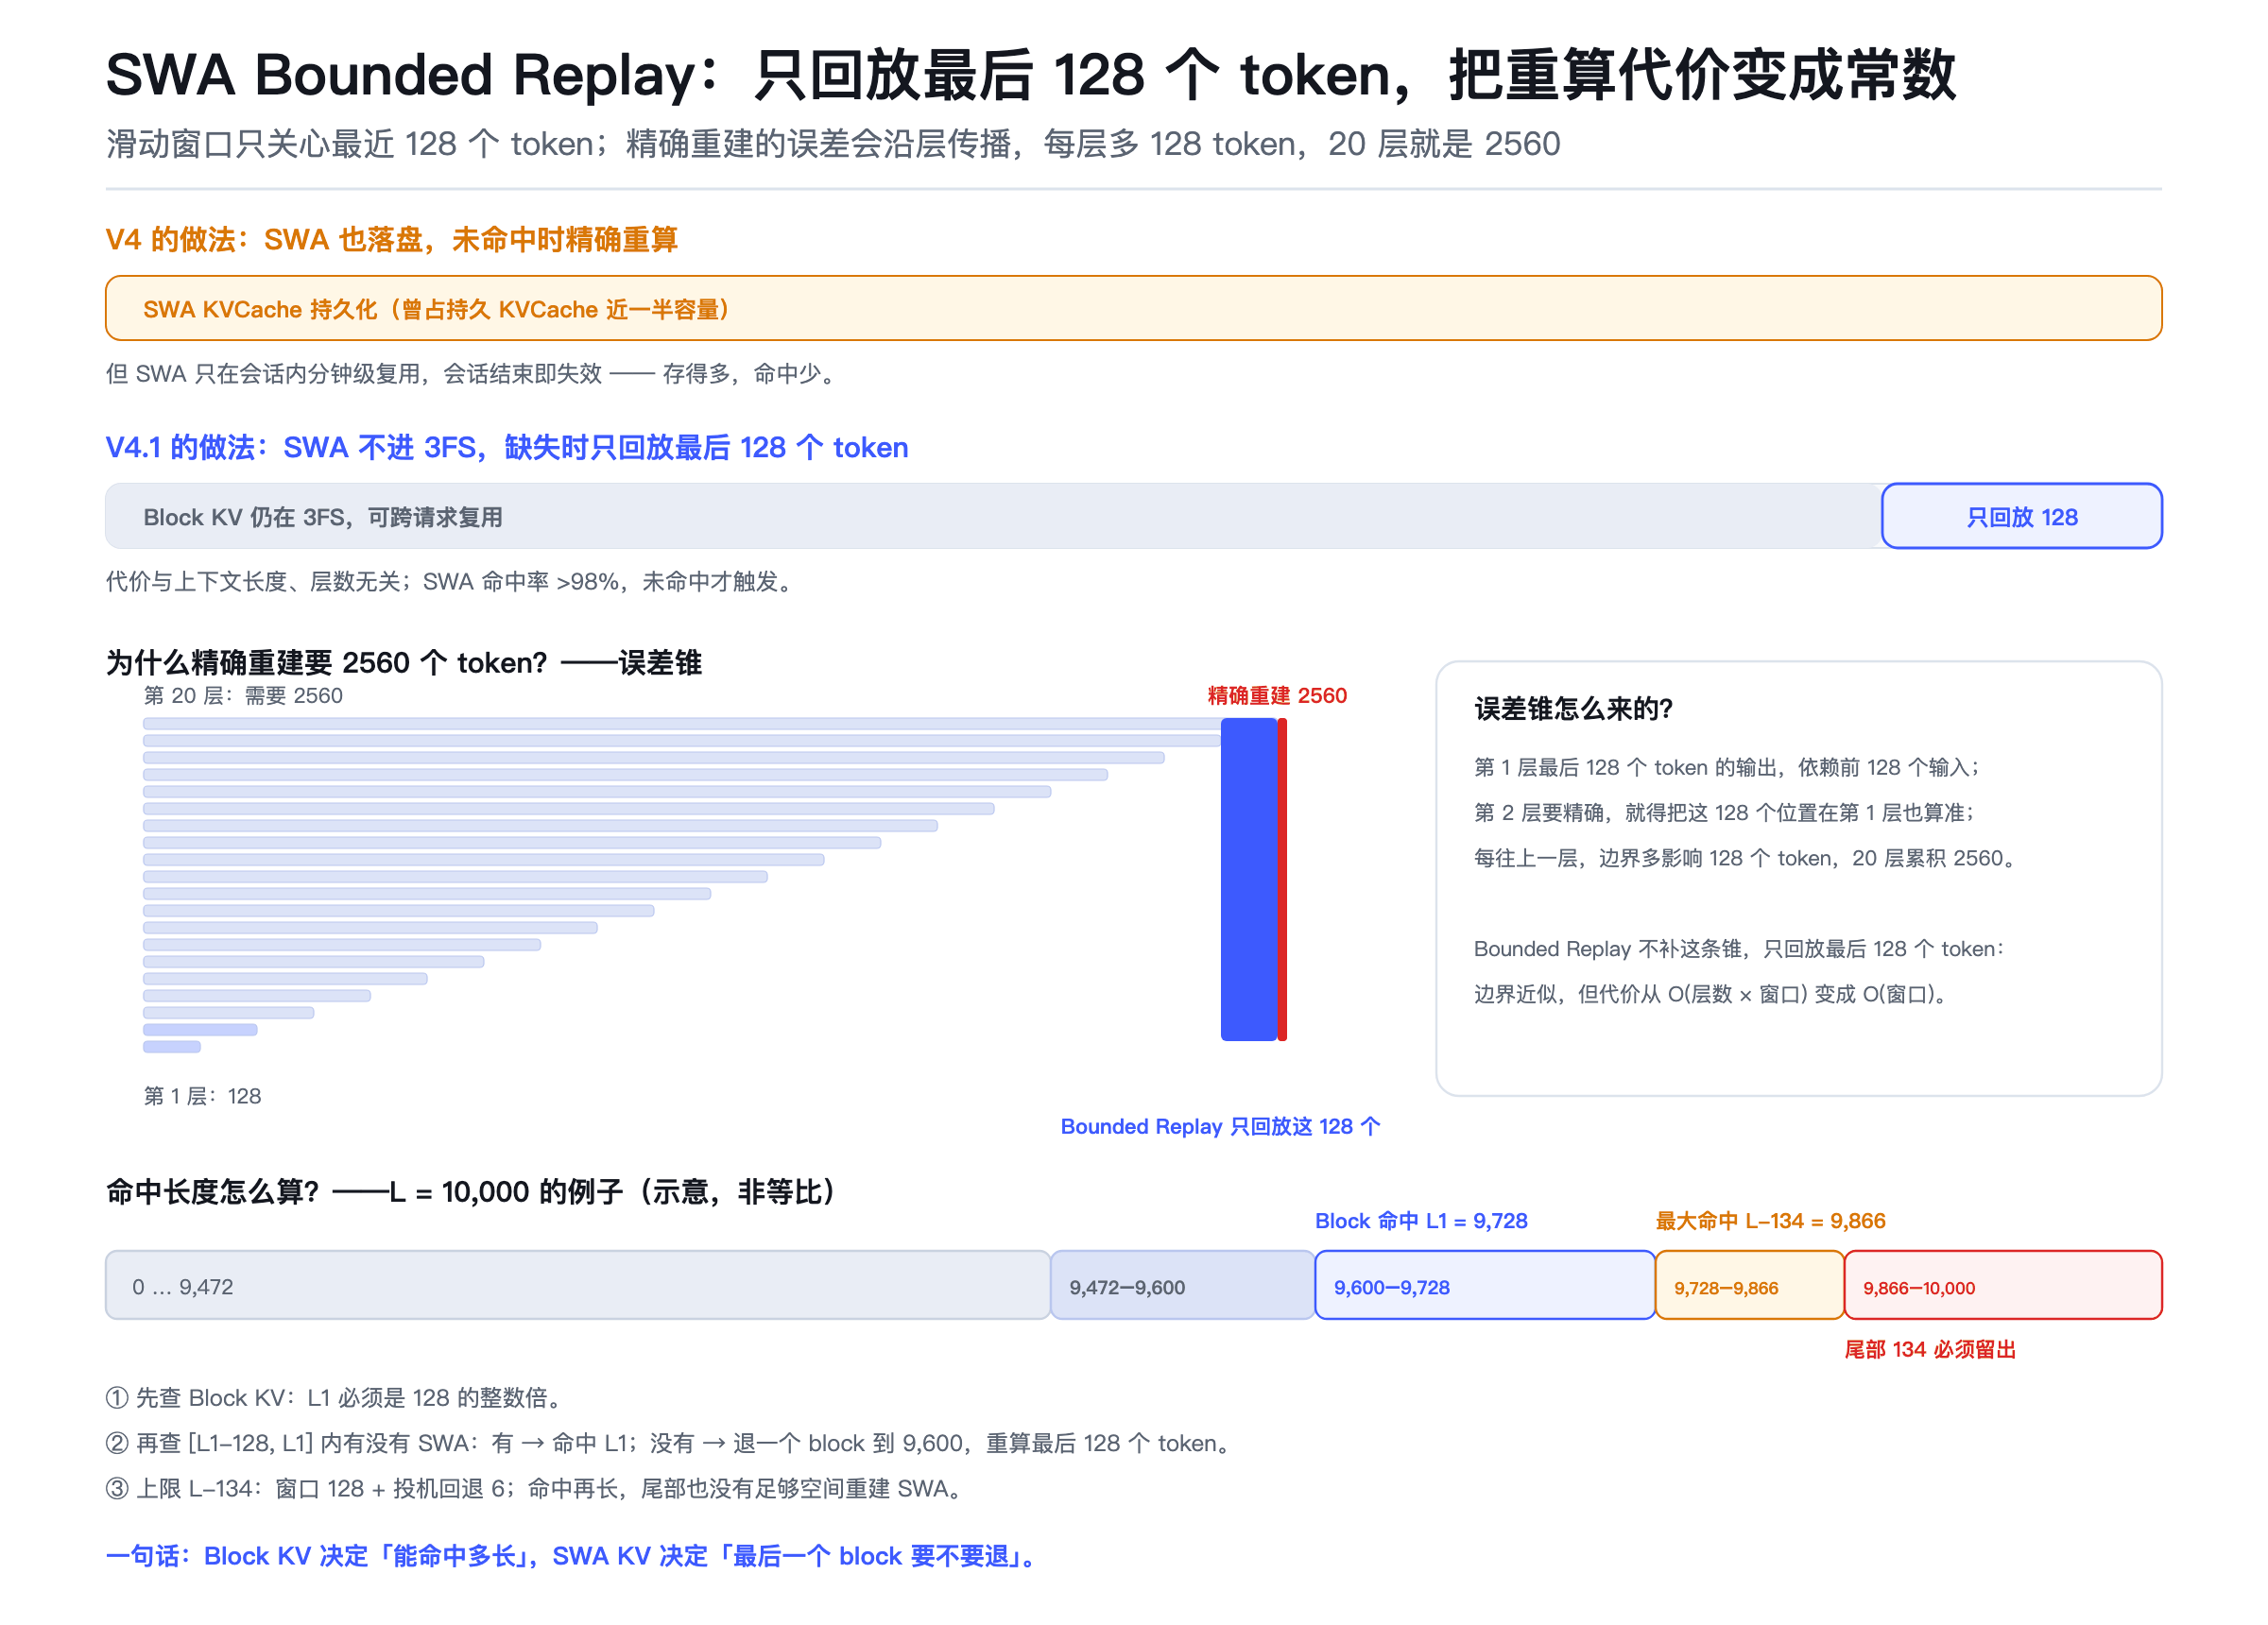
SWA 的特点是:它只在会话内的分钟级窗口里被复用。会话结束,缓存就失效了。V4 的做法是把 SWA KVCache 也写进持久化存储,未命中时重算「层数 × 窗口」个 token 做完整前向,逐层精确恢复窗口状态。
这条路径的代价很高:必须用足够大的 SSD 把未命中率压到极低。结果 SWA KVCache 占去了持久 KVCache 近一半容量,却没有带来相应的命中收益——Block KVCache 是长尾复用,一段前缀可以在数天内反复命中;SWA 只在活跃会话内被分钟级复用。
V4 技术报告提过 Zero SWA Caching(完全不落盘、仅依赖精确重算),但因为生产代价过高,没有被采用。
V4.1 最终选了第三条路:SWA Bounded Replay——只重算最近 128 个 token。
注意一个容易混淆的点:V4.1 的 SWA 仍然会留在产生它的那台机器的内存里(单副本,供本机快速命中),只是不再写进 3FS 持久化存储。所谓「不落盘」,指的是不进持久化缓存,不是「完全不存」。
6.2 机制:把窗口截断在重算段内
从位置 s 开始回放,位置 i 的 query 只和 max(s, i−127) 到 i 区间的 key 计算。这样重算出来的 SWA KVCache 是近似的,但重算代价降为与上下文长度、层数无关的常数。
打个比方:你不需要把整通电话重听一遍,只需要回听最后 128 秒,就能接上下一句。误差出在边界上的几个字,但足够继续对话。
它用在两处:
Encoder SWA Bounded Replay:前缀缓存命中长度从此只依赖 Block KVCache。SWA KVCache 缺失时,重算命中前缀的最后 128 个 token,与未命中后缀一同前向;重算段只重建 SWA KVCache,Block KVCache 原样复用,不重算、不覆写。
Decoder SWA Bounded Replay:在 CED 架构下,decoder 层的 Block KVCache 由 encoder 末层 hidden state 投影得到,只有 decoder SWA KVCache 需要各层自算。精确重建要让误差锥完全展开:每往上一层,就要多回放 128 个 token 才能把边界补准,20 层累积就是 2560 个 token;而 Bounded Replay 只在 decoder 层重算 prompt 末尾 128 个 token,产出仅供 decode、不进前缀缓存。总 Prefill 计算量近乎减半。
6.3 为什么 2560,而不是 128?
这是最容易看漏的一处。
假设你要精确重建 decoder 最后一层、最后一个 token 的 SWA 状态。这个 token 的表示,依赖上一层最后 128 个 token 的输出;而上一层这 128 个 token 里,最早的那些又依赖再上一层更早的 128 个 token……每往上一层,误差边界就多影响 128 个 token。20 层叠起来,就是 2560。
Bounded Replay 不补这条「误差锥」,只回放最后 128 个 token。代价是边界近似;收益是重算量从 O(层数 × 窗口) 变成 O(窗口),与上下文长度彻底解耦。
注意「近似」二字:Bounded Replay 恢复的不是严格精确的 SWA KV,而是近似值。团队判断这个近似在精度上可接受——因为它只影响窗口边界,而滑动窗口本身只关心最近 128 个 token。
6.4 命中策略:一个 L=10,000 的例子
命中的原则是:
命中长度由 Block KVCache 决定,最后一个 block 要不要重算由 SWA KVCache 决定;SWA 未命中,就退一块重算。
具体规则:
- 根据 YOCO 截断要求,最大命中长度最多为
L − 134(窗口 128 + 投机回退 6)。 - 先查 Block KVCache,假设命中长度为
L1(L1是 128 的整数倍)。 - 再查
[L1 − 128, L1]范围内有没有 SWA KVCache:- 有 → 命中长度为
L1; - 没有 → 命中长度为
L1 − 128,退一个 block,重算最后 128 个 token。
- 有 → 命中长度为
代入 L = 10,000:
最大命中 = 10,000 − 134 = 9,866
Block 命中 L1 = 9,728(128 的整数倍)
SWA 检查区间 = [9,600, 9,728]
  有 SWA → 命中 9,728
  没有   → 命中 9,600,重算最后 128 个 token
这个例子把「Block KV 决定能命中多长,SWA KV 决定最后一个 block 要不要退」讲得很清楚。
6.5 边界工程:134 和 396 是怎么来的
SWA 的 ring 长度不是随便定的:
- 推理视角:ring = 窗口 128 + 最大回退 6 = 134(考虑投机解码最多回退 6 个 token)。
- PE 侧:为了支持在任意位置 store,ring 加长到 396 = 134 + 128 + 134。因为 store 只在 128 的整数倍处触发,而 prefill chunk 的边界不会正好落在整倍数上;多留这一段,才能从 ring 里重排出一个完整可写的 134-token 窗口。CE 不开这个 extra,ring 就是 134。
存储也只在 128 的整数倍位置上发生:
- Prefill 阶段:位置取序列末尾留出一个 token 后向下对齐到 128;不足 128 则本轮不存;chunked prefill 中途不存,只有最后一个 chunk 才存。
- Decode 阶段:在显存里另开一块副本区,每跨过一个 128 token 边界就把当前窗口拷入副本区;请求结束时从最近一次完成拷贝的位置存储,附着点向下对齐到 128。拷贝位置最多越过边界 5 个 token,由 ring 比窗口多出的 6 个位置吸收。
这些细节看起来很「抠」,但正是它们让一个近似重算的方案能在生产里稳定运行。
七、负载均衡:把「均衡」拆成四层,再用一个二次方程定 chunk
KVCache 解决了「重复算」的问题,接下来要解决「谁来算」的问题。
V4.1 Flash 有四类负载均衡器:Prefill Load Balancer、Decode Load Balancer、Vision Encoder Load Balancer、Expert-Parallel Load Balancer。
7.1 Prefill LB:四层拆分
Prefill 的负载均衡,按「粗到细」拆成四层:
第一层,按 context 总长分桶。 分成 4 个 tiers:<16K、16–64K、64–256K、≥256K。每档分到的引擎台数,按该档上一轮的 compute-quota 需求占比动态重分;每档有各自的单批 compute-quota 上限。
第二层,DP 组间按剩余 compute-quota 拉取。 任何引擎都能命中任何前缀,所以不做前缀亲和路由。这是第四章「独立 3FS」设计的直接结果:既然缓存不绑定机器,路由就没必要为缓存牺牲均衡。
第三层,DP 组内按 quota 最低的 rank 分配。 一批请求给到 engine,每收到一个,就给当前 quota 负载最低的 DP rank。
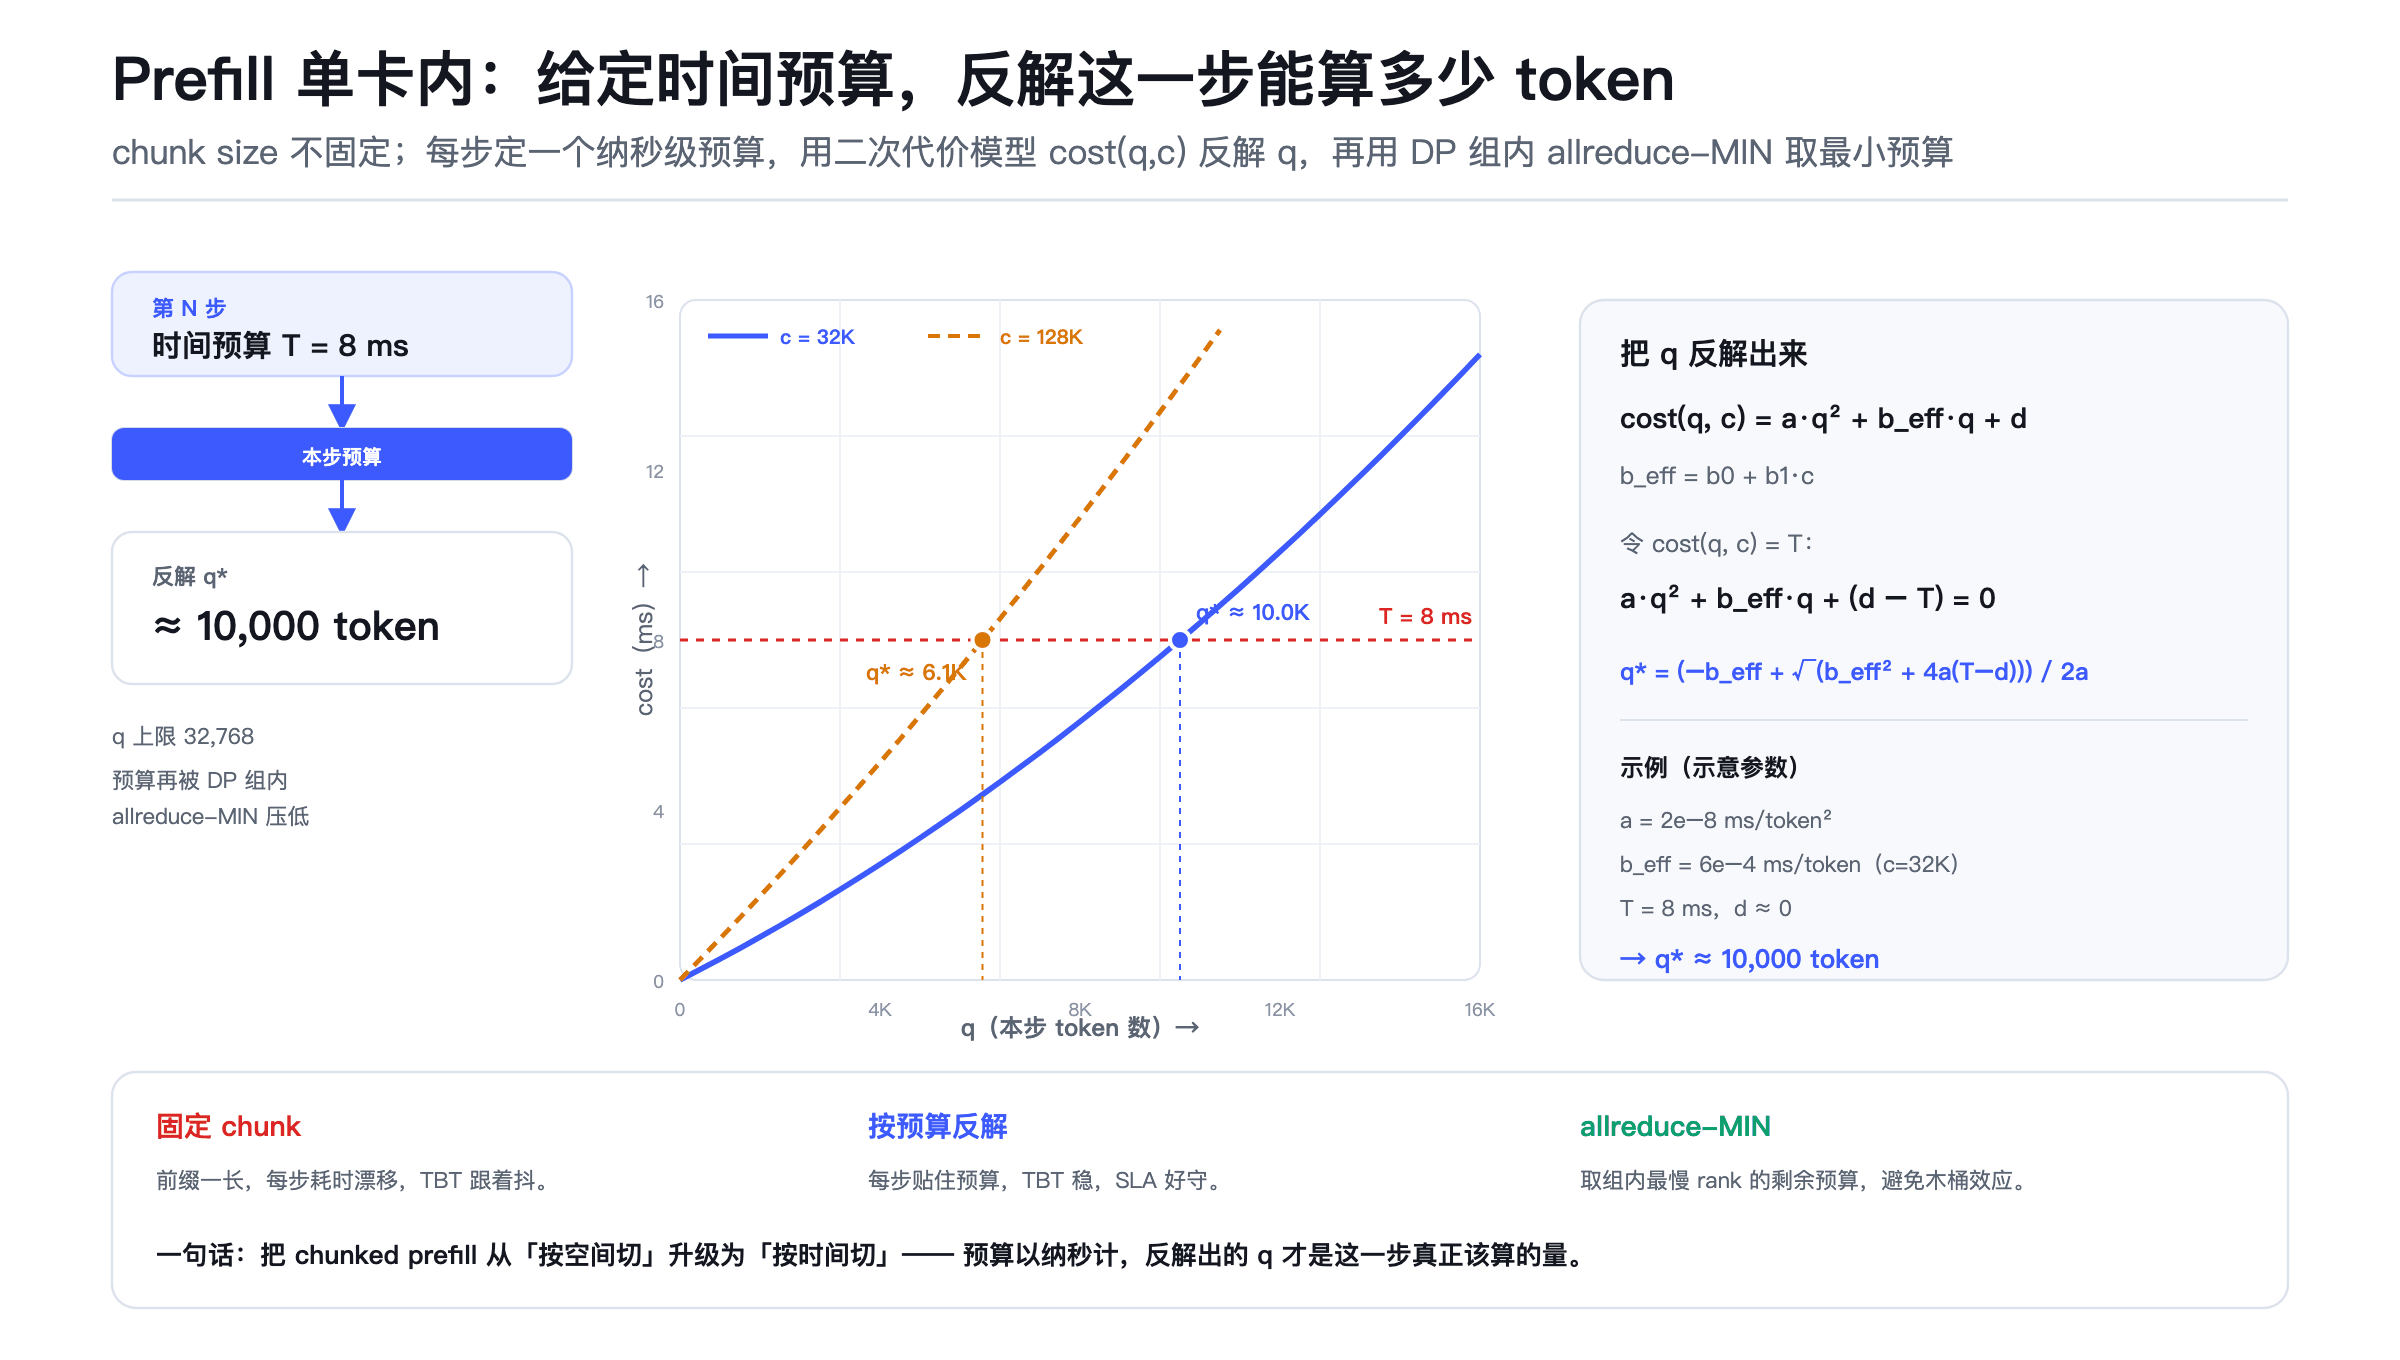
第四层,单卡内 FIFO 出队,chunk size 不固定,由预算反解。 这是整套调度里最精彩的一笔。
7.2 二次代价模型:把 chunked prefill 从「按空间切」变成「按时间切」
Prefill 每一步定一个时间预算 compute_quota_limit,单位是纳秒。然后用一个拟合的二次代价模型预测这一步要花多久:
cost(q, c) = a·q² + b_eff·q + d
b_eff = b0 + b1·c
其中:
q= 序列中未命中的 token 数(这一步要算多少);c= 这条序列已经算完的前缀长度;a·q²主要来自 attention 的二次项;b_eff·q主要来自 FFN、投影等线性项;d是固定开销。
调度时,令 cost(q, c) = T,对 q 反解这个二次方程:
a·q² + b_eff·q + (d − T) = 0

q* = (−b_eff + √(b_eff² + 4a(T − d))) / (2a)
取「在 32,768 的 token 预算之内、又正好把剩余时间预算吃满」的最大 q。
举个示意例子(参数仅用于说明反解过程):
a = 2e−8 ms/token²
b_eff = 6e−4 ms/token(c = 32K 时)
T = 8 ms,d ≈ 0

2e−8·q² + 6e−4·q − 8 = 0
→ q* ≈ 10,000 token
如果前缀更长(c = 128K),b_eff 变大,同样的 8 ms 预算只能反解出约 6,100 个 token;如果前缀更短,q* 会更大。chunk size 不再是一个拍脑袋的固定值,而是前缀长度、硬件性能和当前预算的函数。
预算本身还会被 DP 组内的 allreduce-MIN 压低:取组内最慢 rank 的剩余预算,避免木桶效应。
为什么非要按时间切?因为固定 chunk size 的问题是:前缀一长,每一步的耗时就会漂移,TBT 跟着抖,SLA 不好守。按预算反解,每一步都贴住预算,TBT 稳,SLA 好守。这就是「按时间切」相对「按空间切」的核心优势。
7.3 Decode LB:同时均衡请求数和 KV 长度
Decode 的负载均衡,对所有 decode 实例的所有卡做统一路由,原则是同时均衡两个维度:
- 请求数:决定每步的 batch 大小;
- KVCache 总长度:决定注意力部分的代价。
启发式规则是:
- 短请求发给「并发较小、且 KVCache 总长偏大」的卡;
- 长请求发给「KVCache 总长较小」的卡。
具体可以参考 DualPath 的组内调度算法。这个启发式的直觉是:短请求对 batch 大小敏感,长请求对 KV 长度敏感;把两类请求错开,才能同时压住两个维度。
7.4 VE LB:按 patch 数选卡
Vision Encoder 的路由以单台机器为单位:由 Prefill 机器随机选中一台部署有若干 Vision Encoder 的机器,在这台机器上,把图片交给当前处理 patch 数最少的卡。
patch 数由宽高直接算出:
patch 数 = (width / patch_size) × (height / patch_size)
这个逻辑很简单,但很有效:图片的 patch 数差异很大,按 patch 数均衡比按请求数均衡更接近真实负载。
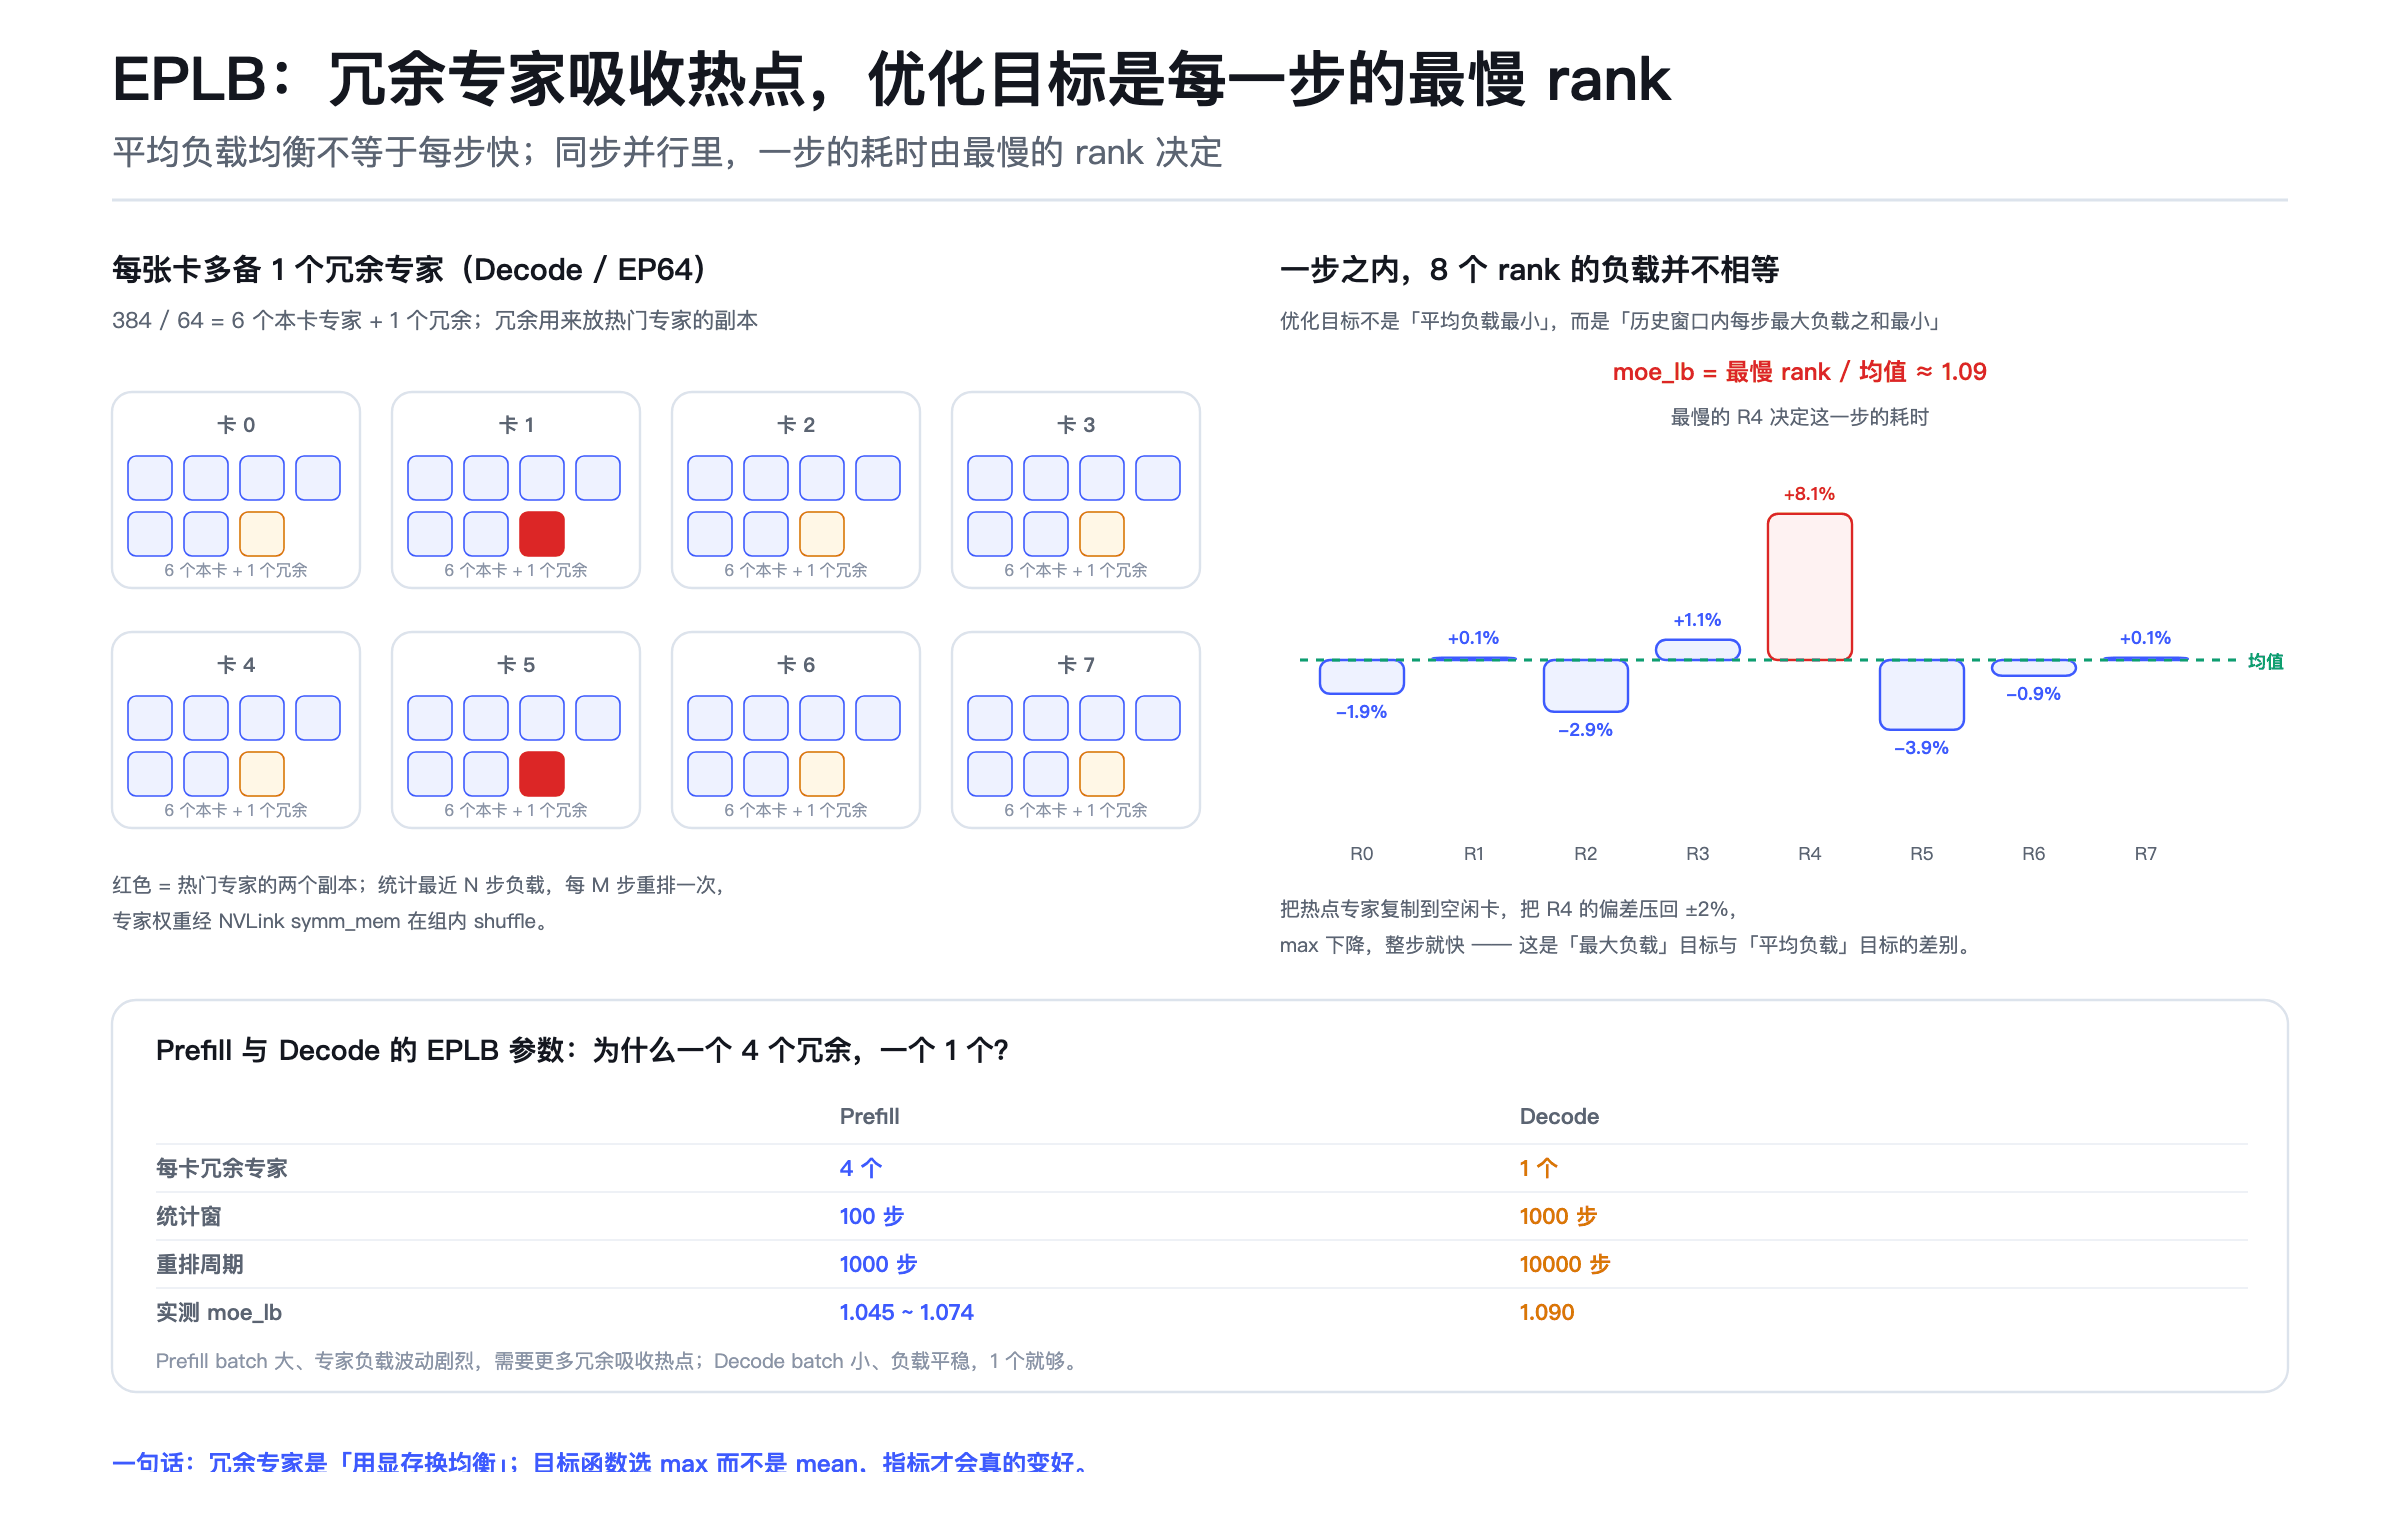
7.5 EPLB:冗余专家与「最大负载」目标
专家并行也有负载均衡问题。V4.1 Flash 的做法是:
- 每张卡在自己的专家之外,多备若干冗余专家,用来放热门专家的副本;
- 统计最近
N步各专家的负载; - 每
M步根据统计结果重新分配专家到卡; - 专家权重经 NVLink symm_mem 在组内 shuffle。
Prefill 和 Decode 的参数不同:
| 参数 | Prefill | Decode |
|---|---|---|
| 每卡冗余专家 | 4 个 | 1 个 |
| 统计窗 | 100 步 | 1,000 步 |
| 重排周期 | 1,000 步 | 10,000 步 |
| 实测 moe_lb | 1.045 ~ 1.074 | 1.090 |
为什么 Prefill 要 4 个冗余,Decode 只要 1 个?
- Prefill batch 大,专家负载波动剧烈,需要更多冗余副本吸收热点;
- Decode batch 小,负载相对平稳,1 个冗余就够。
更关键的是目标函数。公开的 EPLB 仓库优化的是平均负载;线上这版优化的是「历史窗口内每步最大负载之和」。前者让整体更均衡,后者直接压的是每一步的最慢 rank。
为什么?因为同步并行里,一步的耗时由最慢的 rank 决定。平均负载再低,只要有一个 rank 慢,整步就慢。所以指标 moe_lb = 最慢 rank / 均值 和优化目标是统一的:压 max,而不是压 mean。
这也解释了代码里 384+64 和 384+32 这两个数字:
- Decode EP64,每卡 1 个冗余 →
64 × 1 = 64→ 384+64; - Prefill EP8,每卡 4 个冗余 →
8 × 4 = 32→ 384+32。
两处完全独立的披露,在这里严丝合缝地对上。
7.6 在线效率:80%
做了这么多均衡,整体提升到底有多少?
官方给了一个很诚实的数字:在线大概能达到完全均衡的离线 benchmark 的 80%。
这 20% 的差距,就是在线的动态性成本:请求来得不均匀、长度分布会变、机器会故障、热点会漂移。80% 不是一个需要羞于承认的数字,而是一个可以用来对标的刻度。自建系统如果只能做到 60%,说明调度还有很大空间;如果能做到 85% 以上,说明已经非常接近理想。
八、把 GPU 的空闲时间填满:异步调度、变长投机与结构化输出
前面几节讲的是「怎么少算」「怎么算得快」。这一节讲的是「怎么不让 GPU 闲着」。
8.1 Decode 一步的流水线,以及那段空闲
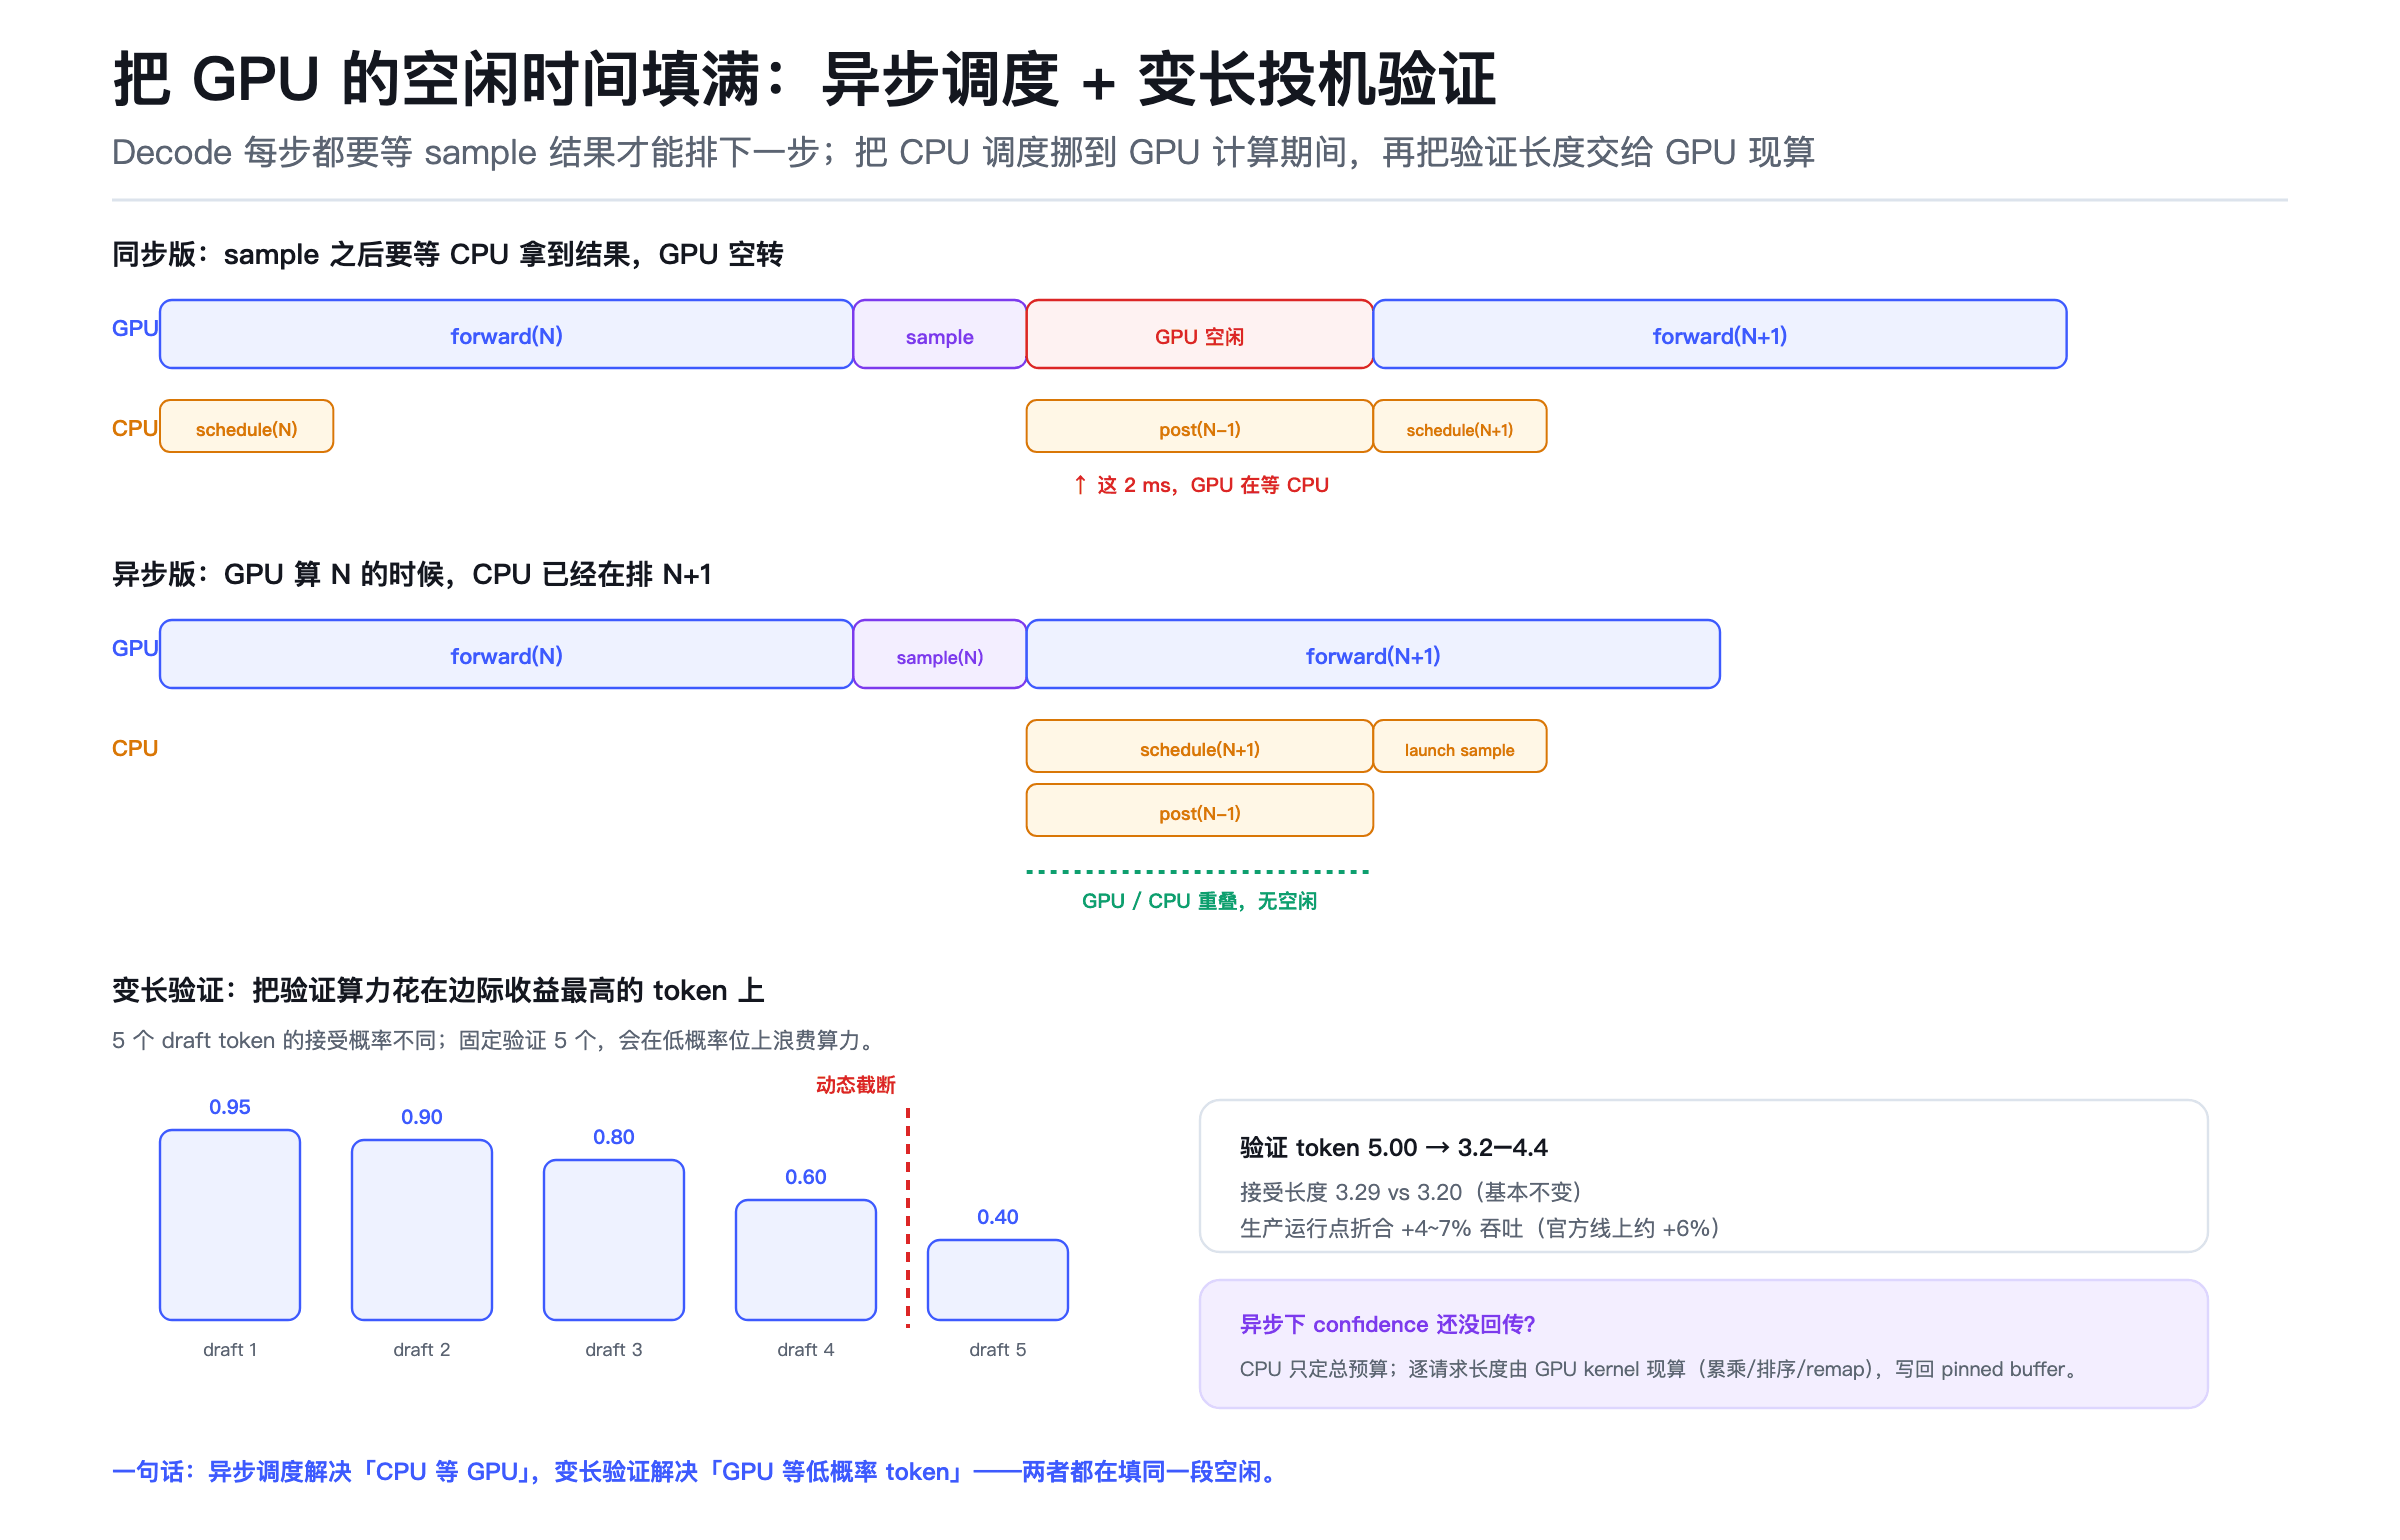
Decode 第 N 步的流程是:
schedule(N) → forward(N) → sample(N) → post-process(N)
其中 schedule 和 post-process 是纯 CPU 逻辑。问题在于:在 post-process(N) 之前,需要 GPU-CPU 同步拿到 sample(N) 的结果。这就导致 post-process(N) 和 schedule(N+1) 执行的时候,GPU 是空闲的。
Asynchronous Scheduling(Zero-Overhead Batch Scheduler)的目标,就是去掉这段空闲。
实现参考了 SGLang、Nanoflow 等已有方案:通过 GPU 和 CPU 之间的异步调度,把流水线重叠起来——GPU 执行 forward(N) → sample(N) 时,CPU 同步执行 schedule(N+1) → launch_forward(N+1) → post-process(N-1) → launch_sample(N+1),让 GPU 全程无空闲。
这听起来像常规的 CPU-GPU overlap,但对 memory-bound 的 Decode 尤其重要:如果 CPU 调度开销成为瓶颈,GPU 再快也会被拖住。
8.2 变长投机验证:从「赌长度」到「算期望」
投机解码(DSpark)是另一条提效路径。相比 DFlash,DSpark 在输出的 base logits 上叠加一个只依赖前一 token id 的低秩 logit bias,用极轻量的串行修正补回相邻 token 的局部条件化信息,从而提升 draft 准确率。
但更值得讲的是验证策略。
不同请求、不同位置的 draft token,接受概率是不同的。固定验证 5 个 token,会把验证算力浪费在低概率 token 上。DSpark 的做法是:
- 用 Confidence Head 预测每个 draft token 的接受率;
- 调度时,把验证算力分配给边际收益最高的 token;
- 线上部署时,draft 一次生成 5 个 token,根据 profile 出来的硬件吞吐曲线和每个 draft token 的接受率,把各 token 按预期接受率排序,选取有效吞吐最大的前缀子集进行验证。
效果:
- 每步验证的 draft token 数从 5.00 降到 3.2~4.4,砍掉约 30%;
- 平均接受长度基本不变(3.29 vs 3.20);
- 根据 EP64/DP64 benchmark,在生产运行点(每 rank 约 60 并发)折合 +4~7% 吞吐;
- 官方线上数据:相比固定验证 5 个 token,变长验证吞吐提升约 6%。
这里有一个很真实的工程矛盾:异步流水线下,schedule(N+1) 执行时第 N 步的 confidence 还没回传。怎么办?
答案是分工:CPU 调度时只确定总预算;逐请求的具体验证长度,由 GPU 上的一个 TileLang kernel 现算(累乘、全局排序取 top-k,并融合 remap scatter),结果回写 pinned buffer。
CPU 定粗粒度,GPU 定细粒度——这是为了不打断异步流水线,也是这套系统里「把决策下沉到 GPU」的一个典型例子。
8.3 结构化输出:把编译挪出热路径
结构化输出(Structured Output, SO)用于约束模型输出严格符合指定格式(JSON Schema、正则、EBNF 等)。它的工作流是编译与推理解耦:
- 编译阶段(独立 SO 机器):把格式约束编译为语法自动机;
- 运行时:每步 decode 更新自动机,判断合法 token 集合,生成 mask 作用于采样逻辑,强制输出符合目标结构。
把 schema 编译(慢、CPU 密集)从推理热路径剥离到独立 SO 机器,是避免首 token 延迟被编译拖累的标准做法。运行时只做「查自动机 + 生成 mask」的轻量操作,把约束成本降到最低。
8.4 番外:Recipe 的防注入与并行分词
DeepSeek Recipe 是这次一起开源的 Token 编解码组件,支持 Chat Completions、Responses、Messages 三种 API 协议,用 Rust 实现,带 Python 绑定。
它解决的两个问题很值得单独说:
第一,special token 注入。 用户输入、工具返回、工具调用参数里,可能包含 <|User|>、<|image|> 这样的字符串。如果它们被当成真正的 special token,就能劫持对话角色或触发思考结束。Recipe 的做法是:构建 prompt 时记录显式插入的 special token 及其位置,编码时直接映射到对应 token ID;普通文本按基础词表编码。用户输入里的这些字符串会被编码为普通 token 序列,从编解码层堵住注入面。
第二,长文本 tokenize 的延迟。 线性 tokenize 会拖慢 TTFT,并显著增加 CPU 开销。Recipe 利用 BPE 的局部性:special token 是天然切分点,special token 之间的普通文本可以独立、并行编码,最后按原顺序拼接。这样超长 prompt 的分词就从串行变并行。
此外,流式解析用状态机 + KMP 增量匹配:遇到不完整的 UTF-8 字符先缓冲,解析器按思考、正文、工具参数等阶段维护状态;chunk 末尾只有标记的一部分时,保留匹配进度,下一个 chunk 继续识别。工具参数则按 DSML 边界直接生成 JSON 片段,字符串值逐段转义,数组/对象按原始 JSON 文本输出,不需要构造完整参数对象。
还有一个容易被忽略的细节:V4 的推理强度是往 prompt 里写一段话,V4.1 改成写一个数字(50 / 75 / 100)。这意味着推理强度不是一个解码参数,而是 prompt 内容的一部分;第三方部署若自行拼 prompt,拿到的强度可能与官方 API 不同。Recipe 与官方 API 对齐的,不只是协议格式,还包括这类影响效果的隐式开关。工具调用则用 DSML 标签而不是 JSON——不是为了好看,而是为了让工具调用在 token 层可以被 special token 精确界定,配合前面的防注入与流式 KMP 增量匹配。
这些设计不直接提升 GPU 吞吐,但决定了首 token 延迟和API 兼容性——对第三方部署来说,后者往往比前者更难对齐。
九、代码与硬件:几个可核验的细节
这一节的内容和前面的「推算」不同,是从公开仓库代码里能直接看到的观察。
9.1 vLLM 血统,但热路径几乎重写
DeepInfer 的整体结构沿袭 vLLM,仓库里有 21 个文件头写着 Derived from vLLM; modified by DeepSeek。README 也承认最初基于 vLLM 构建,还参考了 SGLang 和 TensorRT-LLM。仓库规模大约 5.5 万行 Python + 2500 行 C++,另外挂了六个子模块:FlashMLA、DeepGEMM、DeepEP、DeepSelect,以及后两者的昇腾版本。代码里还留着大约 1900 行中文注释,没有做清理——这反而成了「线上那一份」的佐证。
但热路径几乎全部换掉:
- 调度器、块管理器、序列状态这些核心逻辑重写到 C++,通过 pybind 暴露给 Python,调度时释放 GIL;
- CPU 在还不知道第 N 步接受了哪些 draft token 时,就要排第 N+1 步的 batch,所以 CPU 只定总预算,每个请求的具体长度由 GPU 上的 TileLang kernel 算,结果写回 pinned 内存;
- 前向和采样的 launch 路径上有一个守卫:一旦代码出现隐式 CPU 到 GPU 同步,就直接报错。
最后这个守卫,是整段代码观察里最有分量的一处。异步调度一节讲的是「GPU 全程无空闲」的目标,而这个守卫把它固化成了正确性约束——任何不小心引入 .item()、.cpu() 一类隐式同步的改动,都会立刻失败,而不是悄悄退化成性能回归。
把性能要求变成正确性要求,这是很典型的工程手段。
9.2 EPLB 的目标函数,和开源版不一样
公开的 EPLB 仓库优化的是平均负载;线上这版优化的是「历史窗口内每步最大负载之和」。
这个差异值得单独标注:前者让整体更均衡,后者直接压每一步的最慢 rank。而同步并行里,一步的耗时由最慢 rank 决定。所以线上版能把 moe_lb 压到 1.05~1.09,指标和优化目标是一致的。
照抄开源 EPLB 仓库的实现,并不等于拿到线上这套策略。
9.3 代码揭示的模型结构
代码里能看到的模型结构,比 Blog 更具体:
- 两类注意力层:一类纯滑动窗口(窗口 128);另一类压缩 KV + 稀疏 Indexer,用 top-k 选择;
- 跨层共享:多层可以共用同一个来源层的 KV 和 Index;
- 候选块机制:某一层先选出一批候选块,后面的层只在这些块里做 top-k,相当于分层稀疏;
- YOCO:后半部分的层是消费者层,滑窗 KV 由共享隐状态投影得到,从不持久化,靠 Prefill 重放重建;
- Engram:哈希 n-gram 嵌入表,默认放主机内存,用 RDMA 远程读取;代码注释里写着 InfiniBand 的
sl2留给 KV Cache 流量隔离,Engram 用sl3; - mHC:多路残差主干,用 Sinkhorn 做混合;
- MoE:384 个路由专家,EPLB 会加冗余副本,所以性能图上写的是 384+64 和 384+32;图像 token 有单独的路由偏置。
sl2 / sl3 这个细节很容易漏掉:两类流量在 InfiniBand 上做了服务等级隔离。自建部署如果不做同样的 SL 划分,n-gram 表的远程读取会和 KVCache 换入抢带宽,直接打在 TTFT 上。
9.4 确定性采样
采样不维护任何随机数状态,而是用 SplitMix64 对序列种子和位置做哈希得到随机数,再反查 CDF。这样采样结果和 batch 里有谁、顺序如何都无关。配合 batch-invariant 的 kernel,开一个环境变量就能让同样的输入在任何 batch 组成下出同样的结果。
这解决的是一个长期困扰线上服务的工程痛点:批次不确定性。常规实现里,随机数状态随 batch 推进,同一条请求落在不同 batch 组成中会得到不同输出,导致线上问题无法复现、A/B 实验无法对齐、回归测试无法断言。把随机数改为 hash(序列种子, 位置) 的纯函数,采样结果只依赖请求自身——这是把「可复现性」做进架构。
注意:它需要 batch-invariant kernel 配合才成立。前向本身的数值也不能随 batch 形状漂移。
9.5 昇腾 950:不是口号
公开 README 列出的目标硬件是 NVIDIA SM100 与 昇腾 950,工具链分别是 CUDA 13 与 CANN 9.2。SM100 对应 Blackwell 代际;64~128 卡单一 NVLink 域的组织方式,也与 Blackwell 超节点(如 GB200 NVL72 一类)的形态吻合。但这是「当前公开版本的目标硬件」,不等于 DeepInfer 普遍支持所有 NVIDIA GPU 或所有昇腾型号;落地前仍需逐项核对设备型号、驱动、编译器与依赖版本。
但昇腾适配的深度,从代码量能看出来:
- 昇腾版的 TileLang kernel 约 7,400 行,比 CUDA 版的 5,000 行还多;
- 昇腾的归一化算子刻意和训练框架
hai-llm做了逐位数值对齐,保证训练和推理数值一致; - 代码里有
TODO(A5)这样的标记,A5看起来是 950 的内部代号。
代码量反超 CUDA 版,是判断「异构兼容是真做还是口号」的硬证据。更关键的是归一化算子与训练框架逐位对齐:这意味着昇腾路径上的推理数值与训练一致,不是「跑得通」,而是「跑得准」——对国产卡部署而言,这比吞吐数字更难做到。
9.6 开源版与内部版的差距
公开材料很诚实地披露了差距:
- FlashMLA 少了一个硬改 SASS 的优化,decoding 算子慢 5%~10%;
- Draft Model 内部版比开源版新一些,但性能差别不大;
- KVCache 管理与负载均衡组件与内部基础设施耦合较深,代码目前尚未完整开源。
端到端性能差最多 5%,因为算子级的差距被其他环节摊薄了。这个「最多 5%」是公开口径,实际差距取决于你的负载与硬件;不要把它当成精确承诺。
这给使用开源 DeepInfer 的开发者一个重要的性能预期:拿到代码,不等于拿到线上那一份。但反过来说,能开源的这部分已经覆盖了绝大多数架构与算子,剩下的是基础设施耦合与手工优化。
十、成本与边界:94% 毛利是怎么算出来的,以及哪些假设不能崩
最后回到钱。
10.1 单卡小时的成本结构
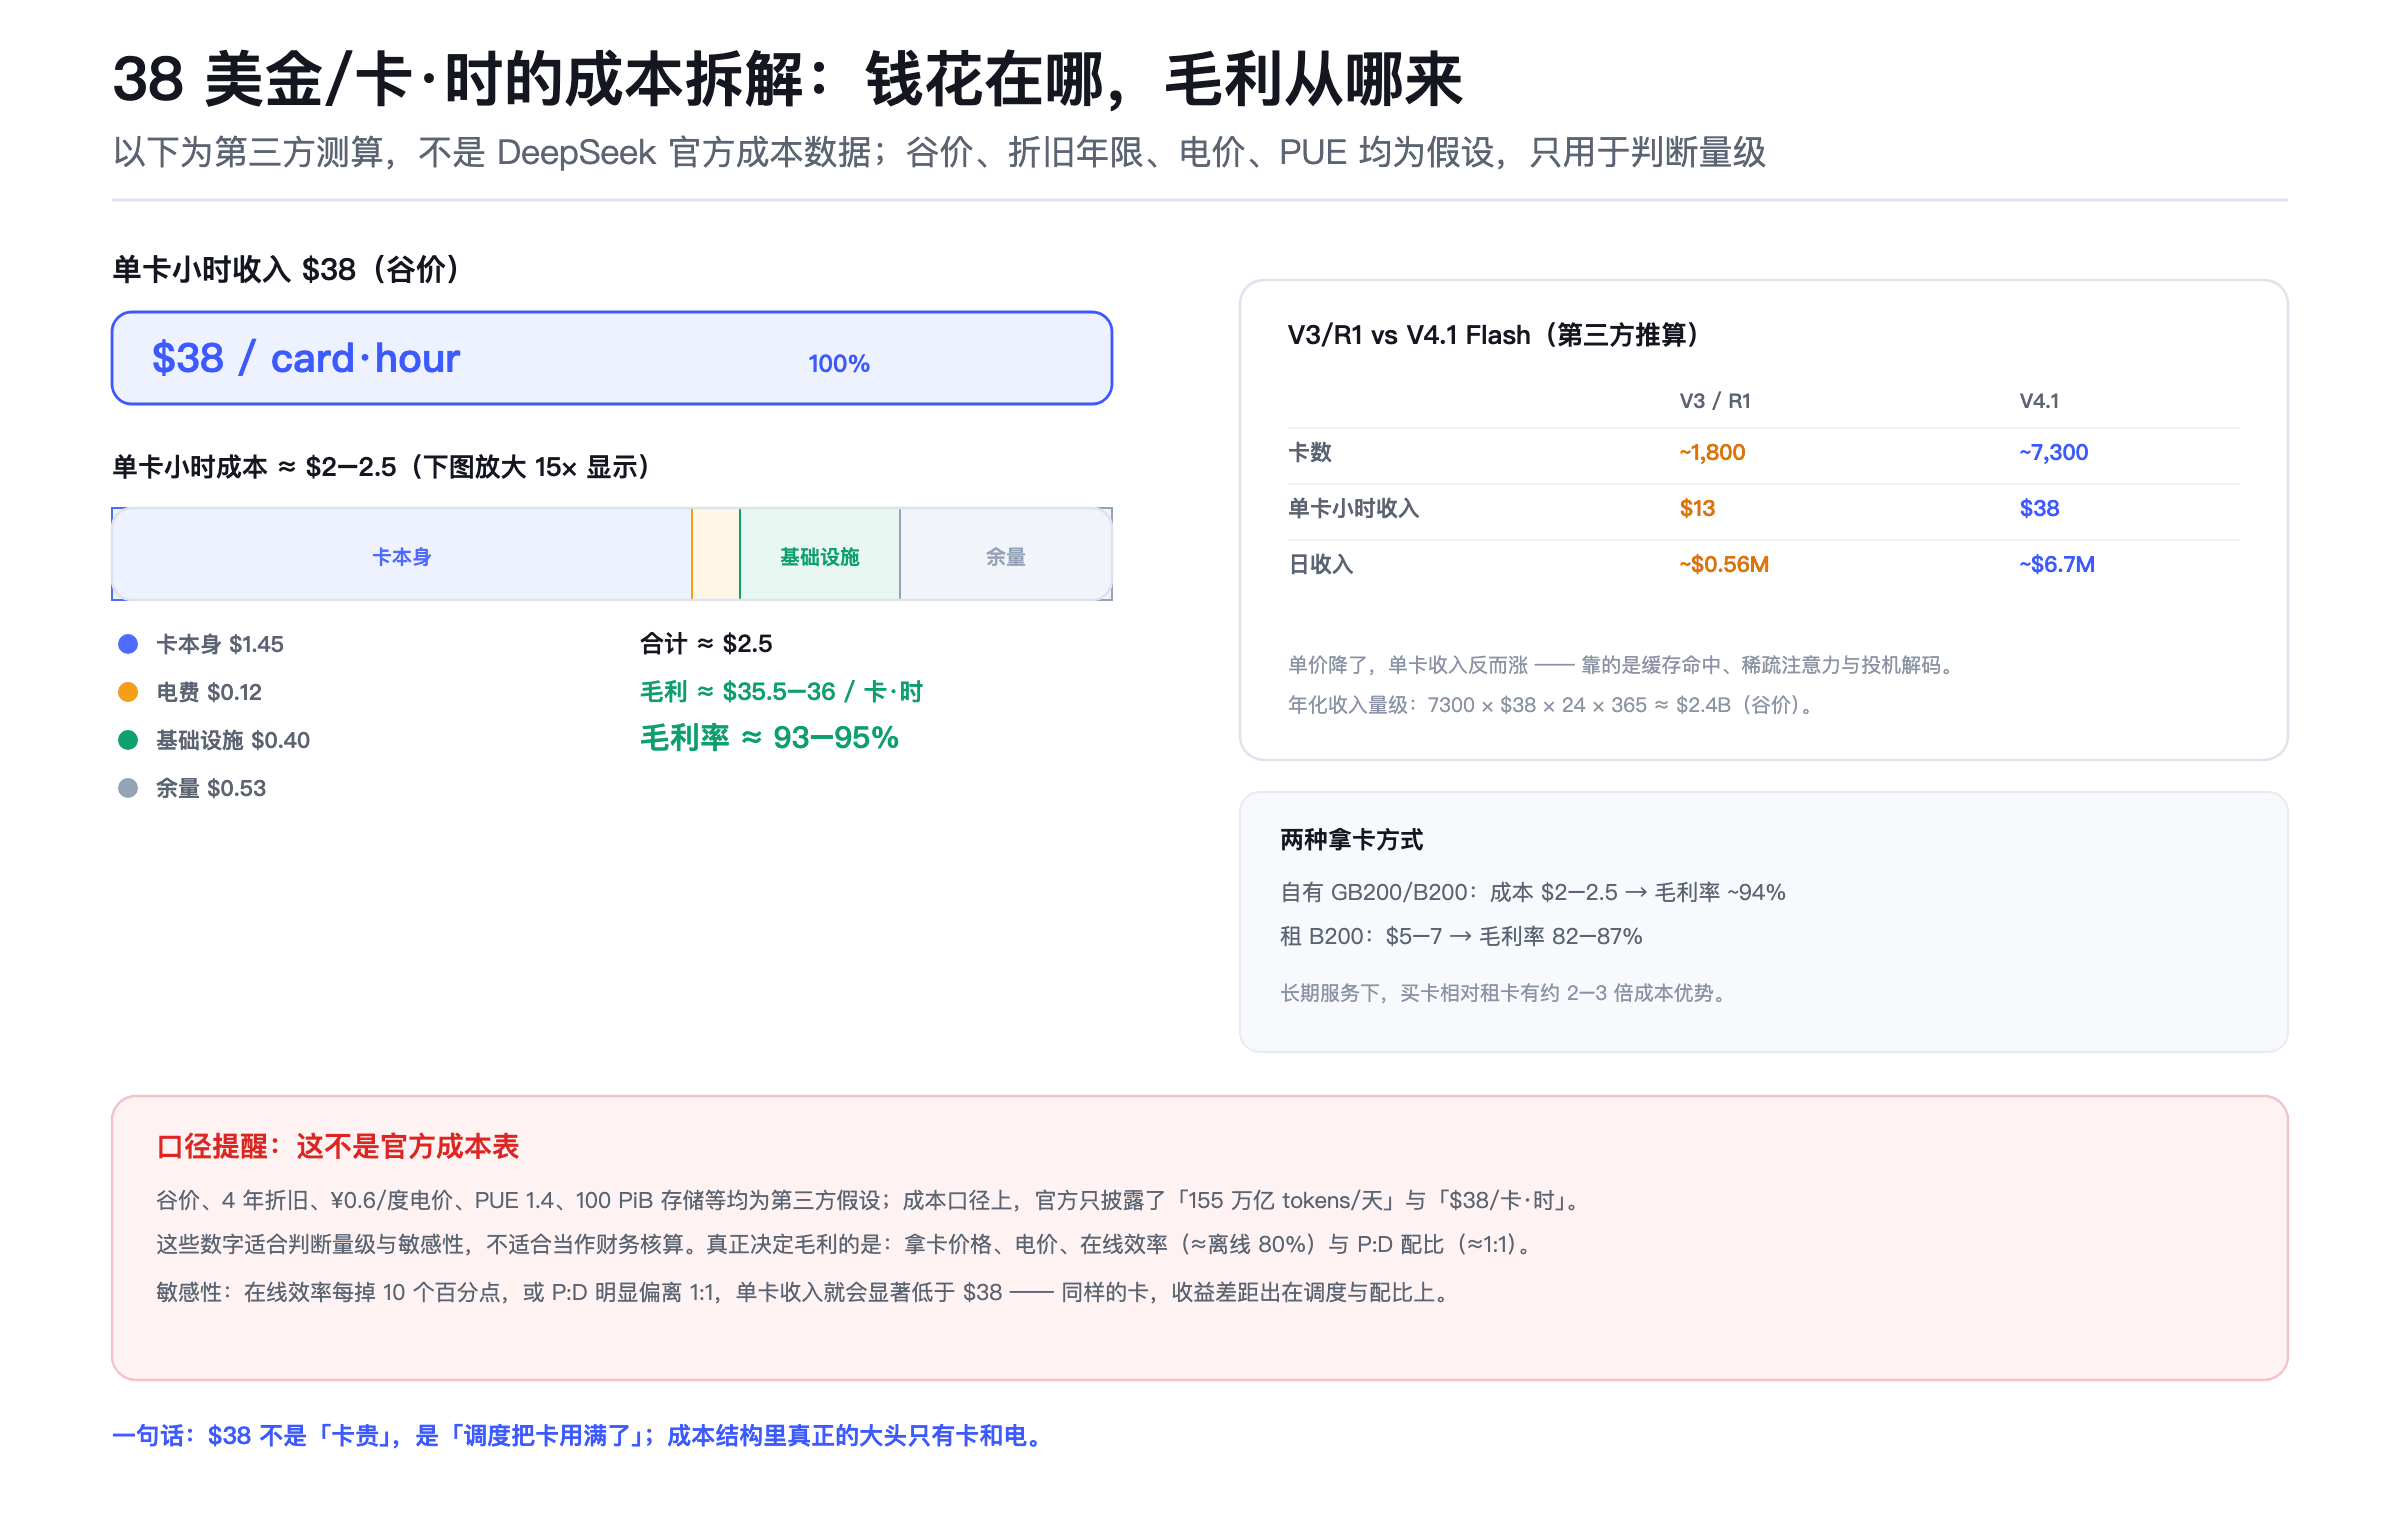
按第三方测算,自有 GB200/B200 的单卡小时成本大致是:
| 项目 | 成本(美元/卡·时) | 说明 |
|---|---|---|
| 卡本身 | 1.3 ~ 1.6 | NVL72 约 $300 万 / 72 卡,4 年折旧 |
| 电费 | ≈ 0.12 | 1.4 kW 含 PUE,¥0.6/度 |
| 机房、网络、3FS 存储、运维 | 0.3 ~ 0.5 | 存储摊薄后占比很小 |
| 合计 | ≈ 2 ~ 2.5 |
对 $38 的收入,毛利率约 93%~95%。如果租 B200,市价 $5~7/卡·时,毛利率降到 82%~87%。
存储成本为什么可以忽略?3FS 那 100 PiB 按 20 盘一台、约 200 台服务器算,是几千万美元量级;摊到每卡每小时不到 $0.05,相对卡本身可以忽略。
回本周期:整个集群硬件投入大约 3~4 亿美元,按谷价收入口径算约两个月回本,按峰价算约一个月。注意这是收入口径,不是净利润口径;它说明的是「满负荷跑起来后,现金流回正很快」,不是「两个月赚回全部成本」。
10.2 对比 V3/R1:单价降了,单卡收入反而涨了
| 指标 | V3 / R1(2025 年 3 月公开) | V4.1 Flash(本次) |
|---|---|---|
| 硬件与成本口径 | H800 按 $2/小时租用 | 自有 GB200/B200,约 $2~2.5/卡·时 |
| 卡数 | 约 1,800 卡 | 约 7,300 卡 |
| 理论日收入 | 约 $56 万 | 约 $670 万 |
| 每卡每小时收入 | $13 | $38 |
| 利润口径 | 成本利润率 545% | 毛利率约 94%(自有) |
在 token 单价已经下降好几倍的前提下,每卡收入反而从 $13 涨到 $38。这不是靠涨价,而是靠单位卡服务的 token 数提升:KVCache 压缩、稀疏注意力、投机解码、异步调度,一层层把「同样的卡能服务多少 token」推上去。
反过来,自下而上也能对上这个数:
Decode:每卡离线约 15.7k tok/s,取线上 80% ≈ 12.6k
        → 45M output/h × $0.60/M ≈ $27/h
Prefill:每卡约 90k tok/s,取线上 80% ≈ 72k
        → 259M 未命中/h × $0.15/M ≈ $39/h
P:D ≈ 1:1 → 平均约 $33~36/h,加上缓存命中部分,落到 $38 附近
两条推法(自上而下的收入/吞吐,自下而上的性能图 × 单价)能互相印证,才让 $38 这个数字不只是「官方口径」,而是一个可以被复算的结果。
10.3 敏感性:$38 不是天上掉下来的
$38 这个数字,依赖两个关键假设:
- 在线效率 ≈ 离线完全均衡的 80%;
- P:D 卡数配比 ≈ 1:1。
如果自建集群的均衡效率只有 60%,或者 P:D 明显偏离 1:1,单卡收入就会显著低于 $38。同样的卡、同样的模型,收益差距出在调度与配比上。
这也是这套系统最值得学的地方:它不是靠某一颗「神芯」或某一个「神算子」,而是靠计算、通信、调度、缓存四件事的协同,把每一张卡的利用率推到了接近极限。
口径提醒:本节数字属于基于公开披露的第三方测算。谷价、4 年折旧、¥0.6/度电价、PUE 等均为假设输入,不是 DeepSeek 官方成本数据;适合用于判断量级,不宜当作精确核算。
十一、写在最后:如果只抄三件事
把这篇长文压缩成三句话:
第一,按阶段选并行。 先用 roofline 判断这个阶段是 compute-bound 还是 memory-bound,再决定 EP 大小。Prefill 小 EP、Decode 大 EP,不是偏好,是物理。
第二,按复用距离建缓存。 HBM 放热数据,本机内存放会话窗口,3FS 放跨请求前缀。不要把所有东西都塞进一个层级;也不要把只在分钟级复用的东西,硬存 7 天。SWA Bounded Replay 的 128-token 近似,就是「用计算换存储」的极致案例。
第三,把调度做成时间函数。 chunk size 不该是固定值,而该由「时间预算 + 二次代价模型」反解;CPU 与 GPU 的流水线要 overlap;性能约束要固化成正确性守卫。做到这三条,才能把「在线 80%」守住。
如果你正在自建推理集群,可以用下面几个数字对标:
| 指标 | 可对标值 | 含义 |
|---|---|---|
| 在线 / 离线效率 | ≈ 80% | 动态负载相对完全均衡的损耗 |
EPLB moe_lb | 1.05 ~ 1.09 | 最慢 rank / 均值 |
| SWA KVCache 命中率 | > 98% | 会话窗口的复用程度 |
| 整体 KVCache 命中率 | ≈ 85% | agent 流量的典型水平 |
| P:D 卡数配比 | ≈ 1:1 | 两阶段资源配比 |
最后,用一句话收尾:
模型决定能力的天花板,推理系统决定成本的地板。 155 万亿 tokens/天和 $38/卡·时之所以值得讨论,不是因为数字大,而是因为它们证明了一件事——把计算、通信、调度、缓存放在一起设计,单位算力的产出还可以再上一个台阶。
参考资料
- DeepSeek V4.1 Flash 推理系统知乎 Blog:https://zhuanlan.zhihu.com/p/2095560295930508953
- DeepSeek V4.1 Flash 推理系统 Q&A(本文技术细节的主要来源)
- DeepInfer 开源仓库及 README(目标硬件、构建环境、性能图)