先说个数
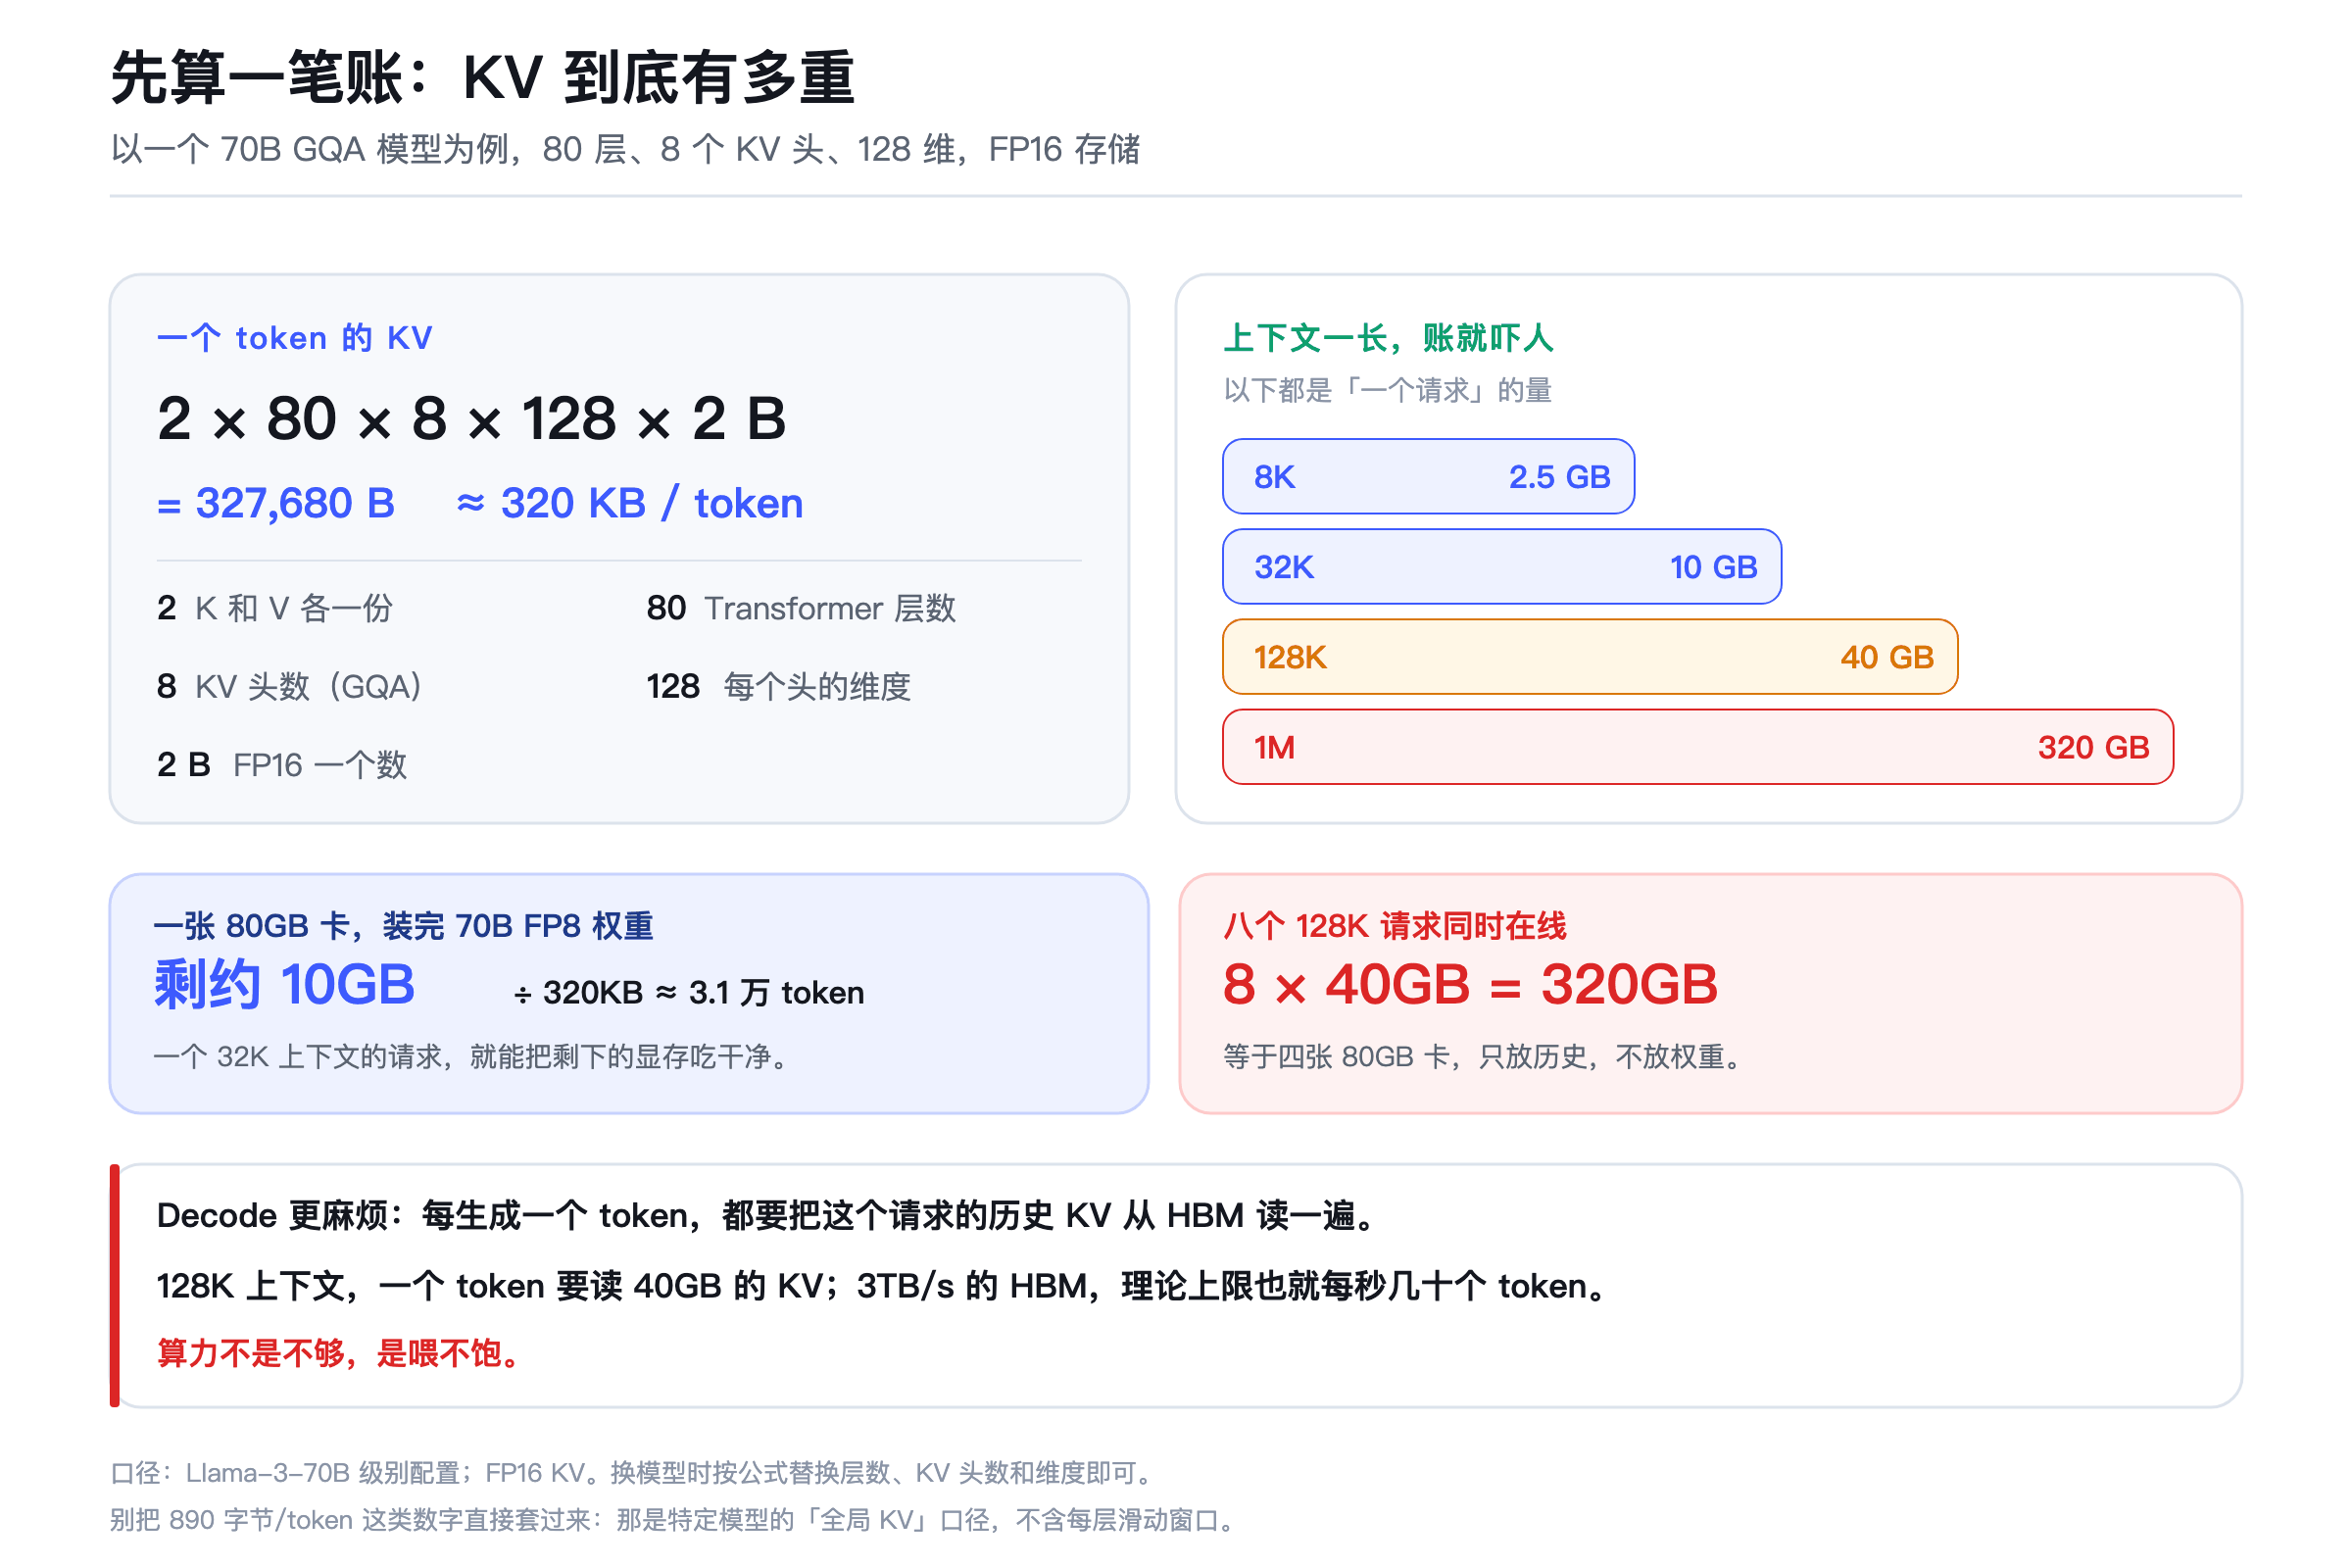
一张 80GB 的卡,装 70B 模型的 FP8 权重,大概 70GB 就没了。剩下 10GB,按每个 token 320KB 的 KV 算,只够 3 万 token。一个 32K 上下文的请求,基本就能把这张卡占满。
我第一次按这个公式乘的时候,也愣了一下。平时聊模型,张口就是参数量、上下文长度、每秒多少 token;很少有人先问一句:这 128K 的上下文,KV 要占多少显存?
如果你只是调 API,这笔账由厂商替你算;一旦自己部署,或者在算单位 token 成本,它就躲不开。
这笔账怎么算
Transformer 生成文本,是一个 token 一个 token 往外蹦的。每蹦一个,都要回头看前面所有的 token。为了不重复算,推理引擎会把每一层、每个 token 的 Key 和 Value 存下来,这就是 KV Cache。
公式很土:
KV 字节数 ≈ 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每个数占的字节
拿 Llama-3-70B 这类模型:80 层,8 个 KV 头,头维度 128,KV 用 FP16。一个 token 就是 2 × 80 × 8 × 128 × 2 = 327,680 字节,约 320KB。
320KB 听起来不多。乘上长度就不一样了:8K 是 2.5GB,32K 是 10GB,128K 是 40GB,1M 是 320GB。注意,这是一个请求。八个 128K 请求同时在线,光 KV 就是 320GB,四张 80GB 的卡什么都不干,只放历史。
模型权重是固定的,KV 却跟着请求长。权重可以量化、切分、多卡摊;KV 不行,每个请求一份,聊得越久越大。
所以长上下文服务先撞上的,往往是显存,不是算力。再往下是带宽:Decode 每生成一个 token,都要把这个请求的历史 KV 从 HBM 读一遍。128K 时,一个 token 就是 40GB 的搬运量。3TB/s 的 HBM,除一下,单请求理论上限也就每秒几十个 token。批量一大,这点带宽还要分给更多请求,GPU 大部分时间在等数据。
再往后是账单。Agent 场景里,系统提示词、工具描述、长文档反复用。缓存命中,Prefill 跳过;不命中,几万 token 重算。命中率差一点,账单差一截。
Prefill 和 Decode 的区别,这里值得停一下。Prefill 像把一本书通读一遍、做笔记,算力密集,决定首 token 等多久;Decode 像合上书,凭笔记一个字一个字往下写,每写一个字都要翻一遍笔记,访存密集。KV 就是那本笔记。笔记越厚,翻得越慢。
所以 KV 优化,说穿了就三件事:少记一点,少翻一点,同一份笔记多给几个人用。
八层优化,我只看这几件
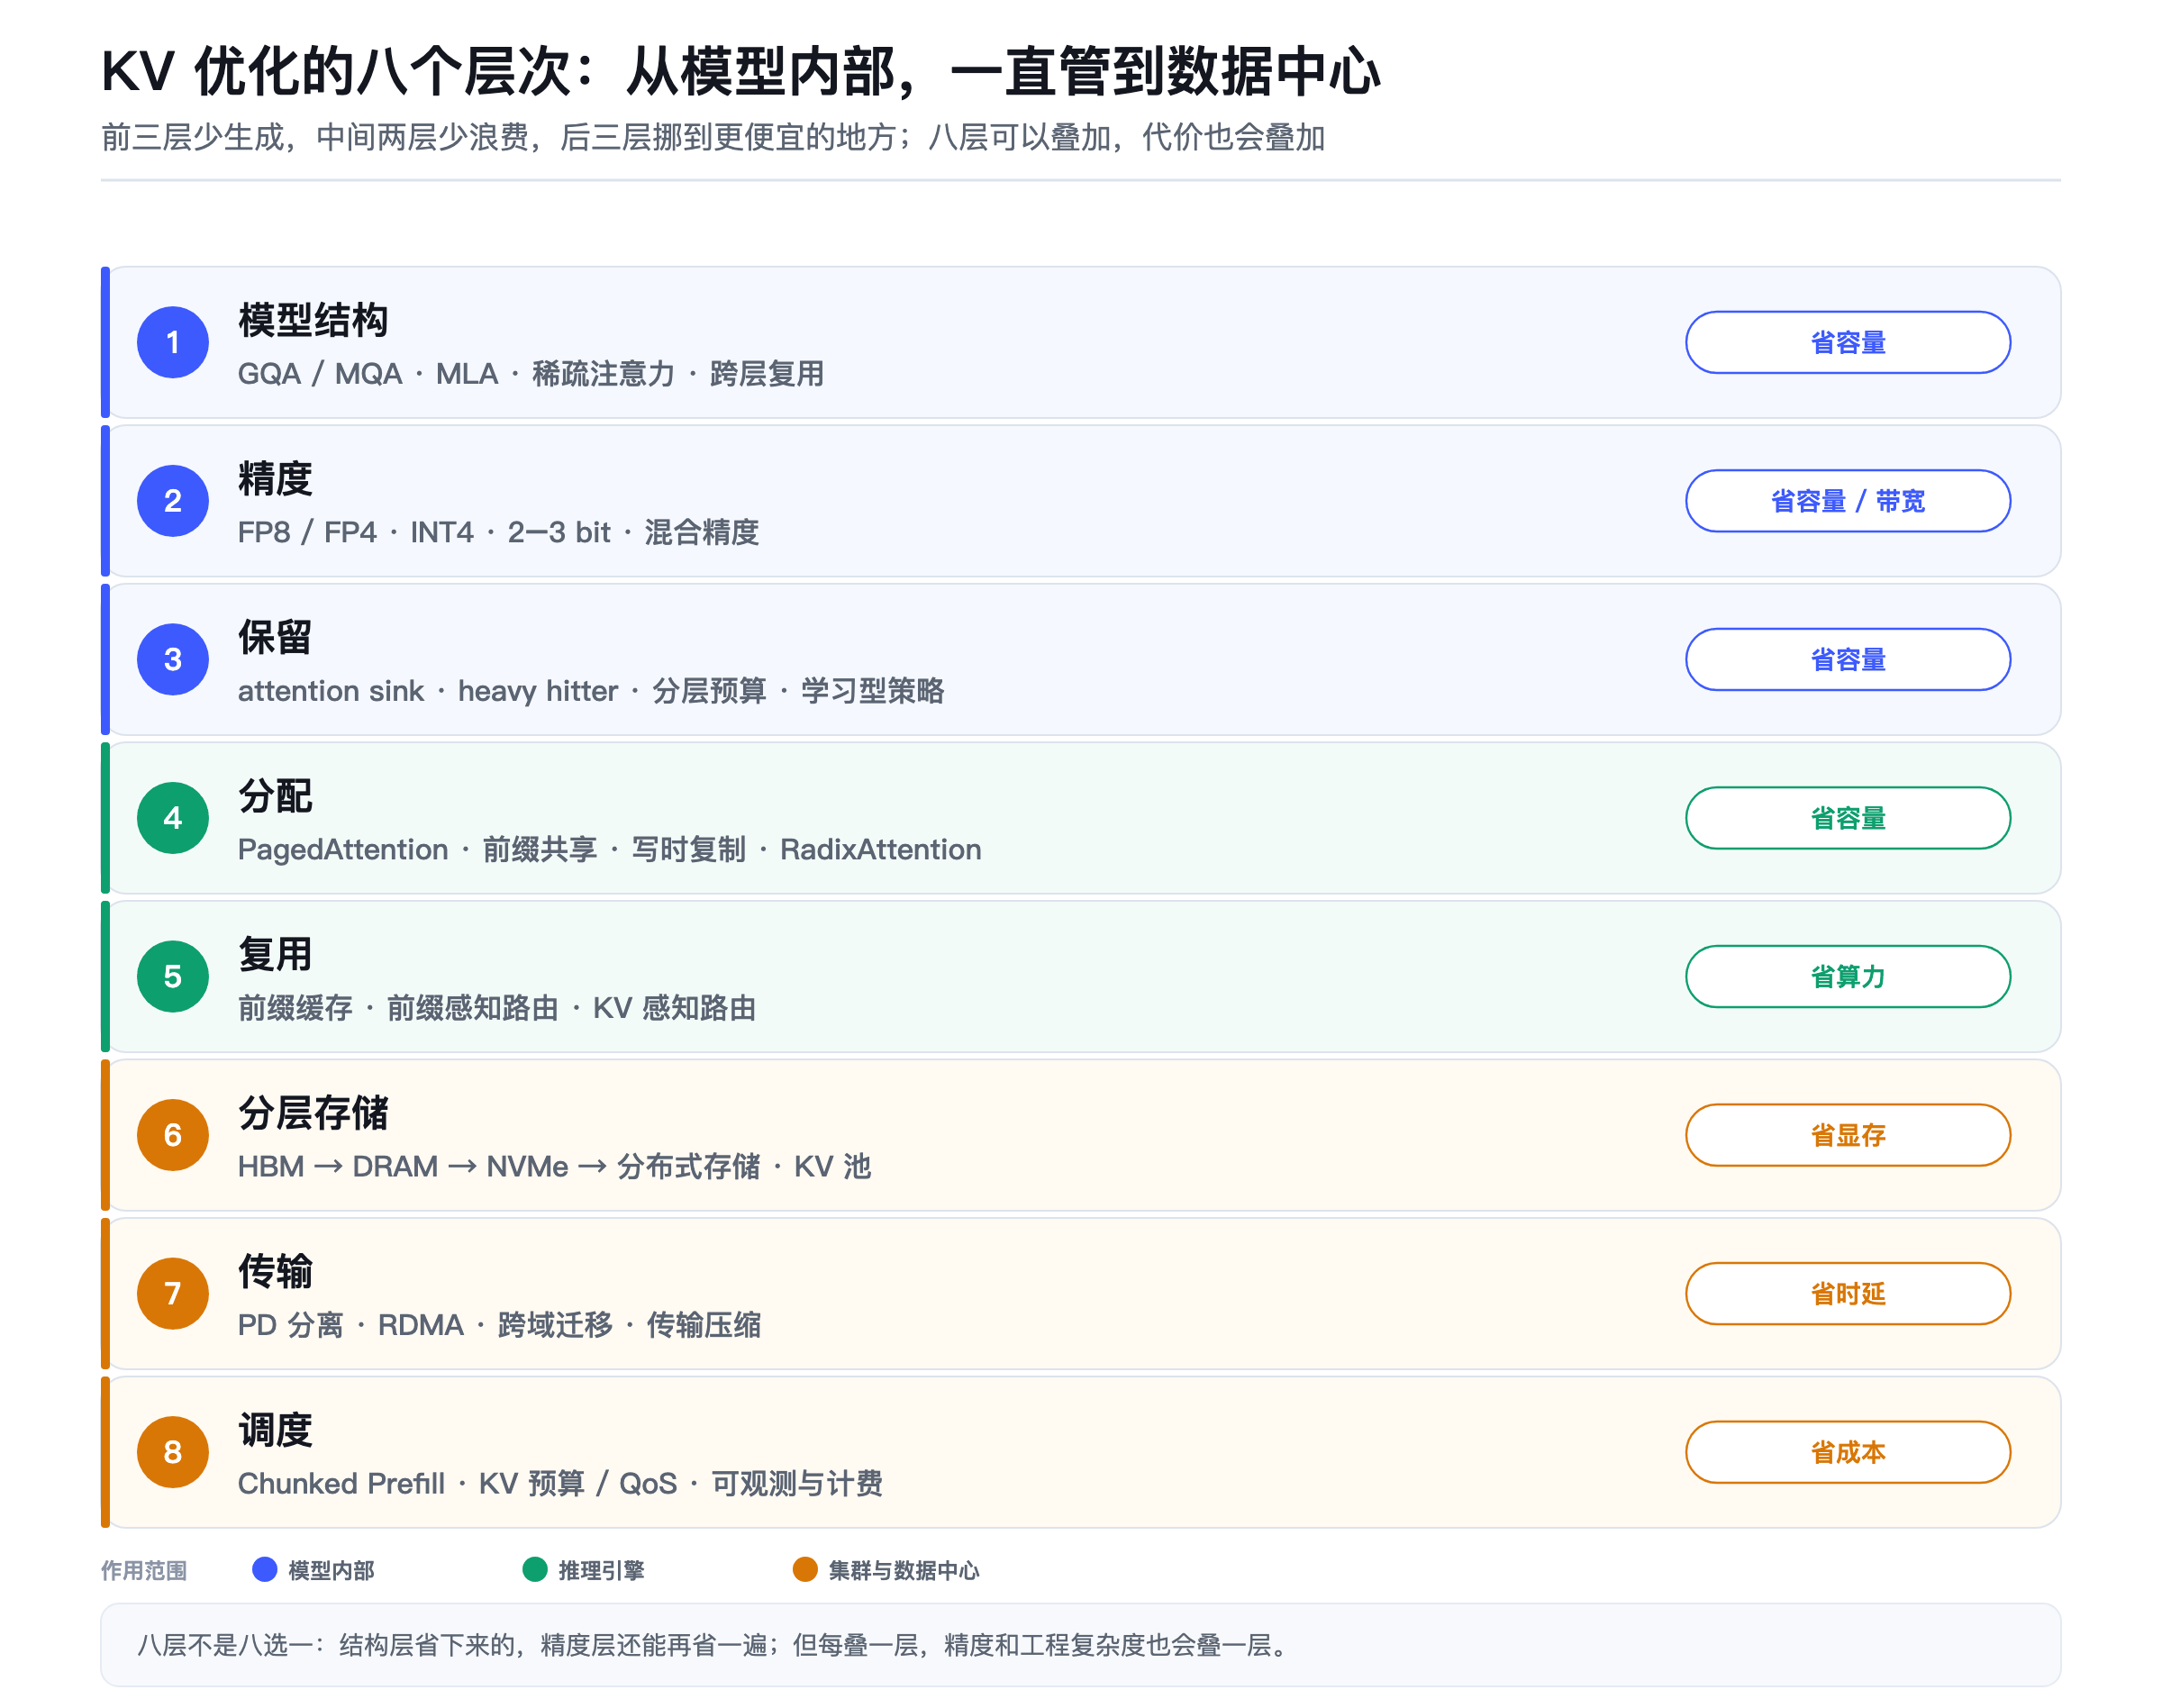
业界常把 KV 优化分成八层:模型结构、精度、保留、分配、复用、分层存储、传输、调度。听着像教科书目录。真到线上,不是每一层都值得你花时间。下面按我觉得的性价比排,不按论文目录排。先放一张全景图,后面挑着说。
改模型:最划算,但轮不到你决定
如果模型是你自己训的,第一刀肯定砍在结构上。模型改一次,所有请求都受益。
最常见的是 GQA/MQA:多个 Query 头共用一组 K/V,把 KV 头数从几十降到 1 个或几个。可以想成一个部门共用一本会议记录,而不是每个人各记一份。GQA 是现在的默认折中,精度掉得不多,显存能降好几倍。
再进一步是 MLA。DeepSeek 系列把 K/V 联合投影到一个低维 latent,只存压缩后的向量,用的时候再解压。以前每个头各存一本账,现在每层共用一本压缩账本。大致上,它把 KV 从“按头存”变成了“按低秩向量存”。
还有两条路:一条是稀疏注意力,每个 token 只看 Top-K 个历史位置,比如 DSA、NSA;另一条是跨层复用,后面的层直接拿前面层算好的全局 KV 和索引,不每层重抄。DeepSeek-V4.1-Flash 的 CSA2 就是后者,Full、Reindex、Reuse 三种模式,有的层全算,有的层只重新打分,有的层直接用前面层的结果。
这些方案听着很香,但有个前提:你得能改模型。大多数团队用的是开源权重或 API,这一层基本只能“选”,不能“改”。所以别一上来就研究 CSA2,先看看你手里的模型是不是 GQA/MLA,KV 头数是不是已经压过了。
V4.1-Flash 把全局 KV 压到了 890 字节/token,相对 V4-Flash 约 1/4,相对初代 V1 约 1/437。这个数字很吓人,但要注意口径:890 字节是全局 KV,每层自己的滑动窗口 KV 还要另算,不是“所有 KV 一共 890 字节”。有些对比图会把这两个口径混在一起。
省 bit:最容易抄的作业
精度这层,是八层里最容易落地的。
FP8 已经是新一代 GPU 的原生格式,几乎零额外开销;FP4 也开始在旗舰模型上出现。V4.1-Flash 的 Main KV 就是 FP4,16 个通道共用一个 scale。FP16 两个字节,FP8 一个,FP4 半个。同一段上下文,换个存储格式,显存直接减半,这种便宜不占白不占。
但 K 和 V 的脾气不一样。K 里常常有少数通道的数值特别大(outlier),适合按通道量化;V 的分布更温和,适合按 token 量化。KIVI 就是这么干的。你要是一视同仁地压,精度会掉得很难看。
再往下是 2~3 bit。LogQuant 用对数分布做 2-bit;Google 的 TurboQuant 用随机正交旋转把数据摊平,再加 1-bit 残差校正,论文里报的是约 3 bit/坐标、6 倍以上内存压缩、H100 上最高 8 倍注意力加速。这些数字都有测试条件,别直接往自己业务上套。但趋势很清楚:4 bit 越来越像默认档,8 bit 反而成了高精度选项。
扔 token:先想好怎么还页
上下文 128K,真正有用的可能只有几 K。这一层就是决定“留谁、扔谁”。
最早是 StreamingLLM 的发现:开头几个 token 像注意力锚点,扔了模型会发懵,所以得一直留着;剩下的按滑动窗口淘汰。后来 H2O 按累计注意力分数,留下那些一直被关注的 token;SnapKV、PyramidKV 按层分配预算,不再所有层一个标准。再往后是用强化学习训练淘汰策略,或者训练一个“保留头”来指导驱逐。
但这层有个坑,我放到后面单独说:逻辑上删掉一个 token,不等于物理上把显存还了。
分页和复用:别让显存里全是洞
PagedAttention 是 vLLM 的基石。它把每个序列的 KV 切成固定大小的 block,逻辑上连续,物理上可以不连续,用一张 block table 做映射。跟操作系统的虚拟内存一个思路:按需分配,别一上来按最大长度预留。
没有分页之前,请求来了就得按“最大可能长度”占一块连续显存,实际用多少不知道,碎片和浪费都很严重。vLLM 论文里说,旧系统的 KV 浪费能到六到八成;分页之后能压到个位数。这不是小数目。
再往上是前缀共享:相同的系统提示词、相同的 few-shot 样例,共享同一批 block,只在分支处 copy-on-write。RadixAttention 用基数树把共享前缀组织起来,自动找最长公共前缀,这是 SGLang 的核心机制。
PagedAttention 关心“装得下”,RadixAttention 关心“复用得多”。两者现在也在互相借鉴。
存储、传输、调度:把 KV 当数据看
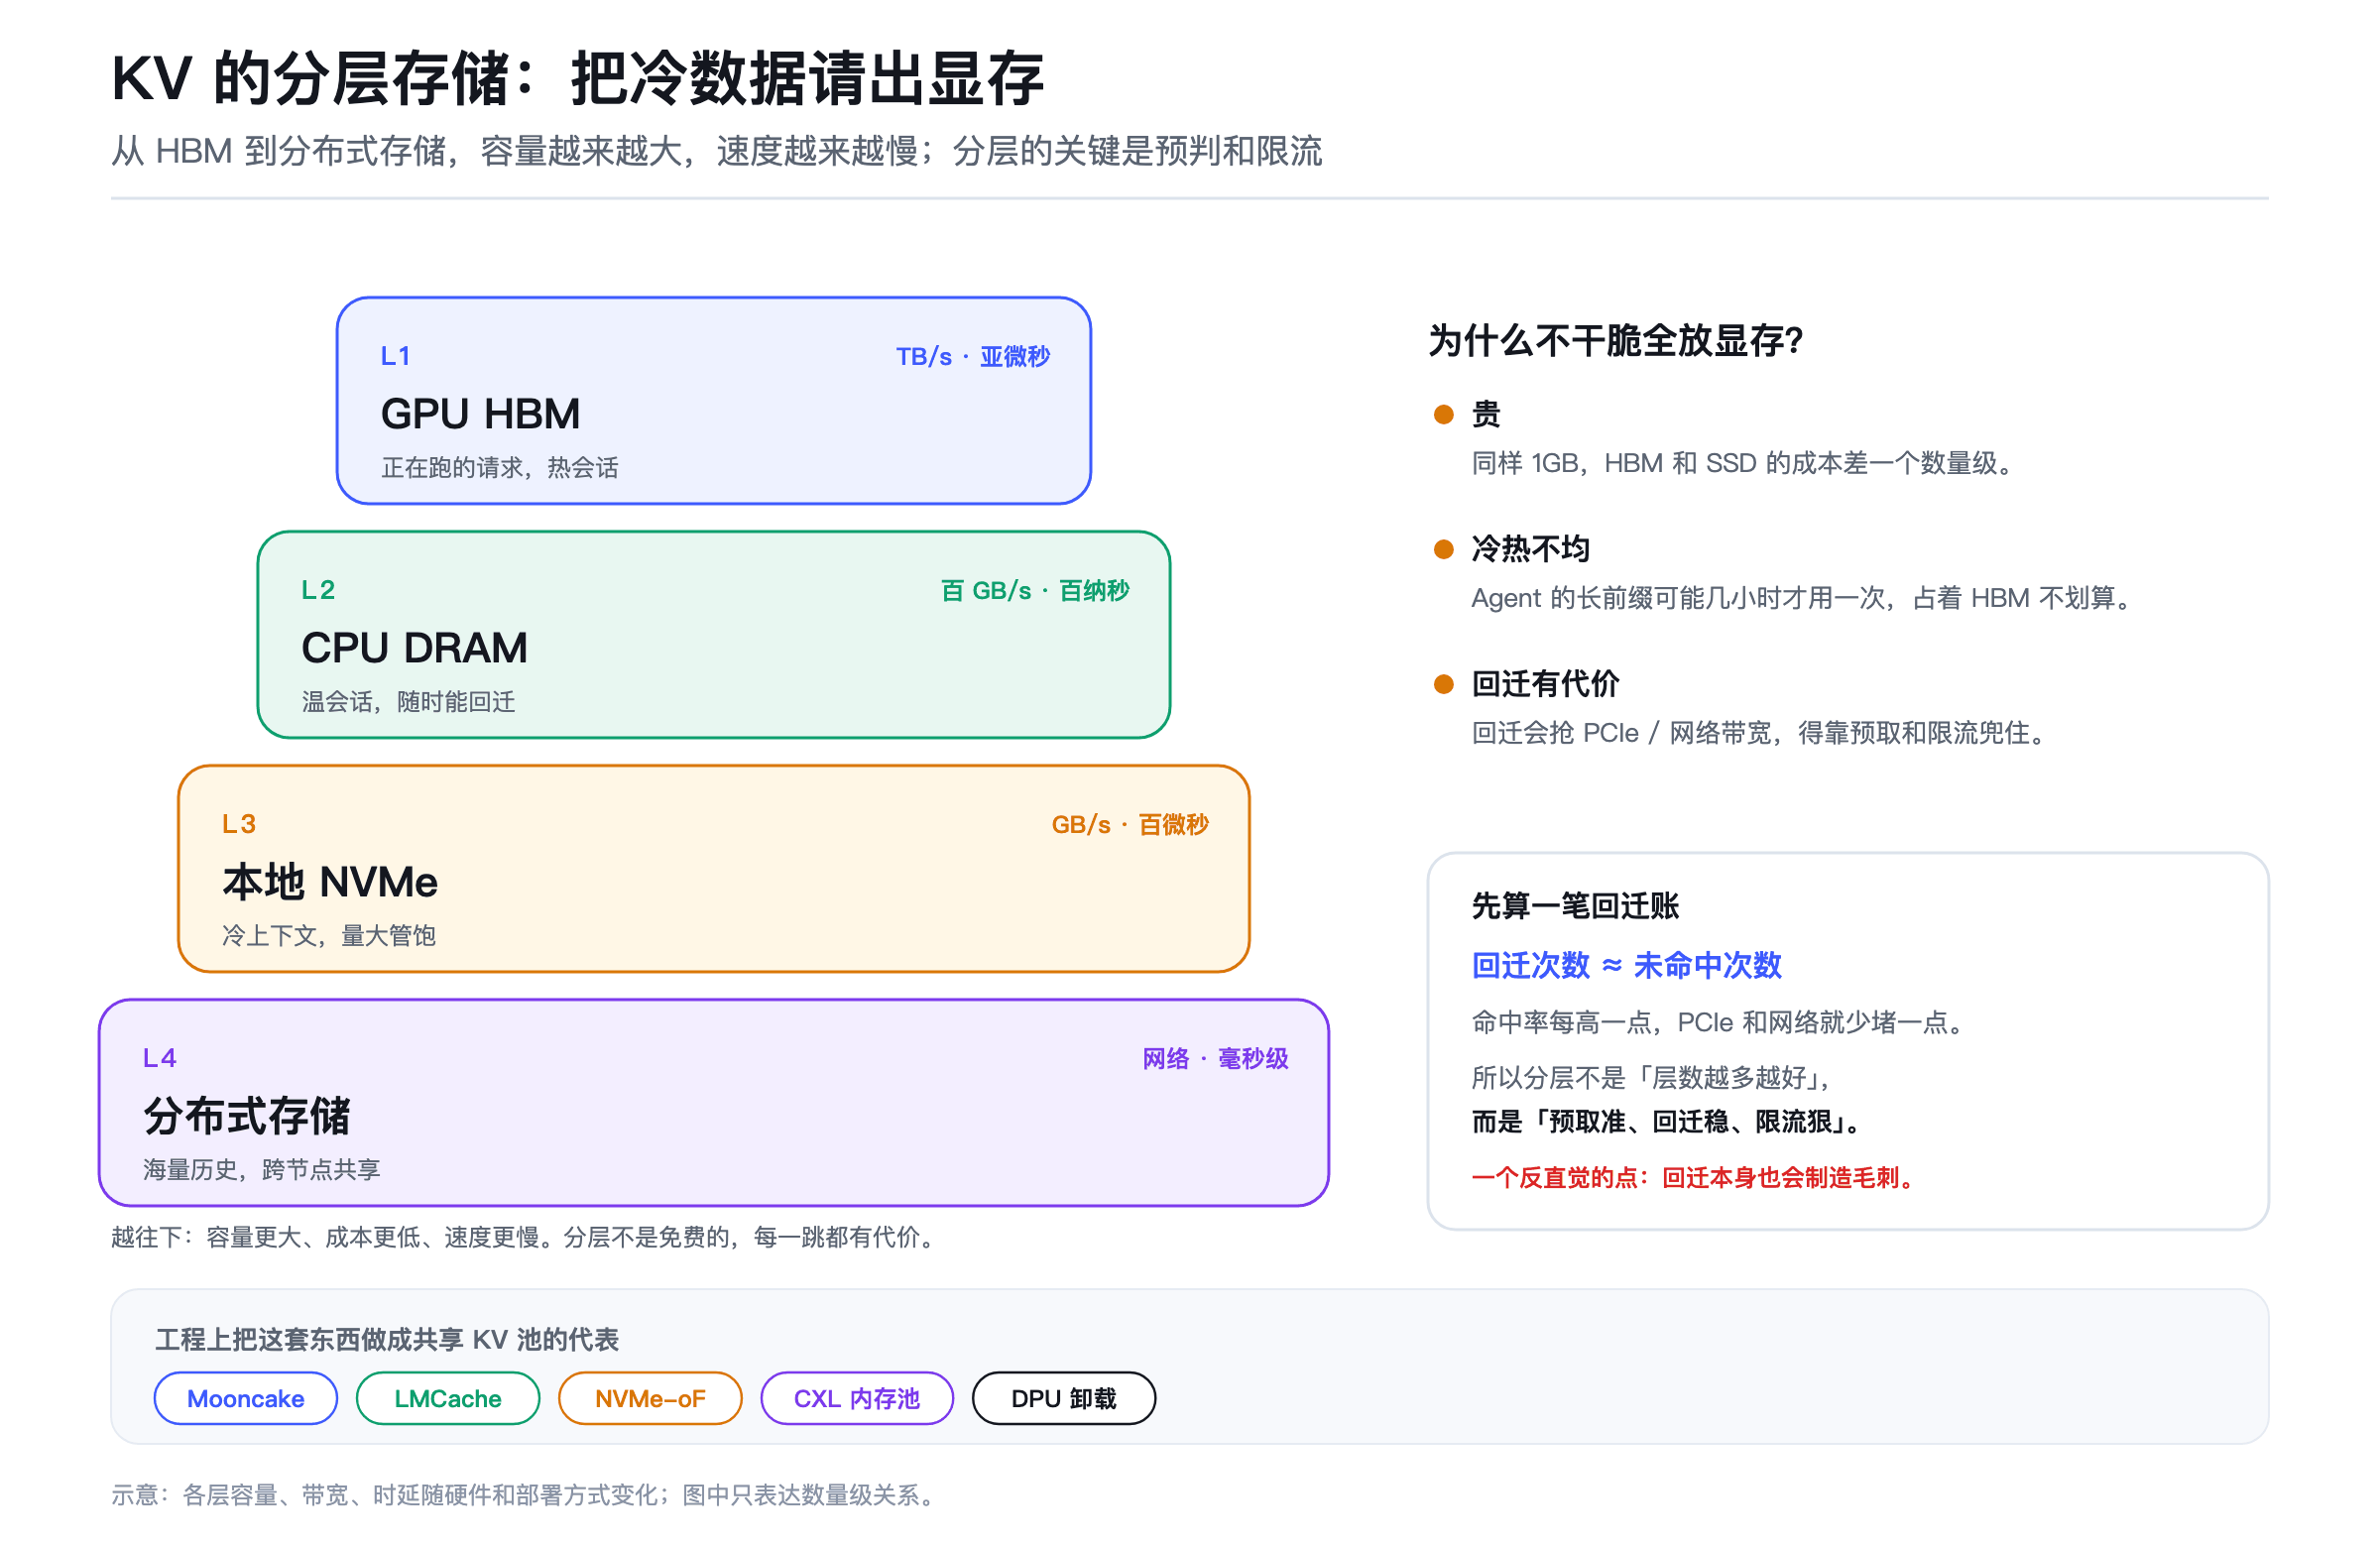
显存装不下,就往更便宜的介质上放。GPU HBM 放热会话,CPU DRAM 放温会话,本地 NVMe 放冷上下文,分布式存储放海量历史和跨节点共享。Mooncake 是这层的代表,以 KVCache 为中心的分离式架构,P2P Store 做节点间共享,Mooncake Store 做分布式 KV 池。LMCache 则把 KV 从“引擎内部状态”变成可以 offload、可以传的数据,配合 vLLM 在多轮问答、文档分析里报过最高十几倍的吞吐提升。特定场景的数字,但方向没问题。
硬件也在往这走:NVMe-oF 把远端盘访问压到百微秒以内;BlueField-4 这类 DPU 在网卡侧做 KV 的加密、校验和搬运,不占主机 CPU;CXL 内存池让多个节点共享同一份 KV,少存几份副本。这四层大概是这么个关系:
传输这层,主要是 PD 分离带来的。Prefill 池算完,把 KV 传给 Decode 池。Prefill 计算密集,Decode 访存密集,绑在一起互相拖累;拆开各自扩缩容,代价是 KV 要在网络上跑一趟。专用 Transfer Engine、RDMA 零拷贝、批量搬运、计算和 IO 重叠,都是为了让这趟路别太慢。再远一点,Prefill-as-a-Service 把长上下文 Prefill 放到独立集群,算完把 KV 经普通以太网传回本地 Decode 池。
传还是重算,有个很实用的判断:看链路速度和算力的比值。链路够快、算力够贵,传划算;链路一慢,重算反而便宜。Mooncake 给过一个粗略判据,核心就是这个比价。别迷信“一定要传”,先算账。
调度这层最“软”,也最容易被低估。Chunked Prefill 把长 Prefill 切块,和 Decode 交错执行,避免一个长请求把其他短请求饿死;KV 预算和 QoS 给每个租户、每个业务设配额和优先级,防止低优请求把高优会话挤掉;再往上就是可观测和计费:命中率、回迁次数、分层命中分布、每 token 的 KV 成本。这些指标以前没人看,现在慢慢成了推理服务的 KPI。
八层不是八选一。结构层省下来的,精度层还能再省一遍;但每叠一层,精度和工程复杂度也会叠一层。
几个容易踩的坑
删了,但没释放
这是最隐蔽的一个。
很多驱逐算法在逻辑上把 token 删了,注意力也不再算它,但分页块里的位置还占着。一个 block 里删掉一半 token,剩下的一半还占着整块;尾部那些“全空”的 block,如果没人整理,也不会被 free 掉。
结果就是:有的方案里写“KV 降了 70%”,上线一看显存只降了两成。
NVIDIA 在 TensorRT-LLM 里集成的 TriAttention 把这个问题挑明了。它不靠当前这一小批 query 的注意力分数拍脑袋,而是用离线校准出的、每个注意力头在 RoPE 之前的 query 均值和幅值来打分;然后定期把幸存 token 物理搬移、合并成一段连续区域,让尾部 block 真正能释放。它保留 prompt 前缀,只压缩生成阶段的后缀,也是为了不破坏前缀复用。
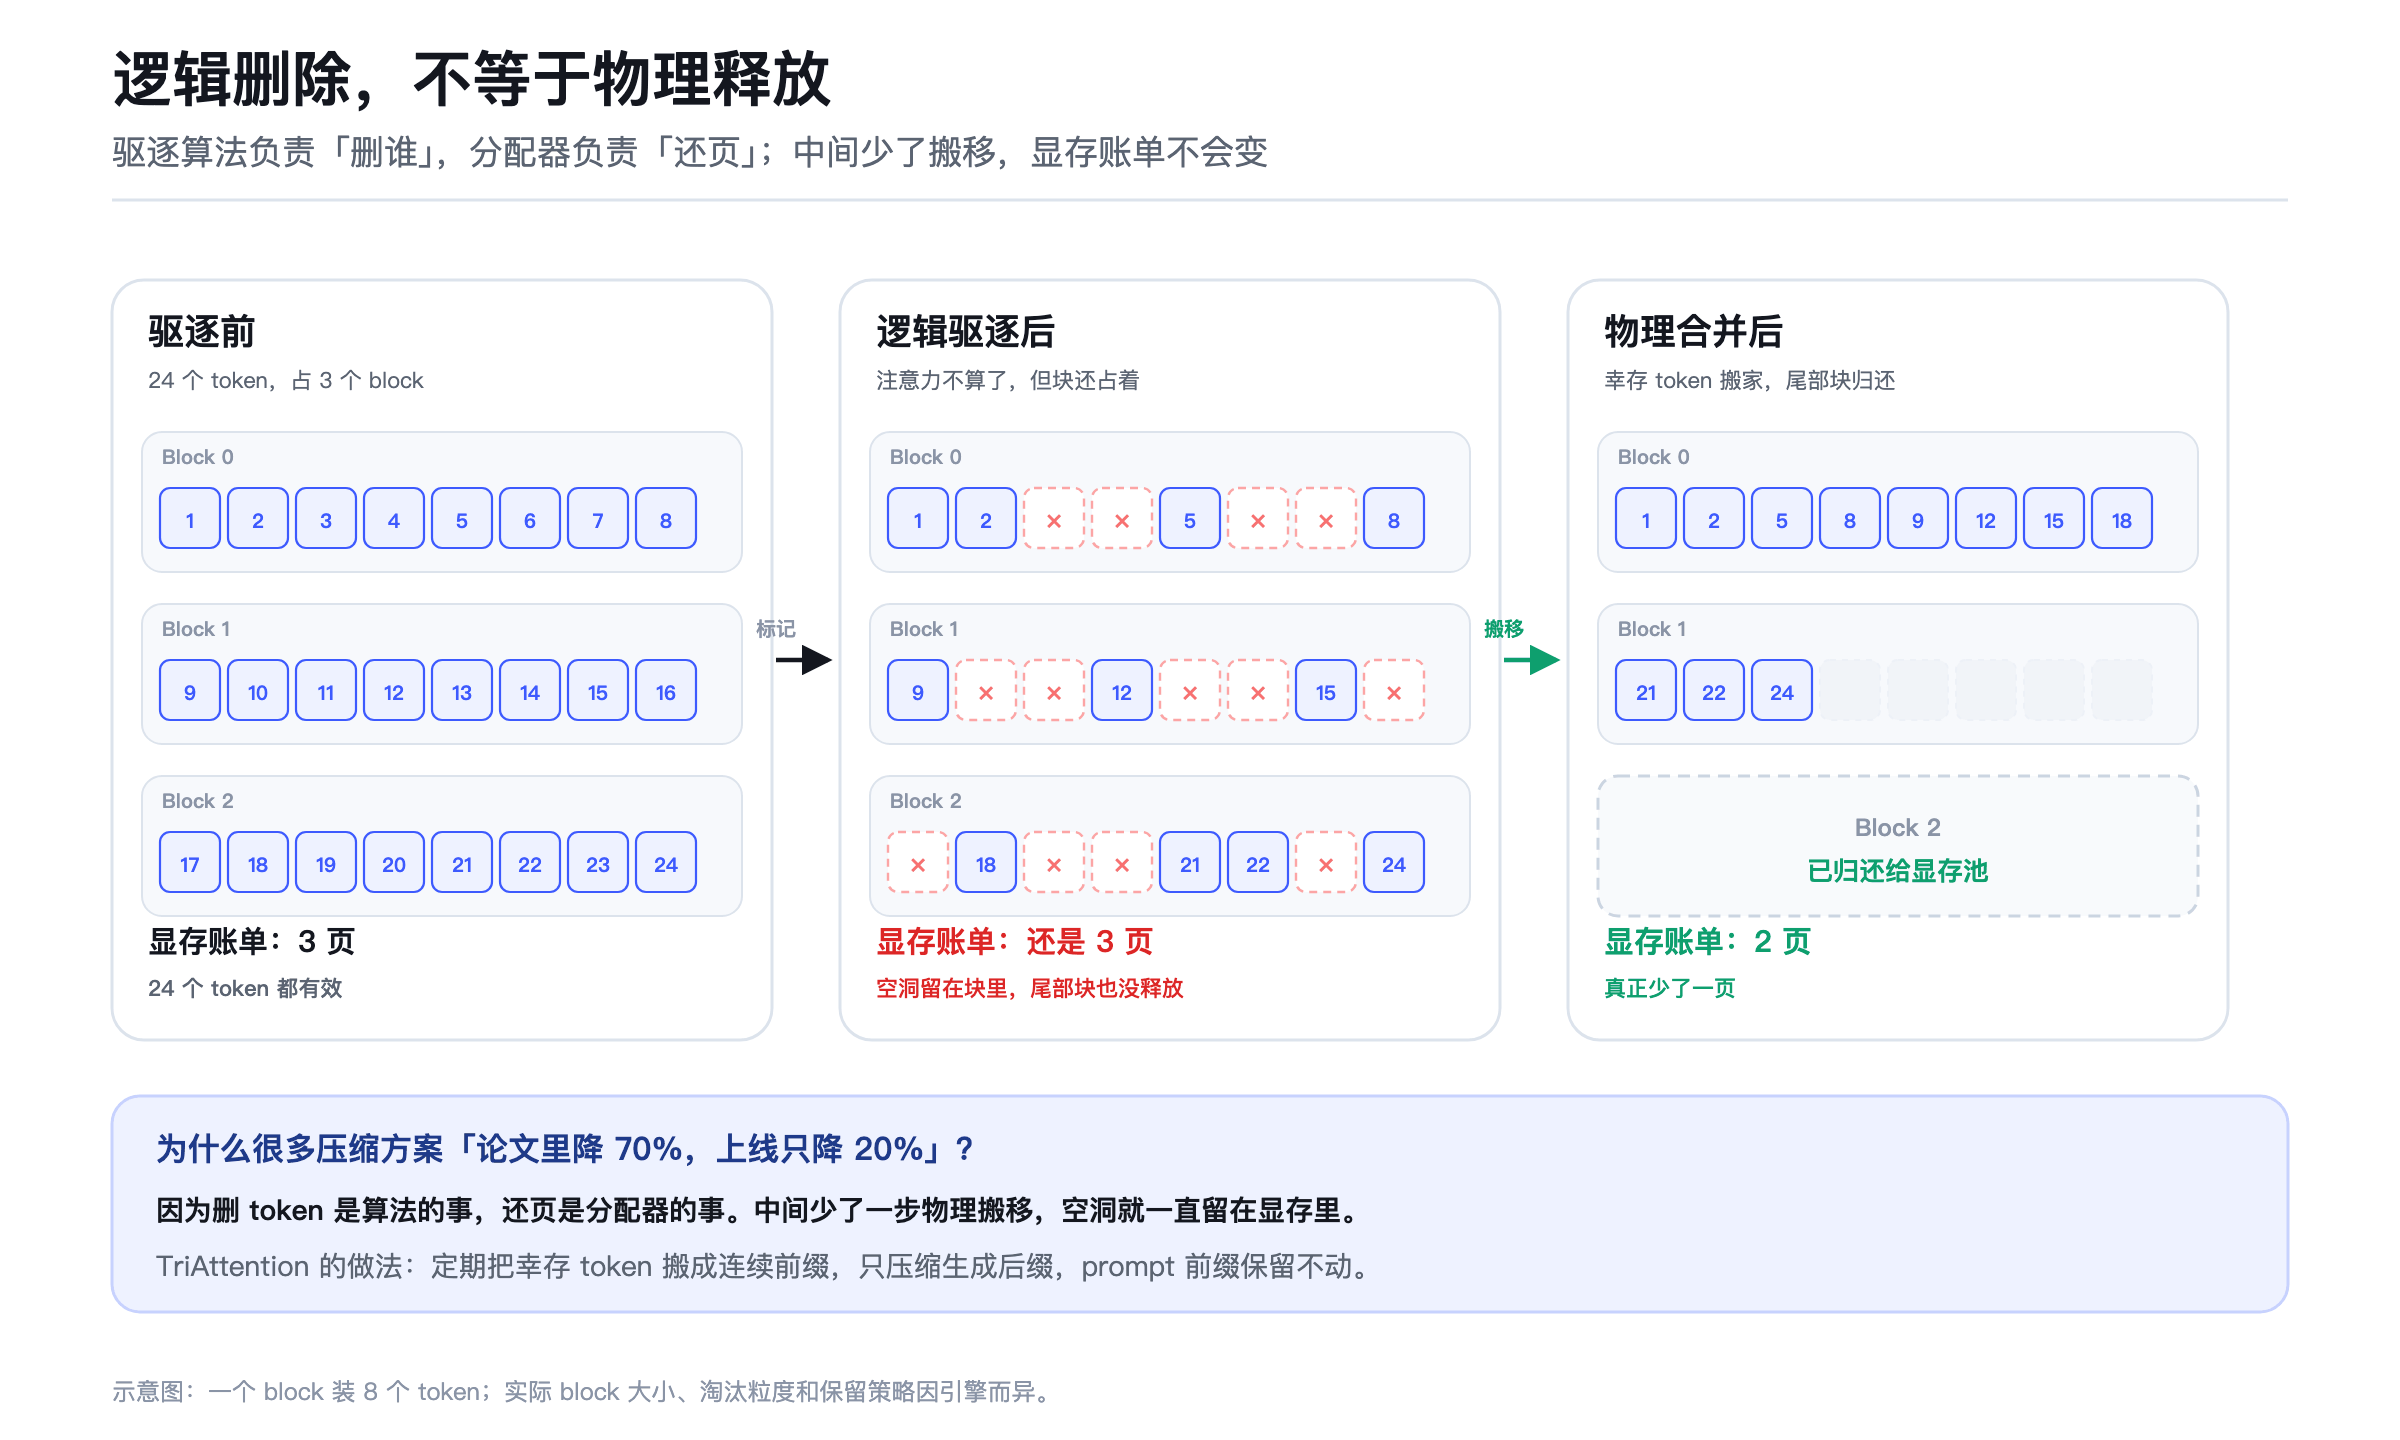
这张图值得停一下:压缩不只是算法问题,还是内存管理问题。算法和分配器不协同,收益会大打折扣。
误差会叠,而且不听话
量化一层、稀疏一层、驱逐一层、跨层复用一层,每项都宣称“精度损失不到 1%”。但损失不是线性叠加的,长上下文召回、多轮指代、工具调用这些能力,可能在某个组合下突然塌掉。
举个具体的:128K 文档里,某个关键数字只在开头出现一次。量化把它压糊了,稀疏又没选中它,最后模型答得一本正经,但数字是错的。这类失败在长上下文评测里并不少见。
所以别只看 PPL(困惑度)。PPL 没涨,不代表 128K 文档里的那根针还能捞出来。端到端的长上下文评测,比任何单项指标都重要。
扔掉的 token,可能还会被问到
token 被扔了就是扔了。后面用户突然问起前面某一轮的内容,模型要么重新算(如果原文还在),要么只能根据残留信息编。多轮对话、Agent 长任务里,“前面说过、后面又问”太常见了。
驱逐策略本质上是在赌“未来不会用到”。你赌它用不上,它偏偏可能用得上。生产环境里,这个赌注要留余量。
回迁也会堵车
分层存储听起来很美:冷数据下沉,热数据回迁。但回迁要走 PCIe、要走网络,和正常访存抢带宽。长上下文高并发时,一堆请求同时回迁,时延毛刺可能比不用池化还难看。
所以分层缓存的关键不是“层数多”,而是预取要准、回迁要限速,不然越池化越抖。
另外两个矛盾,做全局池化时一定会遇到:块切得越细,共享越灵活,但元数据和碎片越多;切得越粗,管理越简单,前缀匹配的粒度越差。还有格式,vLLM、SGLang、TensorRT-LLM 的 KV 布局和量化格式并不通用,跨引擎共享往往要做一次转换,转换本身又有时延。
我会怎么选
如果只让我给一条建议:先把“免费”的收益拿干净。
选模型时优先 GQA/MLA;推理侧把 FP8 KV、PagedAttention、前缀缓存、前缀感知路由用起来。这几项成熟、风险低、上线快。等这些吃透了,再考虑稀疏、驱逐、分层这些“动结构”的手段。
经常有人一上来就问 2-bit 能省多少。我的建议是,先把分页和前缀缓存的浪费清掉,再谈压缩。用 vLLM/SGLang 的话,prefix caching 先打开,很多时候比换量化格式更立竿见影。
按场景,我大概是这么排的:
- 通用在线推理:GQA/MLA + FP8/FP4 KV + PagedAttention + 前缀缓存 + 前缀感知路由。先拿这几项,别急着上 2-bit。
- 长上下文:再加稀疏注意力、分层驱逐(保留 attention sink)、CPU/NVMe 下沉。只靠量化硬扛,扛不住。
- 高并发短请求:重点在分页、前缀共享、Chunked Prefill。压缩收益有限,别过度设计。
- Agent/多轮:核心是全局 KV 池、跨实例复用、和长期记忆打通。命中率比压缩率重要。
- 极致成本:模型结构级压缩(CSA2 类,需自研)+ 2~3 bit + NVMe 池化。精度和工程复杂度,得认。
最后聊两句趋势
以前 KV Cache 是推理引擎内部的一个实现细节。现在不太一样了。
模型侧,MLA、CSA2、DSA 这些设计,是在结构阶段就把 KV 预算算进去;系统侧,Mooncake、LMCache、CXL 内存池、NVMe-oF、DPU 卸载,是在把 KV 变成一种可以独立存储、独立调度、独立计费的数据。两头一夹,KV 不再只是“缓存”,而是和模型权重并列的一份数据资产。
2026 年能看到的一个变化是,模型结构级压缩和超低比特量化开始合流。以前是“模型定好了,再想办法压 KV”;现在是“设计模型的时候,就把 KV 预算算进去”。DeepSeek 从 V1 的约 389KB/token 到 V4.1-Flash 的 890B/token,437 倍不是靠一个技巧压出来的,是结构、精度、部署几层一起作用的结果。
对做推理系统的人来说,评价指标也得变。以前看吞吐、TTFT、TPOT;以后还得看 KV 命中率、分层命中分布、回迁时延、每 token 的 KV 成本。谁能把 KV 管好,谁就能把长上下文的价格打下来。
下次再遇到 GPU 利用率上不去,先别急着加卡。打开 profiler,看看 KV 占了多少显存、每一步搬了多少数据。很多时候,省下来的就是一张卡的钱。
参考
- DeepSeek-V4.1-Flash 技术报告;
- 深度剖析 DeepSeek-V4.1-Flash
- vLLM / PagedAttention
- SGLang / RadixAttention
- Mooncake
- KIVI
- H2O
- StreamingLLM
- TriAttention
- LMCache